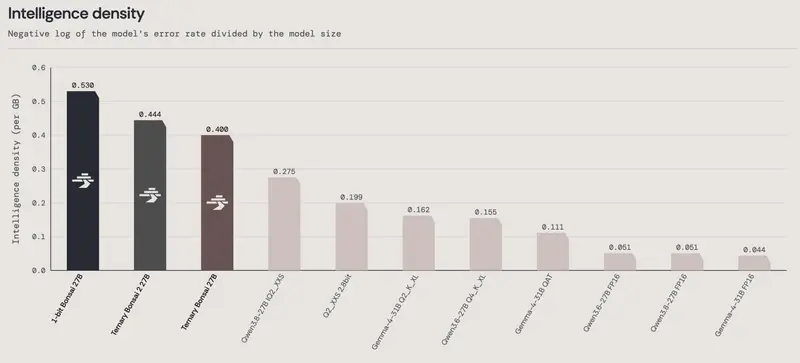
仅 5.9GB!PrismML 发布 Bonsai 2 27B,将 Qwen3.8 27B 压缩 9 倍,保留 98.2% 性能加州理工学院背景的初创公司 PrismML 正式发布了其最新的微型大语言模型 Ternary Bonsai 2 27B。该模型基于阿里巴巴的 Qwen3.8 27B,通过独特的“三值权重”压缩技术,将...大语言模型# Bonsai 2 27B# PrismML# Qwen3.8-27B1个月前700
阿里发布 Qwen3.8-Omni-Flash:百万上下文全模态模型,主打代理式音视频理解阿里巴巴通义千问团队正式发布了 Qwen3.8-Omni-Flash,号称业界首个围绕 Agent(智能体)能力 构建的全模态模型。该模型能够同时理解文本、图像、音频和视频,并通过内置的推理与工具使用...多模态模型早报# Qwen3.8-Omni-Flash# 通义千问1个月前800
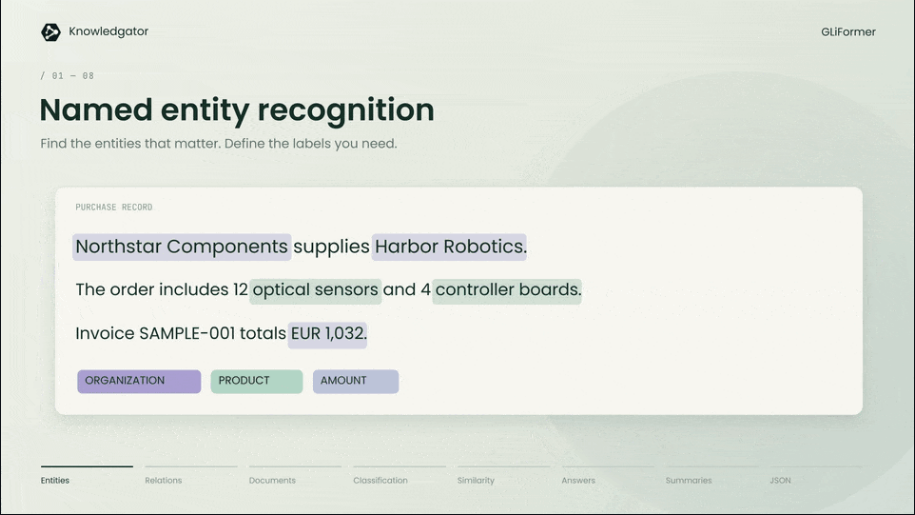
Knowledgator 发布 GLiFormer:5.75 亿参数编码器,不生成令牌实现嵌套 JSON 提取,F1 达 91.10Knowledgator Engineering 正式发布了 GLiFormer,一款基于模式条件编码器(Schema-Conditioned Encoder)框架的信息提取模型。与依赖逐 Token...大语言模型# GLiFormer# Knowledgator1个月前660
Nari Labs推出Nari Qwen3-TTS:基于 Qwen3-TTS 1.7B 定制的高性能 TTS 推理服务Nari AI 正式推出了 Nari Qwen3-TTS,一款基于阿里云 Qwen3-TTS 1.7B 模型的高性能文本转语音(TTS)服务。通过自研的专用推理引擎,Nari 在单张英伟达H100 S...早报语音模型# Nari Qwen3-TTS1个月前550
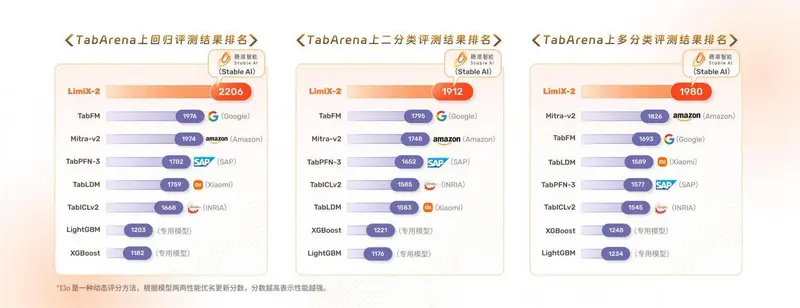
LimiX-2 发布:稳准智能联合清华大学推出 400M 参数表格基础模型,霸榜国际主流基准9 月 16 日,稳准智能联合清华大学计算机系崔鹏教授团队正式发布新一代数据大模型 LimiX-2。该模型将参数规模提升至 400M,并在 TabArena、BCCO、TALENT 三个国际主流结构化...大语言模型# LimiX-2# 表格基础模型1个月前780
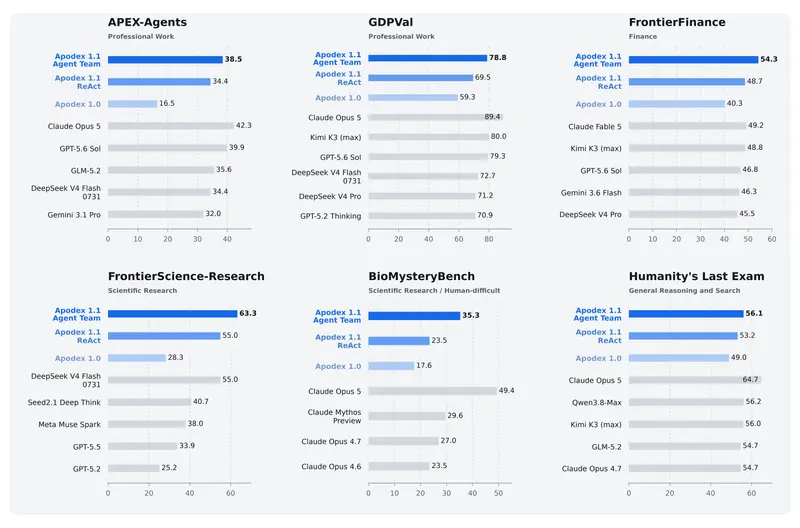
Apodex 推出 Apodex v1.1 模型:能读写文件、跑代码的 AI 代理,基准性能较 v1.0 翻倍Apodex 正式发布了其新一代模型家族 Apodex 1.1,标志着其核心能力从简单的信息检索(Deep Research)向复杂的文件处理与代码执行(Deep Discover)跨越。与上一代仅返...大语言模型# Apodex# Apodex 1.11个月前750
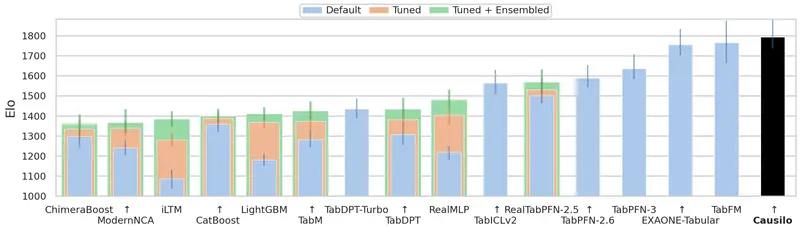
Causilo:Nums AI 发布的表格基础模型,TabArena 单一模型榜首Nums AI 正式发布了 Causilo,一款专为分类和回归任务设计的预训练表格基础模型。凭借其创新的上下文学习架构,Causilo 在权威基准测试 TabArena 中取得了单一模型(Single...大语言模型早报# Causilo# Nums AI# 表格基础模型1个月前770
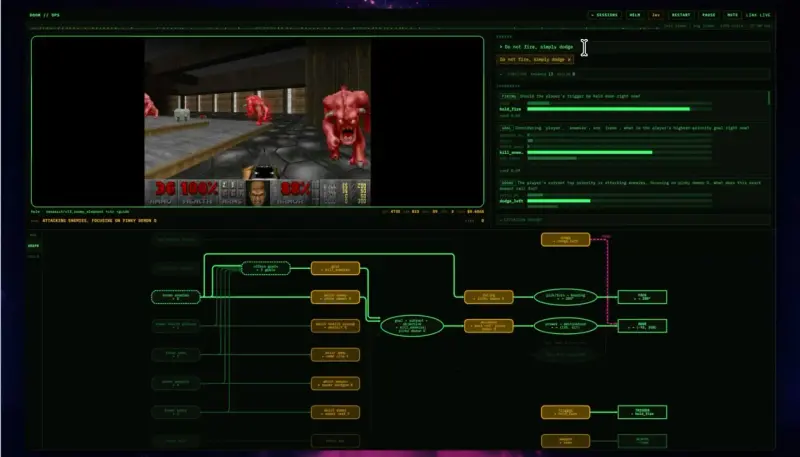
不聊天、不生成文字!前 OpenAI 研究员推出 Jev 模型,专门给软件做概率决策前 OpenAI 研究员、RLHF(人类反馈强化学习)共同发明人 Diogo Almeida 创立的 TypeSafe AI 正式发布了一款名为 Jev 的新型 AI 模型。 地址:https://t...大语言模型早报# Jev# OpenAI1个月前800
谷歌发布 Gemini 3.8 Live 系列:支持后台思考,边聊天边调用工具不打断对话谷歌正式推出了 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两款全新模型。这标志着语音交互 AI 从“简单的问答”迈向了“复杂的并行任务处理...早报语音模型# Gemini 3.8 Live# Gemini 3.8 Live Extended Thinking# 谷歌1个月前520
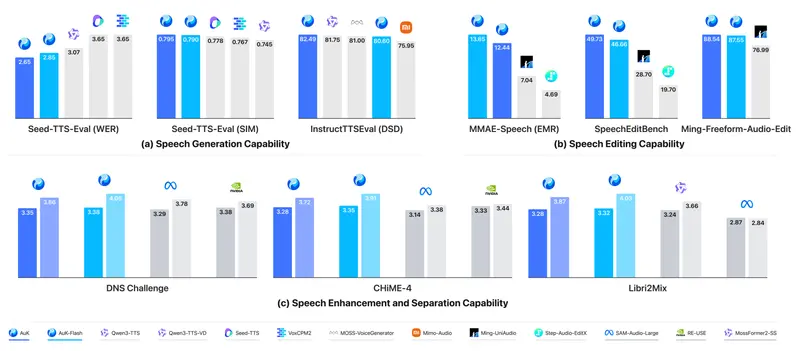
腾讯开源 AuK:单一大模型一站式搞定语音生成、音频编辑与人声分离在当前的 AI 音频领域,工具往往是割裂的:想配音用 TTS 模型,想降噪用增强模型,想分离人声又得换另一个软件。这种“工具箱”式的工作流不仅繁琐,还容易导致音色不统一、风格冲突。 腾讯最新开源的 A...语音模型# AuK# AuK-Flash# 腾讯1个月前1070
DiffSynth-Music:用“声音”指挥 AI 写歌,阿里与上交大推出插件式可控音乐生成框架现在的 AI 音乐工具大多依赖文字描述(如“悲伤的钢琴曲”),但文字很难精准传达节奏的快慢、旋律的起伏或乐器的具体编排。如果你想复刻某段鼓点,或者沿用一段哼唱的旋律,打字往往词不达意。 阿里巴巴通义实...语音模型# ACE-Step 1.5# DiffSynth-Music1个月前790
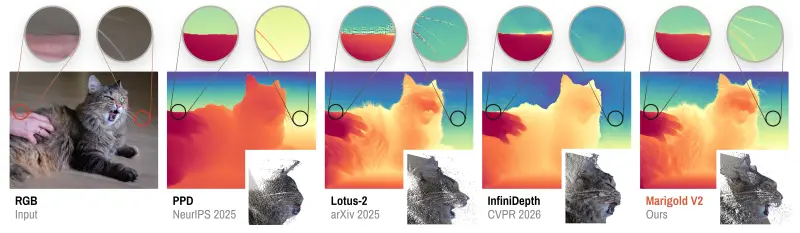
华为拜耳实验室发布Marigold V2:单卡几天训练,让 AI 看清“每一根发丝”的深度在计算机视觉领域,单目深度估计(Monocular Depth Estimation) 一直是个既基础又棘手的难题。它的目标很简单:只凭一张普通的二维彩色照片,推算出画面中每个像素点距离镜头的远近,生...图像模型# Marigold V2# 华为拜耳实验室1个月前1160