新Bland 发布 Tofu-1:首个全双工语音到语音模型,实现无转录实时通话与噪声环境下的精准交互旧金山语音 AI 初创公司 Bland 正式发布了 Tofu-1,这是其计划中的语音到语音模型系列的首个研究预览版。与传统的级联式语音智能体不同,Tofu-1 采用端到端架构,直接处理音频输入并生成音...语音模型# Bland# Tofu-123小时前50
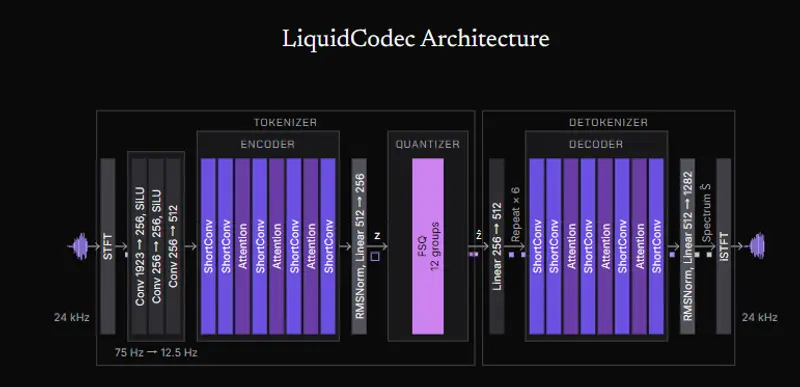
新Liquid AI 发布 LiquidCodec:7400 万参数流式编解码器,CPU 单核实现 361 倍实时编码Liquid AI 正式推出 LiquidCodec,一款专为流式语音处理设计的轻量级音频编解码器。作为其 LFM3-Audio-2B 和 LFM3-Omni-2B 模型的核心组件,LiquidCod...语音模型# Liquid AI# LiquidCodec3天前110
Fish Audio 推出全双工语音模型Live 3,最短 186 毫秒响应,原生学习对话轮次时机Fish Audio 正式推出 Live 3,一款专为实时语音智能体设计的全双工(Full-Duplex)语音模型。与传统的半双工系统不同,Live 3 能够在说话的同时保持聆听状态,允许用户在通话过...早报语音模型# Fish Audio# Live 35天前190
Zyphra 开源 ZONOS3-Mini:800M 总参 MoE TTS,仅 100M 激活参数,支持词级表达控制Zyphra 正式发布了 ZONOS3-Mini,一款专为本地设备实时推理设计的开源文本转语音(TTS)模型。该模型采用稀疏混合专家(MoE)架构,总参数量 8 亿,但在每次推理时仅激活约 1 亿参数...语音模型# ZONOS3-Mini# Zyphra6天前180
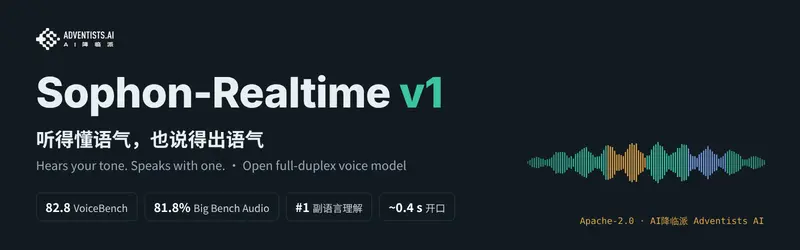
AI 降临派开源Sophon-Realtime v1 :32B 全双工语音模型,听懂语气、自主生成笑 / 叹气等副语言AI降临派(Adventists AI)正式推出 Sophon-Realtime v1,这是一个基于 Apache-2.0 协议开源的全双工语音模型系列。该模型旨在提供拟真的实时语音交互体验:在用户说...语音模型# AI 降临派# Sophon-Realtime v1# 全双工语音模型7天前310
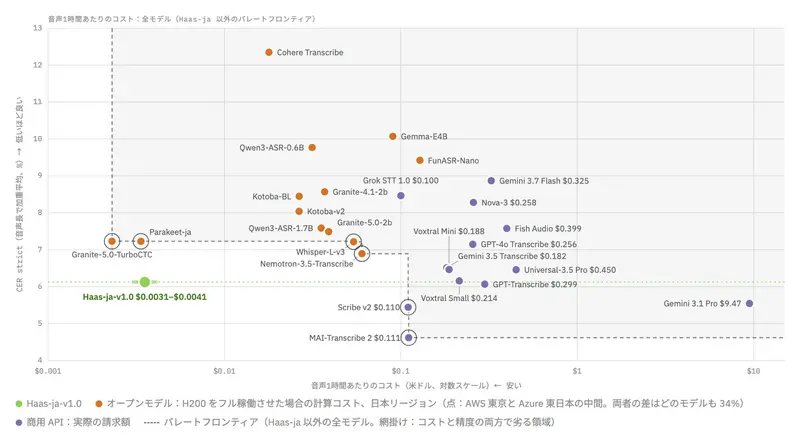
Third Intelligence 发布 Haas-ja-v1.0:基于 Parakeet-TDT 架构的高精度日语语音识别开放模型日本 Third Intelligence 近期发布了日语语音识别模型 Haas-ja-v1.0,并将其作为开放模型公开。该模型的开发旨在推动普及型 AGI 的落地,促进 AI 与人类建立信任关系并实...语音模型# Haas-ja-v1.0# Third Intelligence1周前250
清华开源音视频说话人提取模型Falcon:靠视觉定向听音,低延迟接入腾讯会议清华团队近期开源了因果音视频目标说话人提取(Audio-Visual Target Speaker Extraction, AVTSE)模型 Falcon。该模型能够在多说话人的嘈杂环境中,实时提取指...语音模型# Falcon1周前260
PiVo:全套仅 140 万参数英文 TTS,含声码器,ONNX+CPU 离线推理,无重型框架依赖Empero AI 推出科研向轻量英文语音合成模型 PiVo,核心目标探索一套完整 TTS(文本→波形,声学模型 + 声码器全部计入)的参数下限。整套可学习参数合计仅 140 万,对比作为教师模型的 ...语音模型# Empero AI# PiVo# PiVo-1.4M2周前400
模思智能发布 MOSS-Live:全双工实时语音 AI,边说边听、支持后台异步任务与多模态感知模思智能推出 MOSS-Live,一套全双工实时语音交互系统,核心特性是可以同时聆听、语音输出、执行任务,告别传统语音助手 “一问一答、轮流收发” 的对讲机模式,更接近真人通话体验。 项目主页:htt...早报语音模型# MOSS-Live# 全双工实时语音交互# 模思智能2周前580
英伟达发布 NemotronLabs RE-USE-laughter:960 万参数多语言语音增强模型,专门保留笑声英伟达推出了 NemotronLabs RE-USE-laughter,这是一款参数量仅为 960 万(9.6M)的多语言通用语音增强(Universal Speech Enhancement, US...语音模型# NemotronLabs RE-USE-laughter# 英伟达2周前280
Edge0开源Audio8-TTS-Realistic :0.6B 双自回归 TTS,23 语种零样本克隆,Apache2.0 许可Edge0 近期正式发布了 Audio8-TTS-Realistic,这是一款参数量为 0.6B 的开放权重文本转语音(TTS)模型。该模型专为零样本语音克隆设计,仅需提供一个参考音频片段及其对应的转...语音模型# Audio8-TTS-Realistic# Audio8-TTS-Realistic-Air# edge02周前330
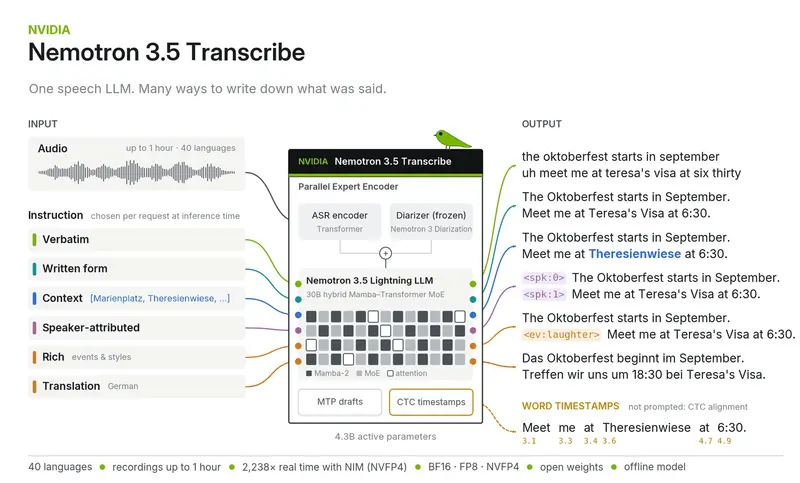
英伟达发布Nemotron 3.5 Transcribe:单模型一站式语音转录+翻译+说话人分群,支持端侧到数据中心全部署英伟达最新发布 Nemotron 3.5 Transcribe,一款开放权重的语音增强语言模型(SALM)。和传统语音系统把语音检测、转写、说话人区分、翻译拆成多个模型串联运行不一样,它在单次前向推理...语音模型# Nemotron 3.5 Transcribe# 英伟达3周前380