Google DeepMind 发布 AlphaGenome 2:支持单细胞状态条件化的 DNA 功能预测模型,因果变异召回率提升至 30%Google DeepMind 正式推出 AlphaGenome 2,一款能够预测特定细胞类型中遗传变异效应的 DNA 基础模型。与此前在批量组织数据上进行平均的前代模型不同,AlphaGenome ...多模态模型# AlphaGenome 2# Google DeepMind4天前180
Anthropic 发布 Claude Fable 5.2 / Mythos 5.2:旗舰双模型,全维度超越 Opus 5.5、降价提速11 月 9 日,Anthropic 正式推出 Claude Fable 5.2 与 Claude Mythos 5.2。作为其产品线中定位最高端的模型系列,新版本在编码、推理、视觉及科学计算等领域均...多模态模型早报# Anthropic# Claude Fable 5.2# Claude Mythos 5.21周前270
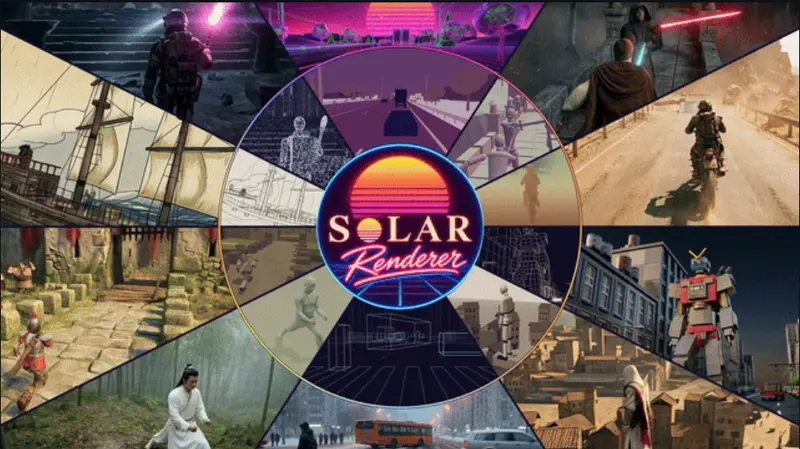
SolarRenderer:4 步生成式蓝图渲染框架,一套模型兼容简笔画 / 骨骼 / 线框等各类结构蓝图在游戏开发、影视预演及 AI 智能体内容创作中,创作者通常已提前规划好场景布局、物体摆放、人物动作轨迹及镜头运动。这些规划通常以结构蓝图的形式存在,如线框图、骨骼动作数据或灰度方块布局图,仅记录位置与...多模态模型# SolarRenderer1周前320
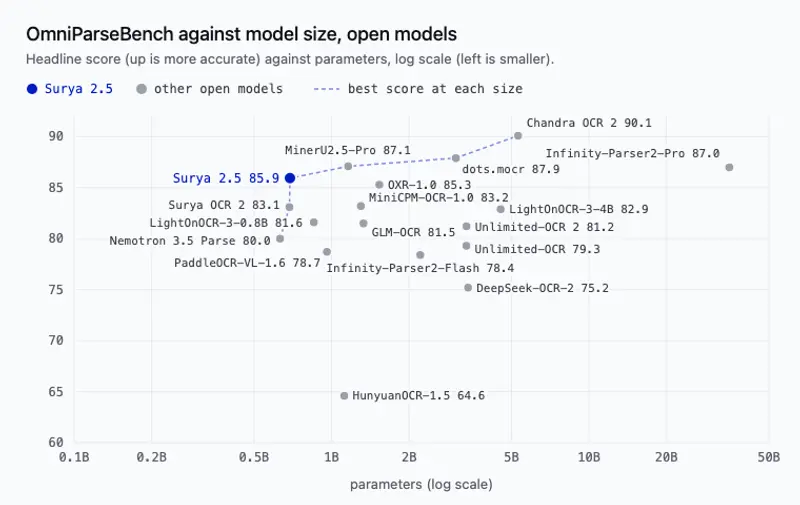
Datalab 推出Surya 2.5:0.7B级轻量化OCR,支持表格HTML还原、数学公式,1B以下基准第一Datalab 推出 Surya 2.5,一款仅689M参数的开源文档OCR模型,主打轻量化下的强版面理解能力,是当前1B参数以内梯队里性能领先的文档智能模型。 模型:https://huggingf...多模态模型# Datalab# OCR模型# Surya 2.51周前340
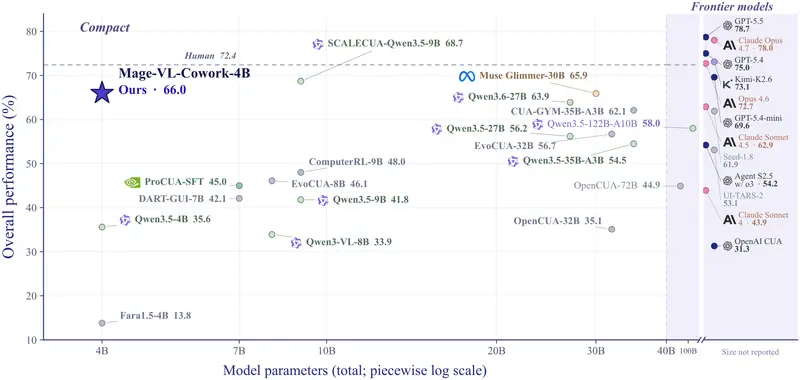
微软发布 Mage-VL-Cowork:4B 混合计算机使用智能体,自主切换 GUI 点击与 Bash 代码微软 Mage 团队近期发布了 Mage-VL-Cowork,这是一款参数量为 4B 的混合计算机使用智能体(Computer Use Agent, CUA)。该模型旨在解决当前 CUA 领域的两个核...多模态模型# Mage-VL-Cowork# 微软1周前310
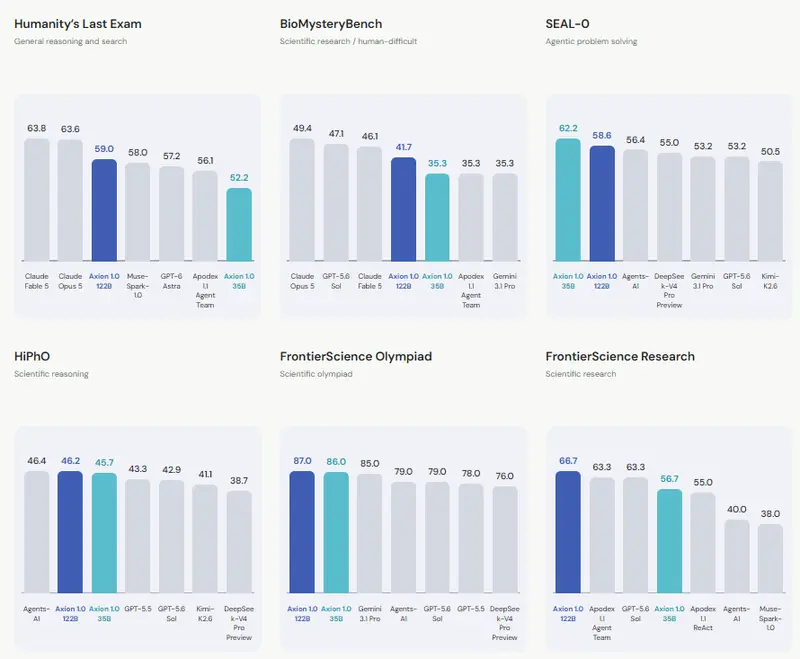
字节跳动发布开放智能体模型 Axion 1.0 :极简两阶段 SFT+RL,主打科学推理与工具调用字节跳动近期发布了 Axion 1.0,这是一款完全开放的智能体基础模型。该模型的核心设计理念在于“将复杂性放在学习问题中”,即通过构建具有挑战性的科学问题和带有可验证答案的工具依赖任务来驱动模型学习...多模态模型# Axion 1.0# 字节跳动1周前300
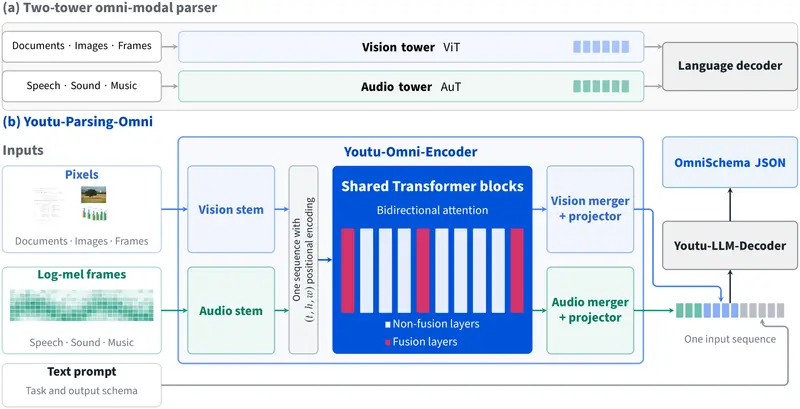
腾讯 Youtu-Parsing-Omni:5B 统一全模态解析模型,文档 / 图 / 音视频一键输出结构化 JSON腾讯发布了 Youtu-Parsing-Omni,这是一款参数规模为 5B 的全模态解析模型。该模型的核心能力在于,能够通过单一的输入接口处理文档页面、自然图像、图表、几何图形、音频片段以及音视频流...多模态模型# Youtu-Parsing-Omni# 腾讯1周前240
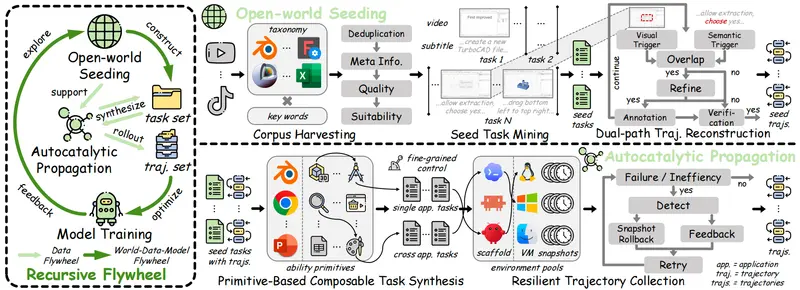
港中文、清华等联合推出CUA-Master:双环递归飞轮,27B小参数计算机使用智能体,对标超大闭源模型由香港中文大学 MMLab、清华大学、香港科技大学(广州)及京东探索研究院联合研发的 CUA-Master-27B 计算机使用智能体(Computer Use Agent, CUA)正式发布。 项目主...多模态模型# CUA-Master# CUA-Master-27B# Qwen-3.5-27B1周前250
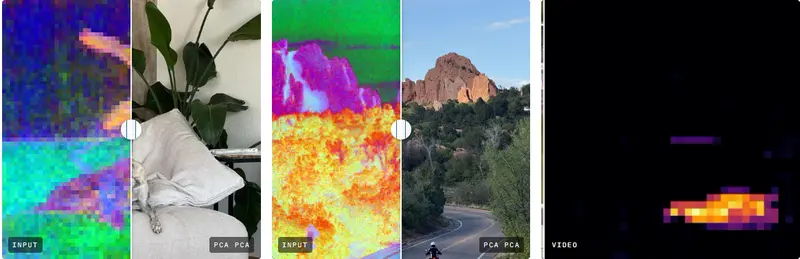
LeVJEPA:抛弃 EMA 与预测器,基于 SIGReg 正则的高效自监督视频预训练编码器LeVJEPA 是首个基于 LeJEPA 无崩溃目标训练的视频自监督编码器,核心创新是不再依赖 EMA 目标编码器、停止梯度、预测器、像素重建解码器这些传统手段来规避表征崩溃,依靠 SIGReg(Sk...多模态模型# LeVJEPA# LeVJEPA-1.5-Large1周前240
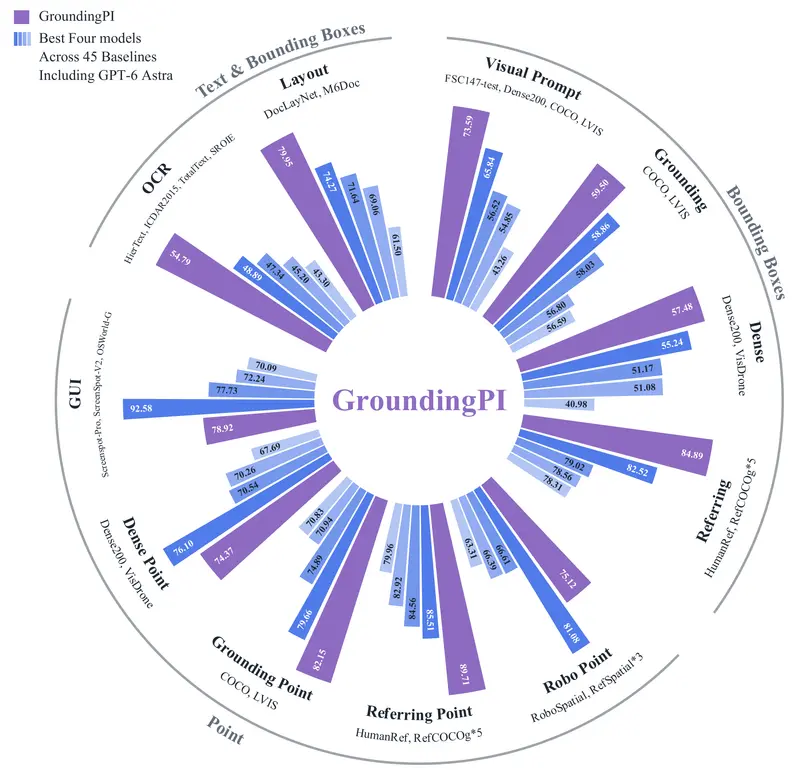
小鹏联合北大、港大发布具身感知基座 GroundingPI:40 亿参数,感知基准超越 GPT-6 Astra小鹏集团联合北京大学、香港大学等高校研究团队,正式发布了具身感知基座模型 GroundingPI。该模型以约 40 亿参数规模,首创“感知优先”的技术路线,在 34 项公开感知基准的综合评测中位列第一...多模态模型# GroundingPI# 北京大学# 小鹏2周前310
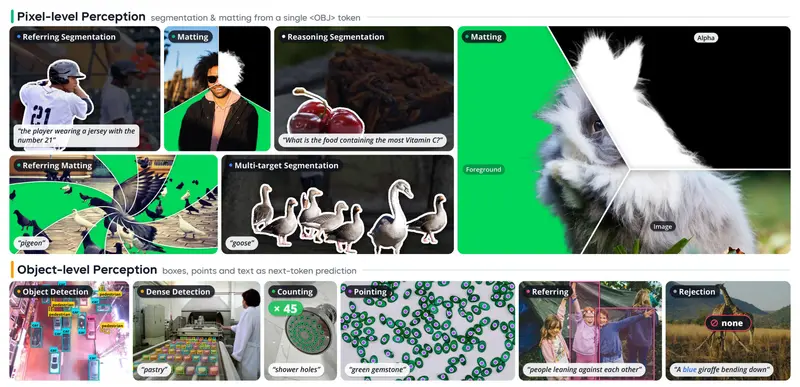
腾讯微信开源 WeVisOne-VL:统一视觉感知模型,检测 / OCR / 分割 / 抠图一模型搞定,9.6M 轻量像素解码器腾讯微信团队开源 WeVisOne-VL(WeChat Vision All-in-One),一款面向目标级 + 像素级任务一体化的视觉语言基础模型,主打一套模型承载多种视觉感知任务。它采用结构化 n...多模态模型# WeVisOne-VL# WeVisOne-VL-2B# WeVisOne-VL-4B2周前590
腾讯开源9B 长程工具智能体WeVisCut ,通过无硬编码状态机实现知识类长文端到端视频成片WeVisCut 是一款由腾讯开源的长程工具智能体(Long-horizon Tool Agent),专为将知识类长文或口播稿自动化转化为数分钟的高质量视频成片而设计。该项目采用 Apache-2.0...多模态模型# WeVisCut# 腾讯2周前570