SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    多模态模型

    共 311 篇文章
    百科工具模型ComfyUIAI合集web UI提示词
    大语言模型多模态模型图像模型语音模型3D模型Flux衍生视频模型世界模型决策模型
    排序
    发布更新浏览点赞
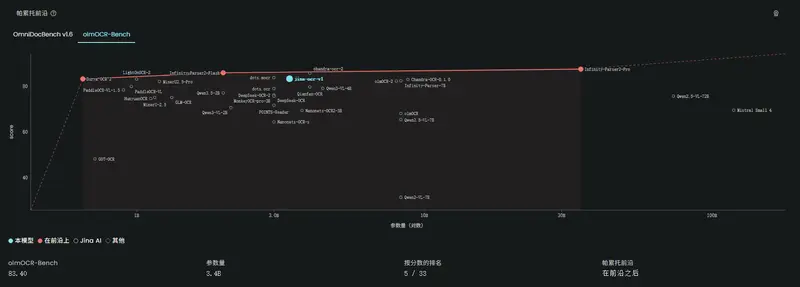
    Jina AI 发布 jina-ocr-v1:3.4B MoE 文档解析器,适配低预算 GPU,自带投机解码

    Jina AI 发布 jina-ocr-v1:3.4B MoE 文档解析器,适配低预算 GPU,自带投机解码

    Jina AI(Elastic 旗下)正式开源 jina-ocr-v1,一款端到端视觉文档解析模型。该模型总参数量为 3.4B,每个 token 仅激活约 570M 解码器参数,专为 NVIDIA L...
    多模态模型# Jina AI# jina-ocr-v1
    1个月前
    650
    阿里发布 Qwen3.8-Omni-Flash:百万上下文全模态模型,主打代理式音视频理解

    阿里发布 Qwen3.8-Omni-Flash:百万上下文全模态模型,主打代理式音视频理解

    阿里巴巴通义千问团队正式发布了 Qwen3.8-Omni-Flash,号称业界首个围绕 Agent(智能体)能力 构建的全模态模型。该模型能够同时理解文本、图像、音频和视频,并通过内置的推理与工具使用...
    多模态模型早报# Qwen3.8-Omni-Flash# 通义千问
    1个月前
    800
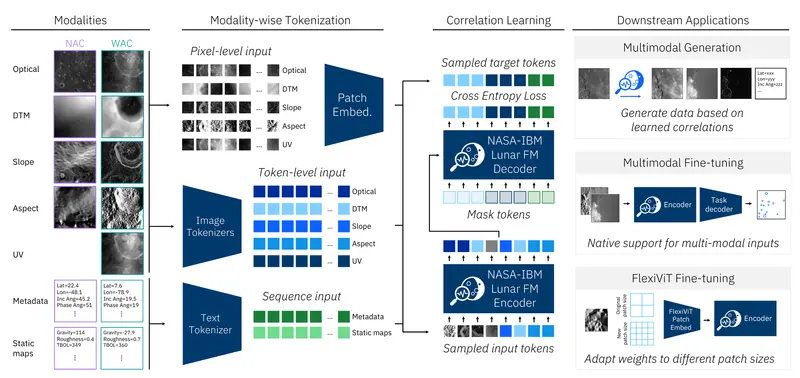
    NASA 联合 IBM 开源月球基础模型 LFM,多模态 AI 助力月球遥感科研

    NASA 联合 IBM 开源月球基础模型 LFM,多模态 AI 助力月球遥感科研

    NASA 和 IBM 今日正式发布了一款专为月球遥感设计的多模态、多分辨率开源 AI 基础模型(NASA-IBM Lunar Foundation Model, LFM)。这是首个整合多种数据模态、不...
    多模态模型# IBM# LFM# NASA
    1个月前
    580
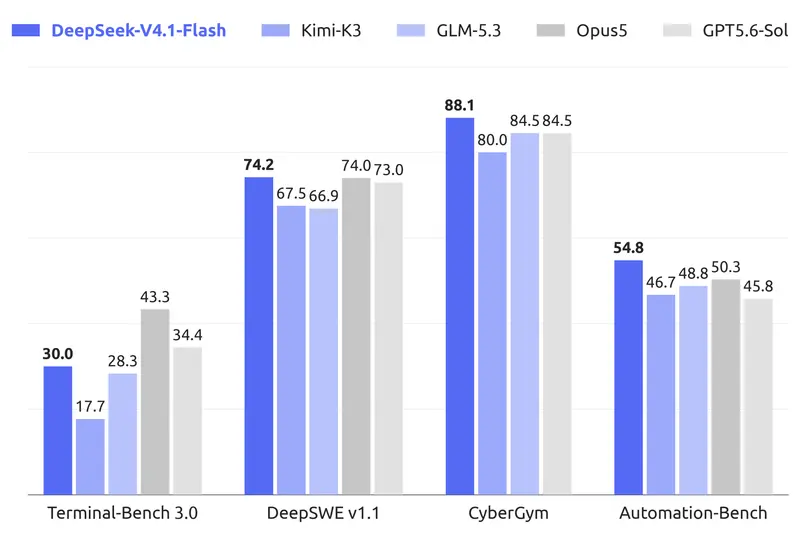
    深度求索发布DeepSeek-V4.1-Flash :百万上下文,KV缓存大幅压缩,代理任务性能暴涨

    深度求索发布DeepSeek-V4.1-Flash :百万上下文,KV缓存大幅压缩,代理任务性能暴涨

    随着AI智能体(Agent)的普及,大模型的工作模式正在发生改变。大量长周期任务带来海量输入,反复预填充、百万级上下文会持续占用KV缓存,对HBM显存、SSD存储以及带宽都带来巨大压力。 深度求索(D...
    多模态模型# DeepSeek V4.1 Flash# 深度求索
    2个月前
    1440
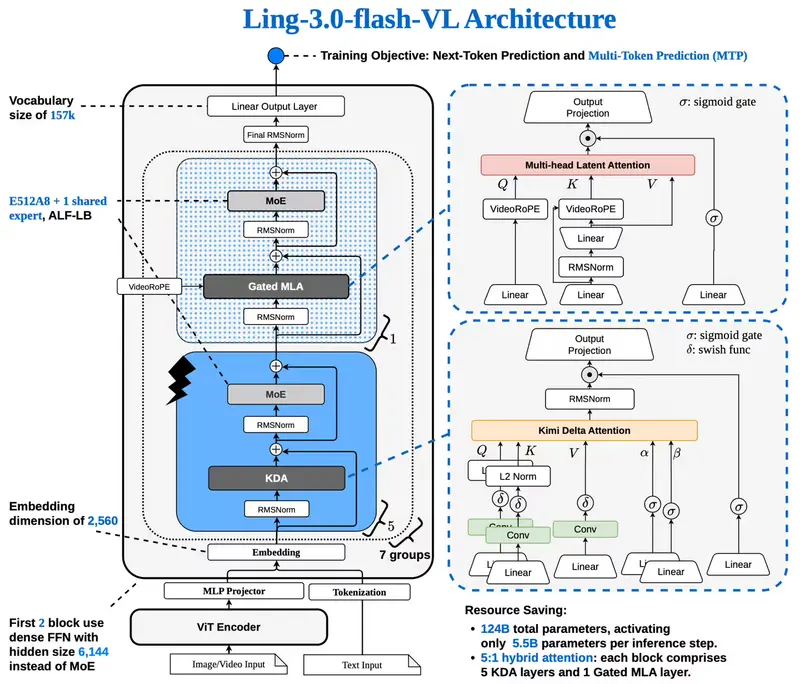
    蚂蚁开源百灵首个原生多模态大模型 Ling-3.0-flash-VL,搭载视觉反馈闭环,可自我修正GUI任务

    蚂蚁开源百灵首个原生多模态大模型 Ling-3.0-flash-VL,搭载视觉反馈闭环,可自我修正GUI任务

    蚂蚁集团正式发布并开源百灵(Ling)系列首款原生多模态大模型 Ling-3.0-flash-VL。模型在Ling-3.0-flash MoE混合专家底座上扩展而来,原生支持图、文、视频多模态输入,主...
    多模态模型# Ling-3.0-flash-VL# 蚂蚁集团
    2个月前
    890
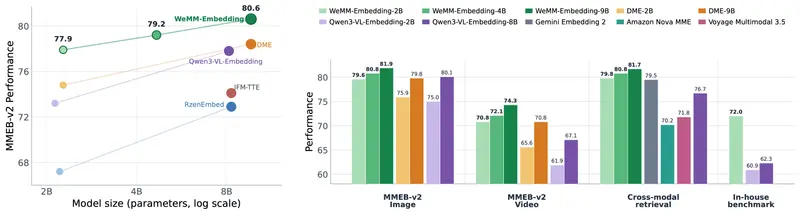
    微信视觉团队开源通用多模态向量模型家族WeMM‑Embedding:2B‑9B 全规格,经过微信真实业务大规模验证

    微信视觉团队开源通用多模态向量模型家族WeMM‑Embedding:2B‑9B 全规格,经过微信真实业务大规模验证

    腾讯微信视觉团队(WeChat Vision)正式开源了 WeMM-Embedding,这是一套包含 2B、4B、9B 三种规模的通用多模态 Embedding 模型家族。它旨在解决互联网内容形态日益...
    多模态模型# WeMM‑Embedding# 微信
    2个月前
    880
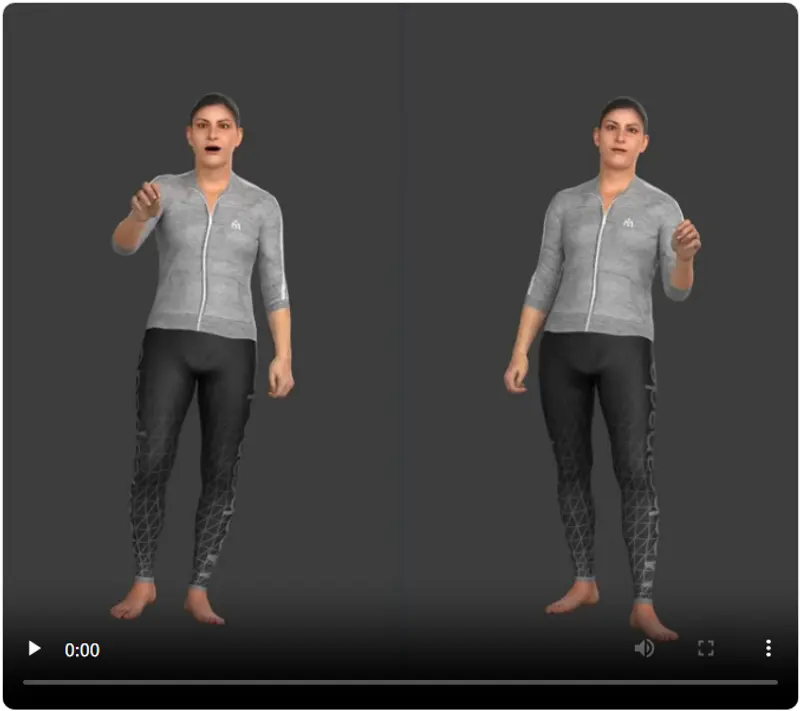
    北大发布端到端口语对话系统Motion-Omni:端到端生成语音与全身动作,让数字人告别“录播感”

    北大发布端到端口语对话系统Motion-Omni:端到端生成语音与全身动作,让数字人告别“录播感”

    北京大学研究团队最新发布的 Motion-Omni(参考实现为 Motion-Omni-Q7)是一个端到端口语对话系统。它打破了传统数字人“先生成语音、再驱动动作”的串联流水线模式,能够同时生成同步的...
    多模态模型# Motion-Omni
    2个月前
    750
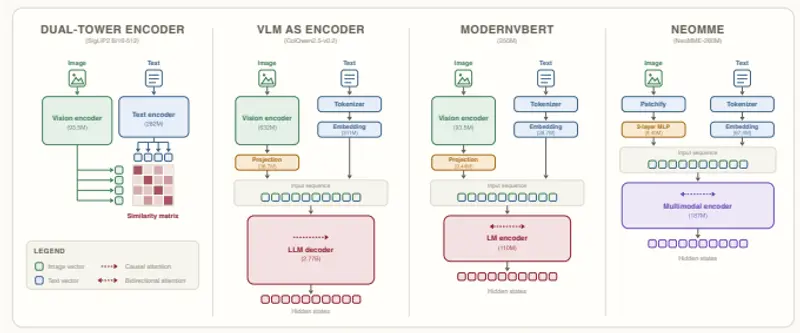
    H Company 发布NeoMME:单塔多模态编码器家族,抛弃视觉塔与解码器,轻量化文档检索新方案

    H Company 发布NeoMME:单塔多模态编码器家族,抛弃视觉塔与解码器,轻量化文档检索新方案

    H Company 正式发布了 NeoMME,这是一个包含 260M 和 800M 参数的双向多模态编码器家族。与当前主流的“二手”视觉文档检索器(如 ColPali,即复用生成式 VLM 的编码器部...
    多模态模型# H Company# NeoMME
    2个月前
    730
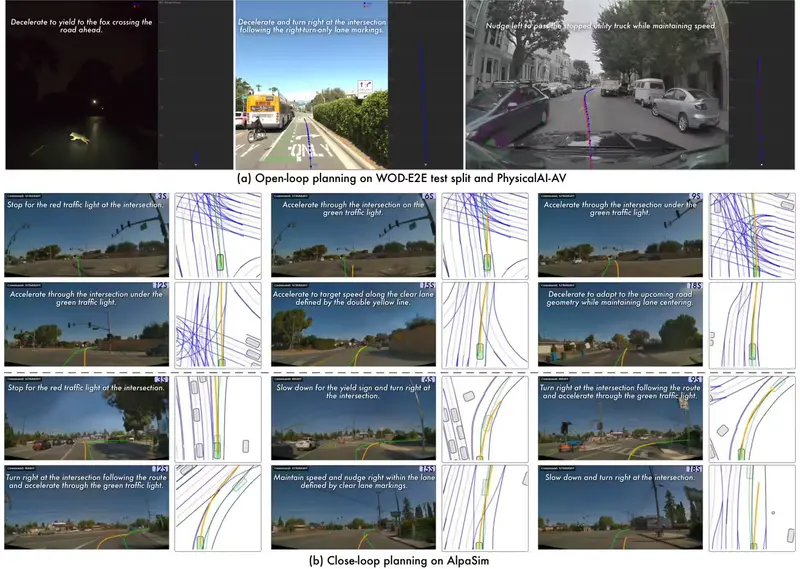
    阿里千问开源 Qwen‑Drive‑1.0‑4B,自动驾驶视觉语言基础模型正式开放

    阿里千问开源 Qwen‑Drive‑1.0‑4B,自动驾驶视觉语言基础模型正式开放

    阿里巴巴通义千问团队本周正式开源了 Qwen-Drive-1.0-4B,这是基于 Qwen3.5-4B 构建的、专为自动驾驶场景设计的视觉语言模型(VLM)。作为业界首个将 3D 感知、视觉问答与运动...
    多模态模型# Qwen-Drive-1.0-4B# 自动驾驶# 阿里巴巴
    2个月前
    780
    谷歌重磅连发双模型!Gemini 3.8 Flash + Cyber 上线,多项基准反超 GPT-5.6、Opus 5

    谷歌重磅连发双模型!Gemini 3.8 Flash + Cyber 上线,多项基准反超 GPT-5.6、Opus 5

    在 AI 模型迭代节奏持续提速的当下,谷歌再度刷新自家 Flash 系列更新速度。距离 Gemini 3.7 Flash 发布仅过去三周,短短六周时间内,谷歌完成第三次 Flash 版本迭代,正式推出...
    多模态模型早报# Gemini 3.8 Flash# Gemini 3.8 Flash Cyber# 谷歌
    2个月前
    1080
    编程登顶!阿里千问 Qwen3.8‑Max 推送0902新版本,前端编程拿下CodeArena全球第一

    编程登顶!阿里千问 Qwen3.8‑Max 推送0902新版本,前端编程拿下CodeArena全球第一

    阿里千问正式完成旗舰模型Qwen3.8‑Max迭代升级,推出0902新版。本次没有扩大模型参数规模,而是定向针对编程Coding、专业办公Cowork两大方向开展深度后训练优化,强化复杂工程任务、科研...
    多模态模型早报# Qwen3.8-Max-0902
    2个月前
    1160
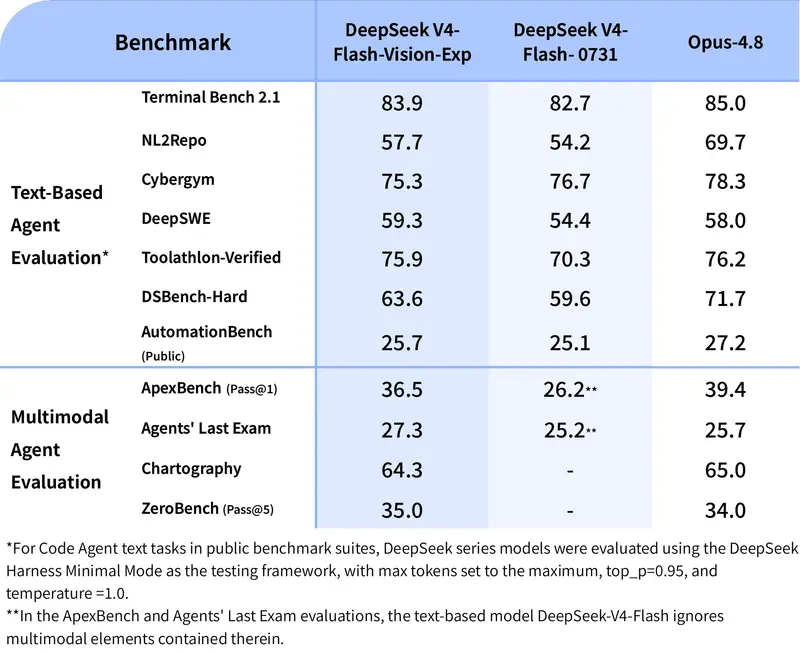
    DeepSeek‑V4‑Flash‑Vision‑Exp 开源上线,V4 系列首款多模态实验模型开放权重

    DeepSeek‑V4‑Flash‑Vision‑Exp 开源上线,V4 系列首款多模态实验模型开放权重

    2026 年 8 月 31 日,深度求索(DeepSeek)正式在 Hugging Face 开源了其 V4 系列的首个多模态实验版本——DeepSeek-V4-Flash-Vision-Exp。该模...
    多模态模型# DeepSeek‑V4‑Flash‑Vision‑Exp
    2个月前
    1430
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    BlitzBrowser

    BlitzBrowser

    BlitzBrowser是一款开源无头浏览器管理项目,核心价值在于将各类浏览器封装进Docker容器中,实现便捷的部署、运行与管理,支持本地或云端部署,同时兼容Chrome DevTools协议(CDP)。
    SentrySearch

    SentrySearch

    SentrySearch 将你的 mp4 视频分割成重叠的片段,使用 Google 的 Gemini Embedding API 或本地的 Qwen3-VL 模型将每个片段嵌入为视频,并将向量存储在本地 ChromaDB 数据库中。当你搜索时,你的文本查询被嵌入到同一向量空间中,并与存储的视频嵌入进行匹配。最佳匹配会自动从原始文件中裁剪出来,并保存为一个片段。
    海绵音乐

    海绵音乐

    海绵音乐是由字节跳动最新推出的免费AI音乐创作和分享平台。它旨在利用AI技术生成个性化音乐,让用户能够轻松创作出符合自己风格的音乐作品。
    Adobe Firefly Video

    Adobe Firefly Video

    由 Firefly 视频模型支持,创意专业人士可以从文本提示或图像生成视频片段,控制镜头角度,创建专业质量的图像,并开发自定义运动设计元素。该功能支持 1080p 分辨率,并即将推出 4K 模型。
    WorkflowAI

    WorkflowAI

    WorkflowAI是一个开源平台,供产品和工程团队合作构建和迭代AI功能,可以并行测试和比较80多种领先的人工智能模型,并评估其质量、成本和速度。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      BlitzBrowser

      BlitzBrowser

      BlitzBrowser是一款开源无头浏览器管理项目,核心价值在于将各类浏览器封装进Docker容器中,实现便捷的部署、运行与管理,支持本地或云端部署,同时兼容Chrome DevTools协议(CDP)。
      SentrySearch

      SentrySearch

      SentrySearch 将你的 mp4 视频分割成重叠的片段,使用 Google 的 Gemini Embedding API 或本地的 Qwen3-VL 模型将每个片段嵌入为视频,并将向量存储在本地 ChromaDB 数据库中。当你搜索时,你的文本查询被嵌入到同一向量空间中,并与存储的视频嵌入进行匹配。最佳匹配会自动从原始文件中裁剪出来,并保存为一个片段。
      海绵音乐

      海绵音乐

      海绵音乐是由字节跳动最新推出的免费AI音乐创作和分享平台。它旨在利用AI技术生成个性化音乐,让用户能够轻松创作出符合自己风格的音乐作品。
      Adobe Firefly Video

      Adobe Firefly Video

      由 Firefly 视频模型支持,创意专业人士可以从文本提示或图像生成视频片段,控制镜头角度,创建专业质量的图像,并开发自定义运动设计元素。该功能支持 1080p 分辨率,并即将推出 4K 模型。
      WorkflowAI

      WorkflowAI

      WorkflowAI是一个开源平台,供产品和工程团队合作构建和迭代AI功能,可以并行测试和比较80多种领先的人工智能模型,并评估其质量、成本和速度。
      查看完整榜单