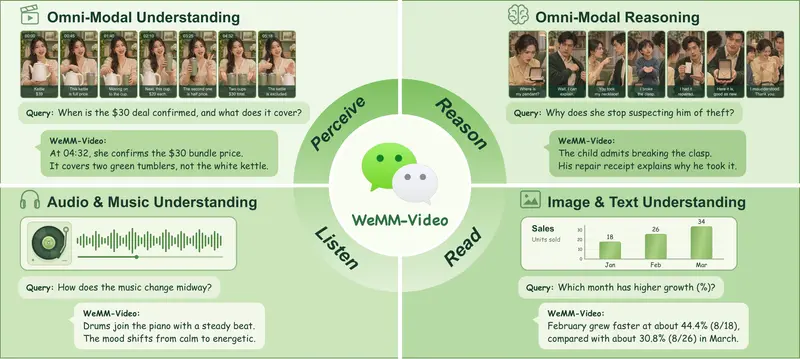
新微信视觉团队联合清华推出双语全模态视频理解模型WeMM‑Video,音画联合推理刷新 SOTA由微信视觉团队与清华大学研究者联合推出的 WeMM-Video 系列正式开源。这是一套面向中英双语的音画联合感知与推理基础模型,解决当前多模态 AI 在“音视频联合理解”上的核心痛点。 该系列提供 2...多模态模型# WeMM‑Video# 微信1天前80