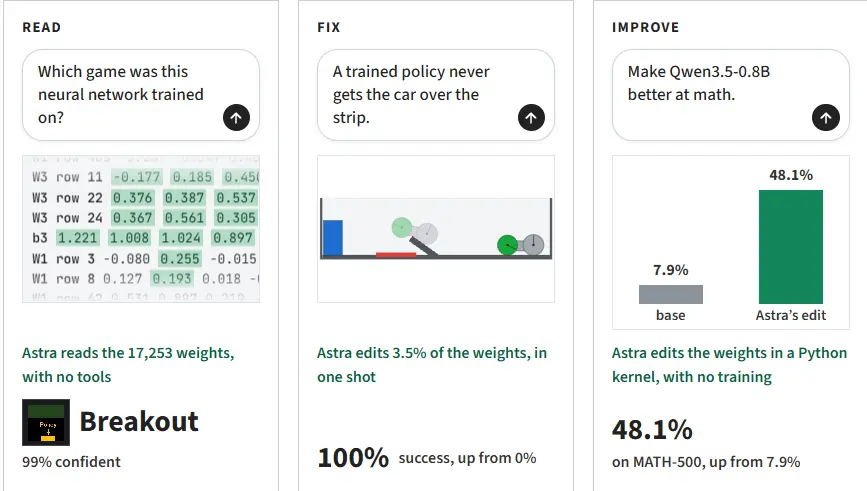
类比神经网络基因编辑:MIT 利用 GPT-6 Astra 直接编辑 Qwen 权重,大幅修复模型重复推理缺陷麻省理工学院(MIT)计算机科学与人工智能实验室(CSAIL)的研究团队近期提出了一种名为“权重空间编程”(Weight Space Programming)的新方法。该方法利用 OpenAI 的 G...新技术# 权重空间编程2周前350
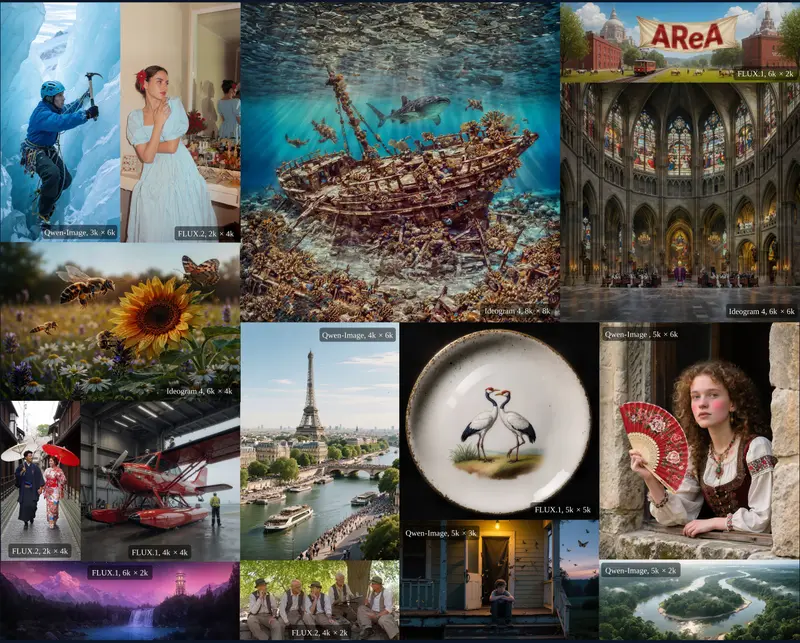
AReA:自适应感受野注意力,零训练推理增强,大幅加速FLUX超大图生成AReA(自适应感受野注意力)是多伦多大学提出的推理阶段外挂增强技术,无需对基础模型重新训练,面向基于扩散Transformer(DiT)架构的高清图像生成,解决原生模型直接生成远超训练分辨率大图时两...新技术# AReA# Flux.14周前590
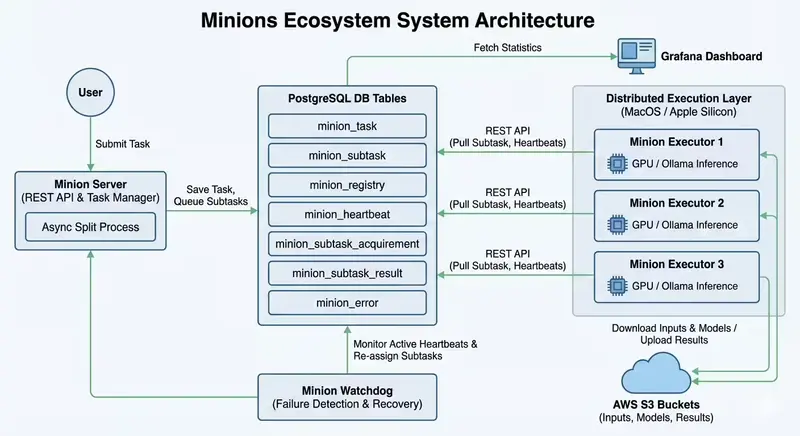
苹果发布Minions系统研究:聚合多台Mac闲置Apple Silicon GPU,组建虚拟GPU云跑AI推理苹果研究团队公开Minions系统研究,目标聚合局域网内多台Mac的闲置GPU资源,搭建可动态调度的虚拟GPU云,用来承载大规模机器学习推理任务,盘活企业办公场景里长期闲置的Apple Silicon...新技术# Minions# 苹果1个月前540
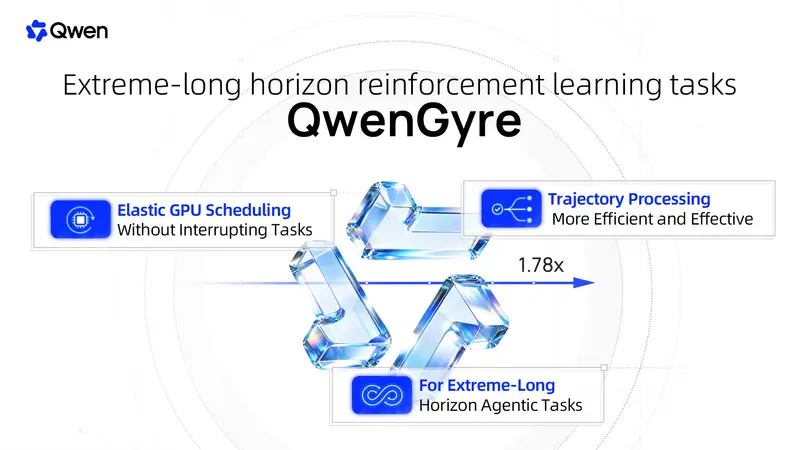
阿里Qwen发布QwenGyre:面向超长视野Agent的弹性强化学习框架,GPU可在推理Rollout与训练间动态切换阿里Qwen团队推出 QwenGyre,它不是大模型,而是一套超长视野代理(Long-horizon Agent)弹性强化学习框架。专门用于训练需要持续运行数小时、上下文接近百万Token的Agent...新技术# QwenGyre1个月前690
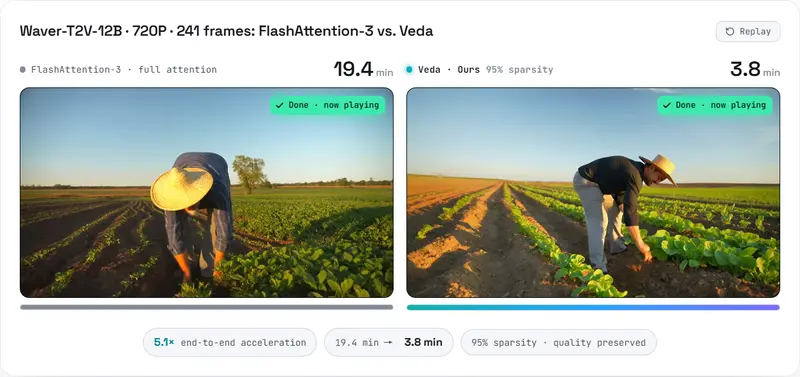
Veda 稀疏注意力框架:给高清长视频DiT加速,720P/241帧最高5.1倍提速Veda 由字节跳动、香港城市大学与中国科学技术大学联合提出的一套面向视频模型的全注意力瓦片蒸馏稀疏注意力框架,目标是在尽量不损失观感的前提下,大幅降低高清长视频AI生成的算力开销。在感知质量基本保持...新技术# Veda2个月前1130
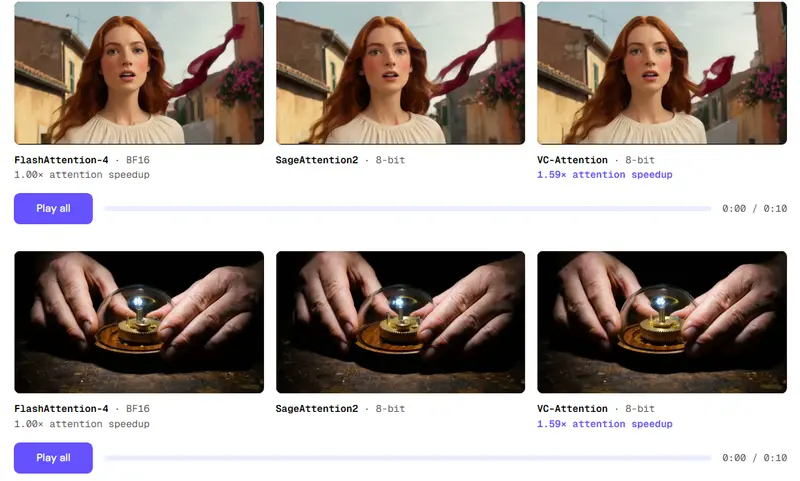
Nunchux AI 发布 VC-Attention:免训练低比特内核,视频生成速度提升最高 3.58 倍Nunchux AI 正式推出了 VC-Attention,一种专为视频扩散 Transformer (DiT) 设计的免训练低比特注意力内核。该技术通过解决值量化误差和 Softmax 计算瓶颈两大...新技术# Nunchux AI# VC-Attention2个月前1050
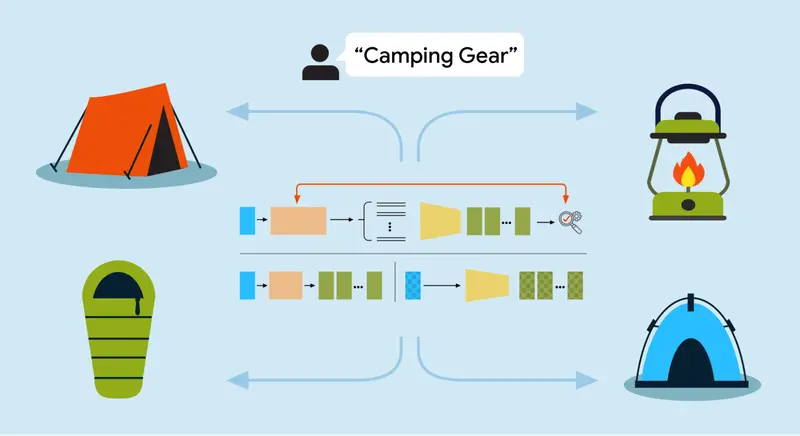
Google Research 推出 Retrieve-for-Train(R4T):强化学习 + 扩散检索器,查询扇出速度提升 12~20 倍Google Research 发布了 Retrieve-for-Train (R4T),一种创新的检索框架,解决搜索和推荐系统中“查询扇出”(Query Fan-out)的效率与质量瓶颈。通过结合强...新技术# Google Research# Retrieve-for-Train2个月前1430
微软 Silica 玻璃存储突破:4.8TB 数据封存万年,普通硼硅酸盐玻璃成关键数据会腐烂,但玻璃可以永恒。 微软研究院最新展示的 Silica 项目,标志着长期数字存档技术迈出了从实验室走向实用化的关键一步。这项基于玻璃的存储系统,不仅能在手掌大小的玻璃片中存储高达 4.8 T...新技术# 微软# 玻璃存储4个月前1940
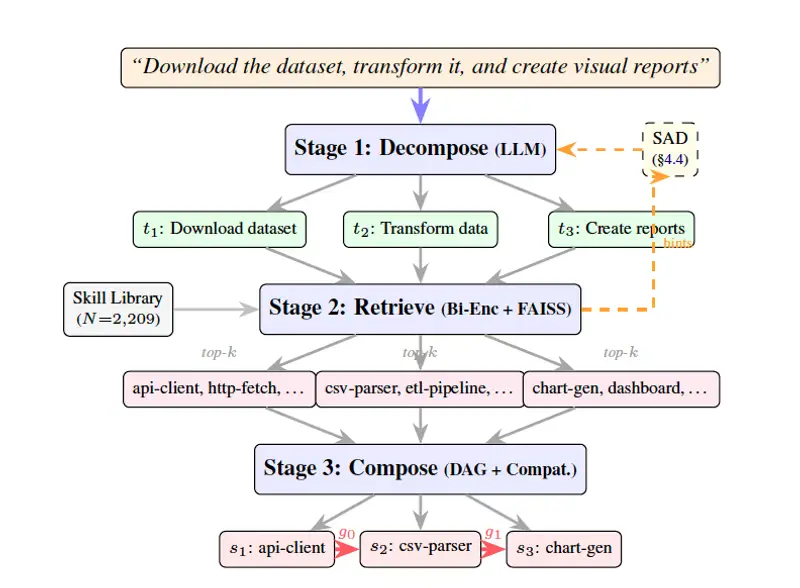
阿里云推出SkillWeaver:通过技能感知分解将智能体 Token 消耗降低 99%随着企业级 AI 智能体(Agent)处理的业务逻辑日益复杂,开发者面临着一个严峻的挑战:如何让智能体在拥有数百甚至数千个工具库的情况下,准确选择并组合正确的工具来完成任务?传统的做法是将所有工具描述...新技术# SkillWeaver# 阿里云5个月前3030
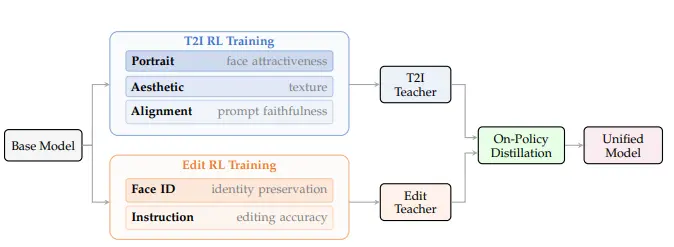
阿里推出Qwen-Image-2.0-RL:让 AI 绘画从“能画”进化到“懂你”的强化学习升级在 AI 绘画领域,用户常面临两大痛点:“听不懂人话”(文生图内容偏差)和“画不出美感”(质感失真、人脸恐怖谷)。阿里云 Qwen 团队推出的 Qwen-Image-2.0-RL,通过在基础模型之上引...新技术# Qwen-Image-2.0-RL5个月前2640
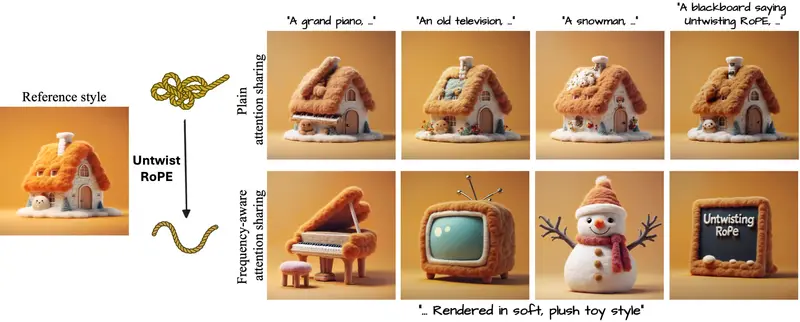
解开 RoPE 的“结”:西蒙菲莎大学与特拉维夫大学提出“Untwisting RoPE”,彻底解决 DiT 模型风格迁移中的“参考复制”难题在 AI 绘画领域,风格迁移一直是一个既迷人又棘手的问题。用户希望 AI 能借鉴参考图的笔触、色调和质感(风格),却严格保持文字描述的内容(语义)。然而,当这一技术从早期的 UNet 架构(如 Sta...新技术# Untwisting RoPE# 风格迁移5个月前2090
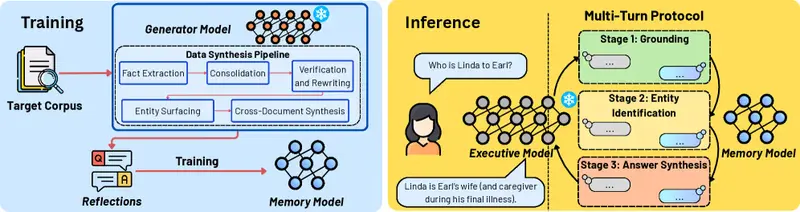
MeMo:无需重训即可升级 LLM 的记忆框架,性能跃升 26%,通过模块化“记忆模型”规避 RAG 局限与灾难性遗忘在大语言模型(LLM)的应用中,如何让冻结的模型持续获取新知识而不进行昂贵的重新训练,一直是企业 AI 面临的难题。MeMo 是一个由多所大学研究人员开发的创新框架,它引入了一种模块化的“记忆模型”架...新技术# MEMO# 记忆框架6个月前2950