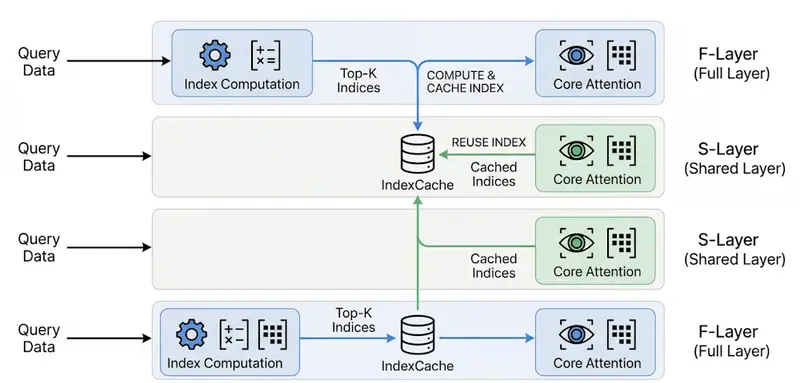
IndexCache:解锁长上下文 AI 的“速度密码”,推理提速高达 1.82 倍在处理 20 万 token 甚至更长的上下文时,大型语言模型(LLM)往往面临“又贵又慢”的困境。随着上下文长度增加,计算成本呈平方级飙升,成为阻碍长文档分析、复杂智能体工作流落地的最大瓶颈。 论文...新技术# IndexCache7个月前2860