由微信视觉团队与清华大学研究者联合推出的 WeMM-Video 系列正式开源。这是一套面向中英双语的音画联合感知与推理基础模型,解决当前多模态 AI 在“音视频联合理解”上的核心痛点。
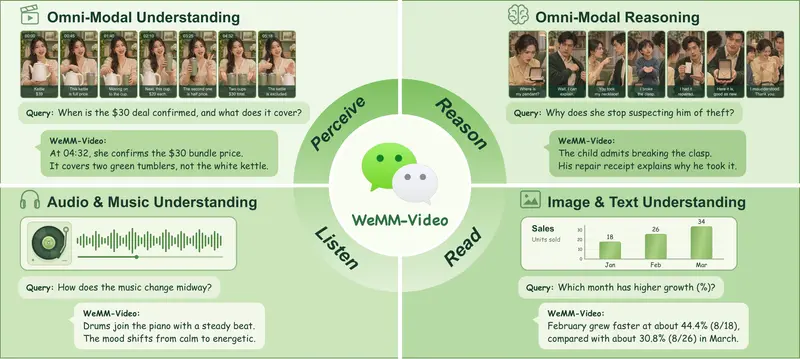
该系列提供 2B、4B、9B 稠密模型及 35B-A3B 混合专家(MoE)模型,通过原生音视频交错对齐建模和显式分步思考机制,在多项基准测试中超越 Qwen3.5-Omni-Flash 等闭源模型,达到开源方案的最佳水平(SOTA)。
- GitHub:https://github.com/Tencent/WeMM-Video
核心突破:从“看无声电影”到“音画同步复盘”
传统多模态模型往往将视觉和音频割裂处理,导致忽略关键声音线索或产生幻觉。WeMM-Video 的核心创新在于:
- 原生音视频联合建模:
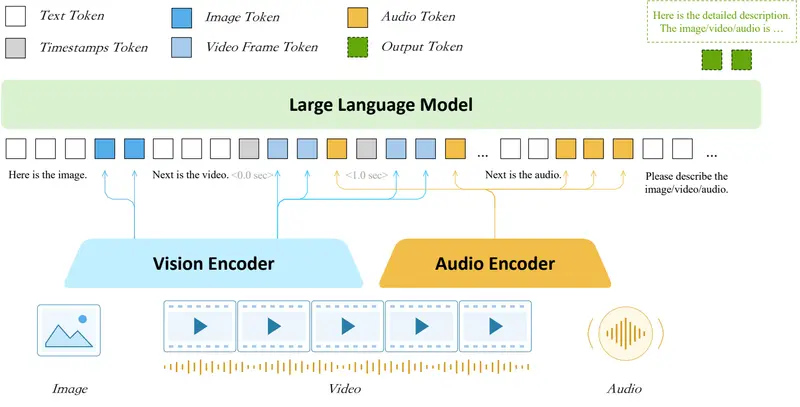
- 不再简单拼接视听结果,而是将视频帧特征与基于 Whisper 改造的音频特征,按照真实时间顺序交错对齐。
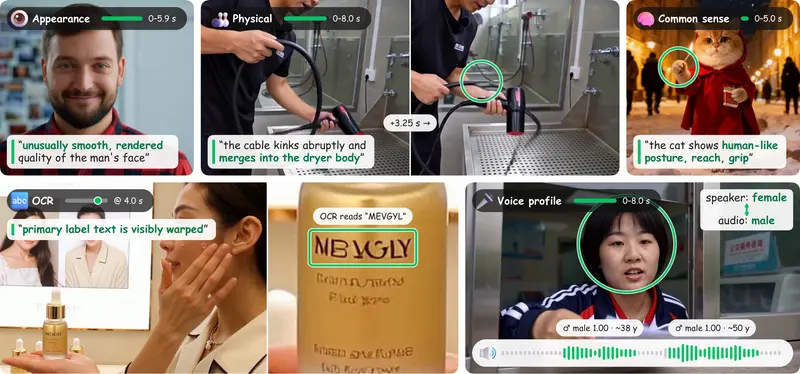
- 模型能精准理解哪一段声音对应哪一段画面事件,从而准确分析人物对话、背景音乐情绪及环境噪音。
- 双模式回答机制:
- Instruct 模式:快速直接作答,适合简单查询。
- Thinking 模式:支持显式多步推理。AI 会展示基于视频画面和音频证据的完整推导逻辑,显著降低复杂场景下的幻觉编造概率。
- 全模态任务兼容:
- 统一处理文本、图片、纯音频、无声视频及带音视频五大类输入。
- 在增强音视频能力的同时,未牺牲图像识别、文档 OCR 及数学推理等通用能力,实现能力均衡。
模型架构与训练流水线
WeMM-Video 建立在成熟的大语言底座之上,由视觉编码器、专用音频编码器和主 LLM 组成,经过约 1.2 万亿多模态 Token 的训练:
- 渐进式预训练:
- 音频模态对齐:冻结主干,训练音频适配模块,建立声音与文字的对应关系。
- 全模态知识注入:放开参数,学习画面、声音、文字间的复杂关联,重点覆盖影视剧、直播等音画配套内容。
- 长上下文拓展:提升对长视频、长录音的记忆与处理能力。
- 多阶段后训练:
- 多教师在线蒸馏 (OPD):迁移不同领域老师模型的知识,避免音频能力提升导致其他能力下降。
- 反重复 MrDPO:专门优化输出重复问题,保证生成稳定性。
- 专家强化学习 (RL):针对说话人识别、音乐理解等高难任务进行专项强化。
性能表现:开源第一梯队
在超过 120 套公开评测基准的横向对比中,WeMM-Video 展现了强大的竞争力:
| 模型版本 | 参数量 | 核心优势 | 对标表现 |
|---|---|---|---|
| WeMM-Video-35B-A3B | 35B (MoE) | 旗舰版,综合音视频理解最强 | 优于 Qwen3.5-Omni-Flash、Seed2.0-Mini;接近 Gemini-3.0-Flash |
| WeMM-Video-9B | 9B | 性价比极高,小硬件友好 | 大部分指标超过 Qwen3-Omni-30B-A3B-Instruct |
| WeMM-Video-4B/2B | 4B/2B | 轻量级,适合边缘部署 | 4B 击败众多 30B 级别基线;2B 在感知任务上具备竞争力 |
注:开启 Thinking 模式后,在复杂音视频推理、事件判断及人物分辨任务上得分有可观提升。
应用场景
- 短视频与直播分析:结合画面与人声进行内容审核、剧情解析、标签提取及素材检索,已落地微信部分视频业务。
- 智能体感知底座:为 AI Agent 提供看视频、听声音的能力,支持现实环境中的多模态感知与交互。
- 多媒体内容生产:辅助影视剪辑,自动提取对话、事件节点及背景音乐信息,生成剪辑脚本。
- 科研与二次开发:全套模型权重、评测代码及复现流程开源,为学术界提供公平对比的音视频理解基线。
局限性与展望
作为科研原型,WeMM-Video 仍存在一定局限:超长时长视频可能会丢失部分细节;无法完全杜绝小概率幻觉;旗舰版对硬件配置要求较高。但凭借其完整的开源生态和卓越的音画联合推理能力,WeMM-Video 为构建更懂“视听语言”的 AI 智能体奠定了坚实基础。
© 版权声明
文章版权归作者所有,未经允许请勿转载。