SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    多模态模型

    共 34 篇文章
    排序
    发布更新浏览点赞
    Tuna-2:Meta AI 提出无编码器统一多模态模型,像素级端到端训练超越传统架构

    Tuna-2:Meta AI 提出无编码器统一多模态模型,像素级端到端训练超越传统架构

    在当前的统一多模态模型(Unified Multimodal Models)中,预训练的视觉编码器(如 VAE 或 CLIP)几乎是标配。这种模块化设计虽然成熟,却带来了一个根本性问题:理解任务与生成...
    图像模型# Meta AI# Tuna-2# 多模态模型
    6个月前
    2180
    中国多所高校联合推出 DeepGen 1.0:50 亿参数小模型逆袭,图像生成与编辑能力媲美 800 亿巨无霸

    中国多所高校联合推出 DeepGen 1.0:50 亿参数小模型逆袭,图像生成与编辑能力媲美 800 亿巨无霸

    在AI领域,“大力出奇迹”似乎已成为一种默认法则:模型参数越大,效果越好。然而,由上海创智学院、复旦大学、中国科学技术大学、上海交通大学、浙江大学、西湖大学、南京大学以及南加州大学的研究人员共同推出的...
    图像模型# DeepGen 1.0# 多模态模型
    8个月前
    4170
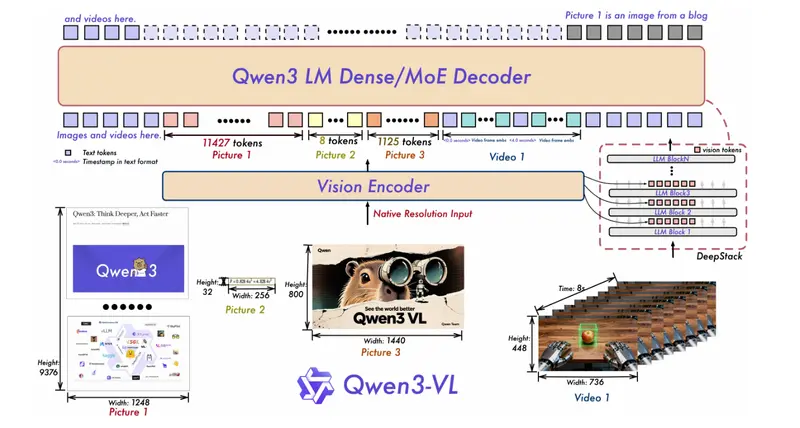
    阿里巴巴 Qwen 推出紧凑型多模态模型 Qwen3-VL 4B/8B,支持 FP8 低显存部署

    阿里巴巴 Qwen 推出紧凑型多模态模型 Qwen3-VL 4B/8B,支持 FP8 低显存部署

    阿里巴巴通义千问(Qwen)团队于 2025 年 10 月 15 日正式发布 Qwen3-VL 4B 与 8B 两款稠密视觉语言模型,每款均提供 指令版(Instruction) 与 思维版(Reas...
    多模态模型# Qwen3-VL 4B# Qwen3-VL 8B# 多模态模型
    1年前
    8190
    IBM 推出 Granite Docling:专为文档转换优化的轻量级多模态模型

    IBM 推出 Granite Docling:专为文档转换优化的轻量级多模态模型

    IBM Research 正式发布 Granite Docling-258M,一款基于 IDEFICS3 架构构建的新型多模态图像-文本到文本模型,专为高效、准确的文档理解与结构化转换而设计。 Git...
    多模态模型# Granite Docling-258M# 多模态模型# 文档转换
    1年前
    3000
    中国团队推出 Lumina-DiMOO:支持生成与理解的全能多模态模型

    中国团队推出 Lumina-DiMOO:支持生成与理解的全能多模态模型

    由上海人工智能实验室牵头,联合上海创智学院、上海交通大学、悉尼大学、南京大学、香港中文大学和清华大学的研究团队,共同推出 Lumina-DiMOO ——一个面向多模态生成与理解一体化的新型基础模型。 ...
    图像模型# Lumina-DiMOO# 多模态模型
    1年前
    5280
    Thyme:会生成代码的多模态模型,突破“图像思考”边界

    Thyme:会生成代码的多模态模型,突破“图像思考”边界

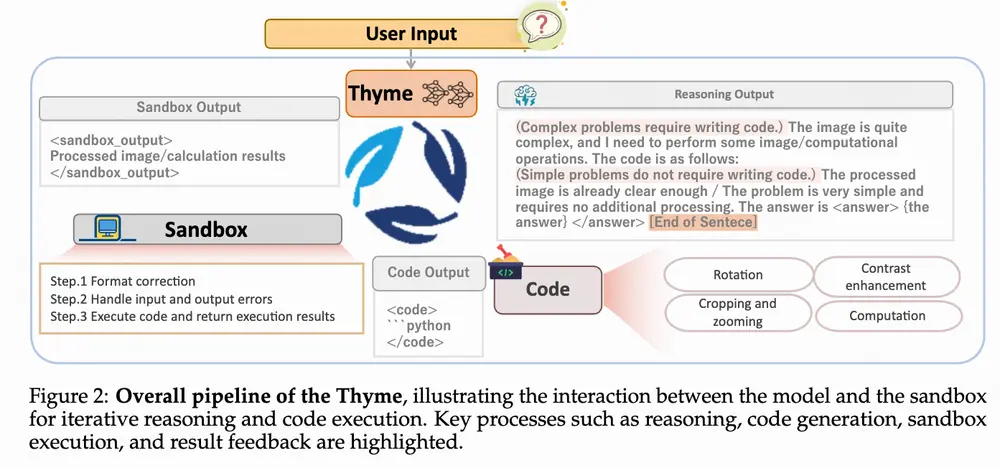
    由快手联合中科院自动化所、南京大学、清华大学、中国科学技术大学共同研发的Thyme,重新定义了视觉多模态模型的能力边界。它不再局限于传统的“用图像思考”,而是通过自主生成、执行代码,完成多样化的图像处...
    多模态模型# Thyme# 多模态模型
    1年前
    3080
    昆仑万维天工项目组推出多模态模型Skywork UniPic:能够统一处理图像理解、文本到图像生成和图像编辑等多种任务

    昆仑万维天工项目组推出多模态模型Skywork UniPic:能够统一处理图像理解、文本到图像生成和图像编辑等多种任务

    昆仑万维天工项目组推出多模态模型Skywork UniPic,它是一个参数量为15亿的自回归模型,能够统一处理图像理解、文本到图像生成和图像编辑等多种任务,而无需针对每个任务单独适配或连接模块。 Gi...
    多模态模型# Skywork UniPic# 多模态模型
    1年前
    6100
    腾讯ARC实验室发布 ARC-Hunyuan-Video-7B:专为短视频理解而生的多模态模型

    腾讯ARC实验室发布 ARC-Hunyuan-Video-7B:专为短视频理解而生的多模态模型

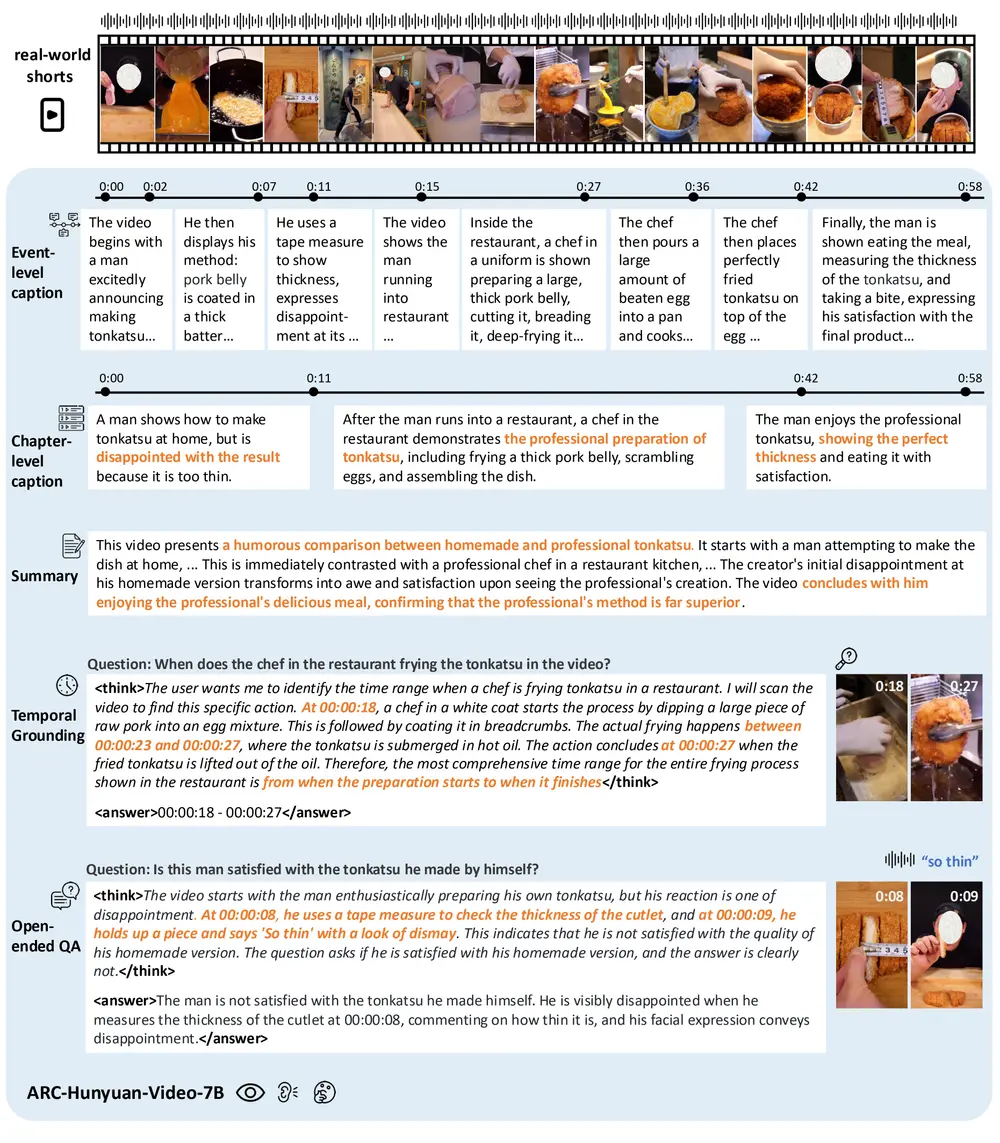
    在微信视频号、TikTok 等平台上,每天有数亿条用户生成的短视频被上传。这些视频内容多样、节奏快、信息密度高,往往融合了画面、语音、音效、文字甚至情绪表达。如何让AI真正“理解”这些视频,而不仅仅是...
    多模态模型# ARC-Hunyuan-Video-7B# 多模态模型# 腾讯ARC实验室
    1年前
    9110
    ComfyUI-OmniGen2:为多模态模型OmniGen2 打造的 ComfyUI 自定义节点插件

    ComfyUI-OmniGen2:为多模态模型OmniGen2 打造的 ComfyUI 自定义节点插件

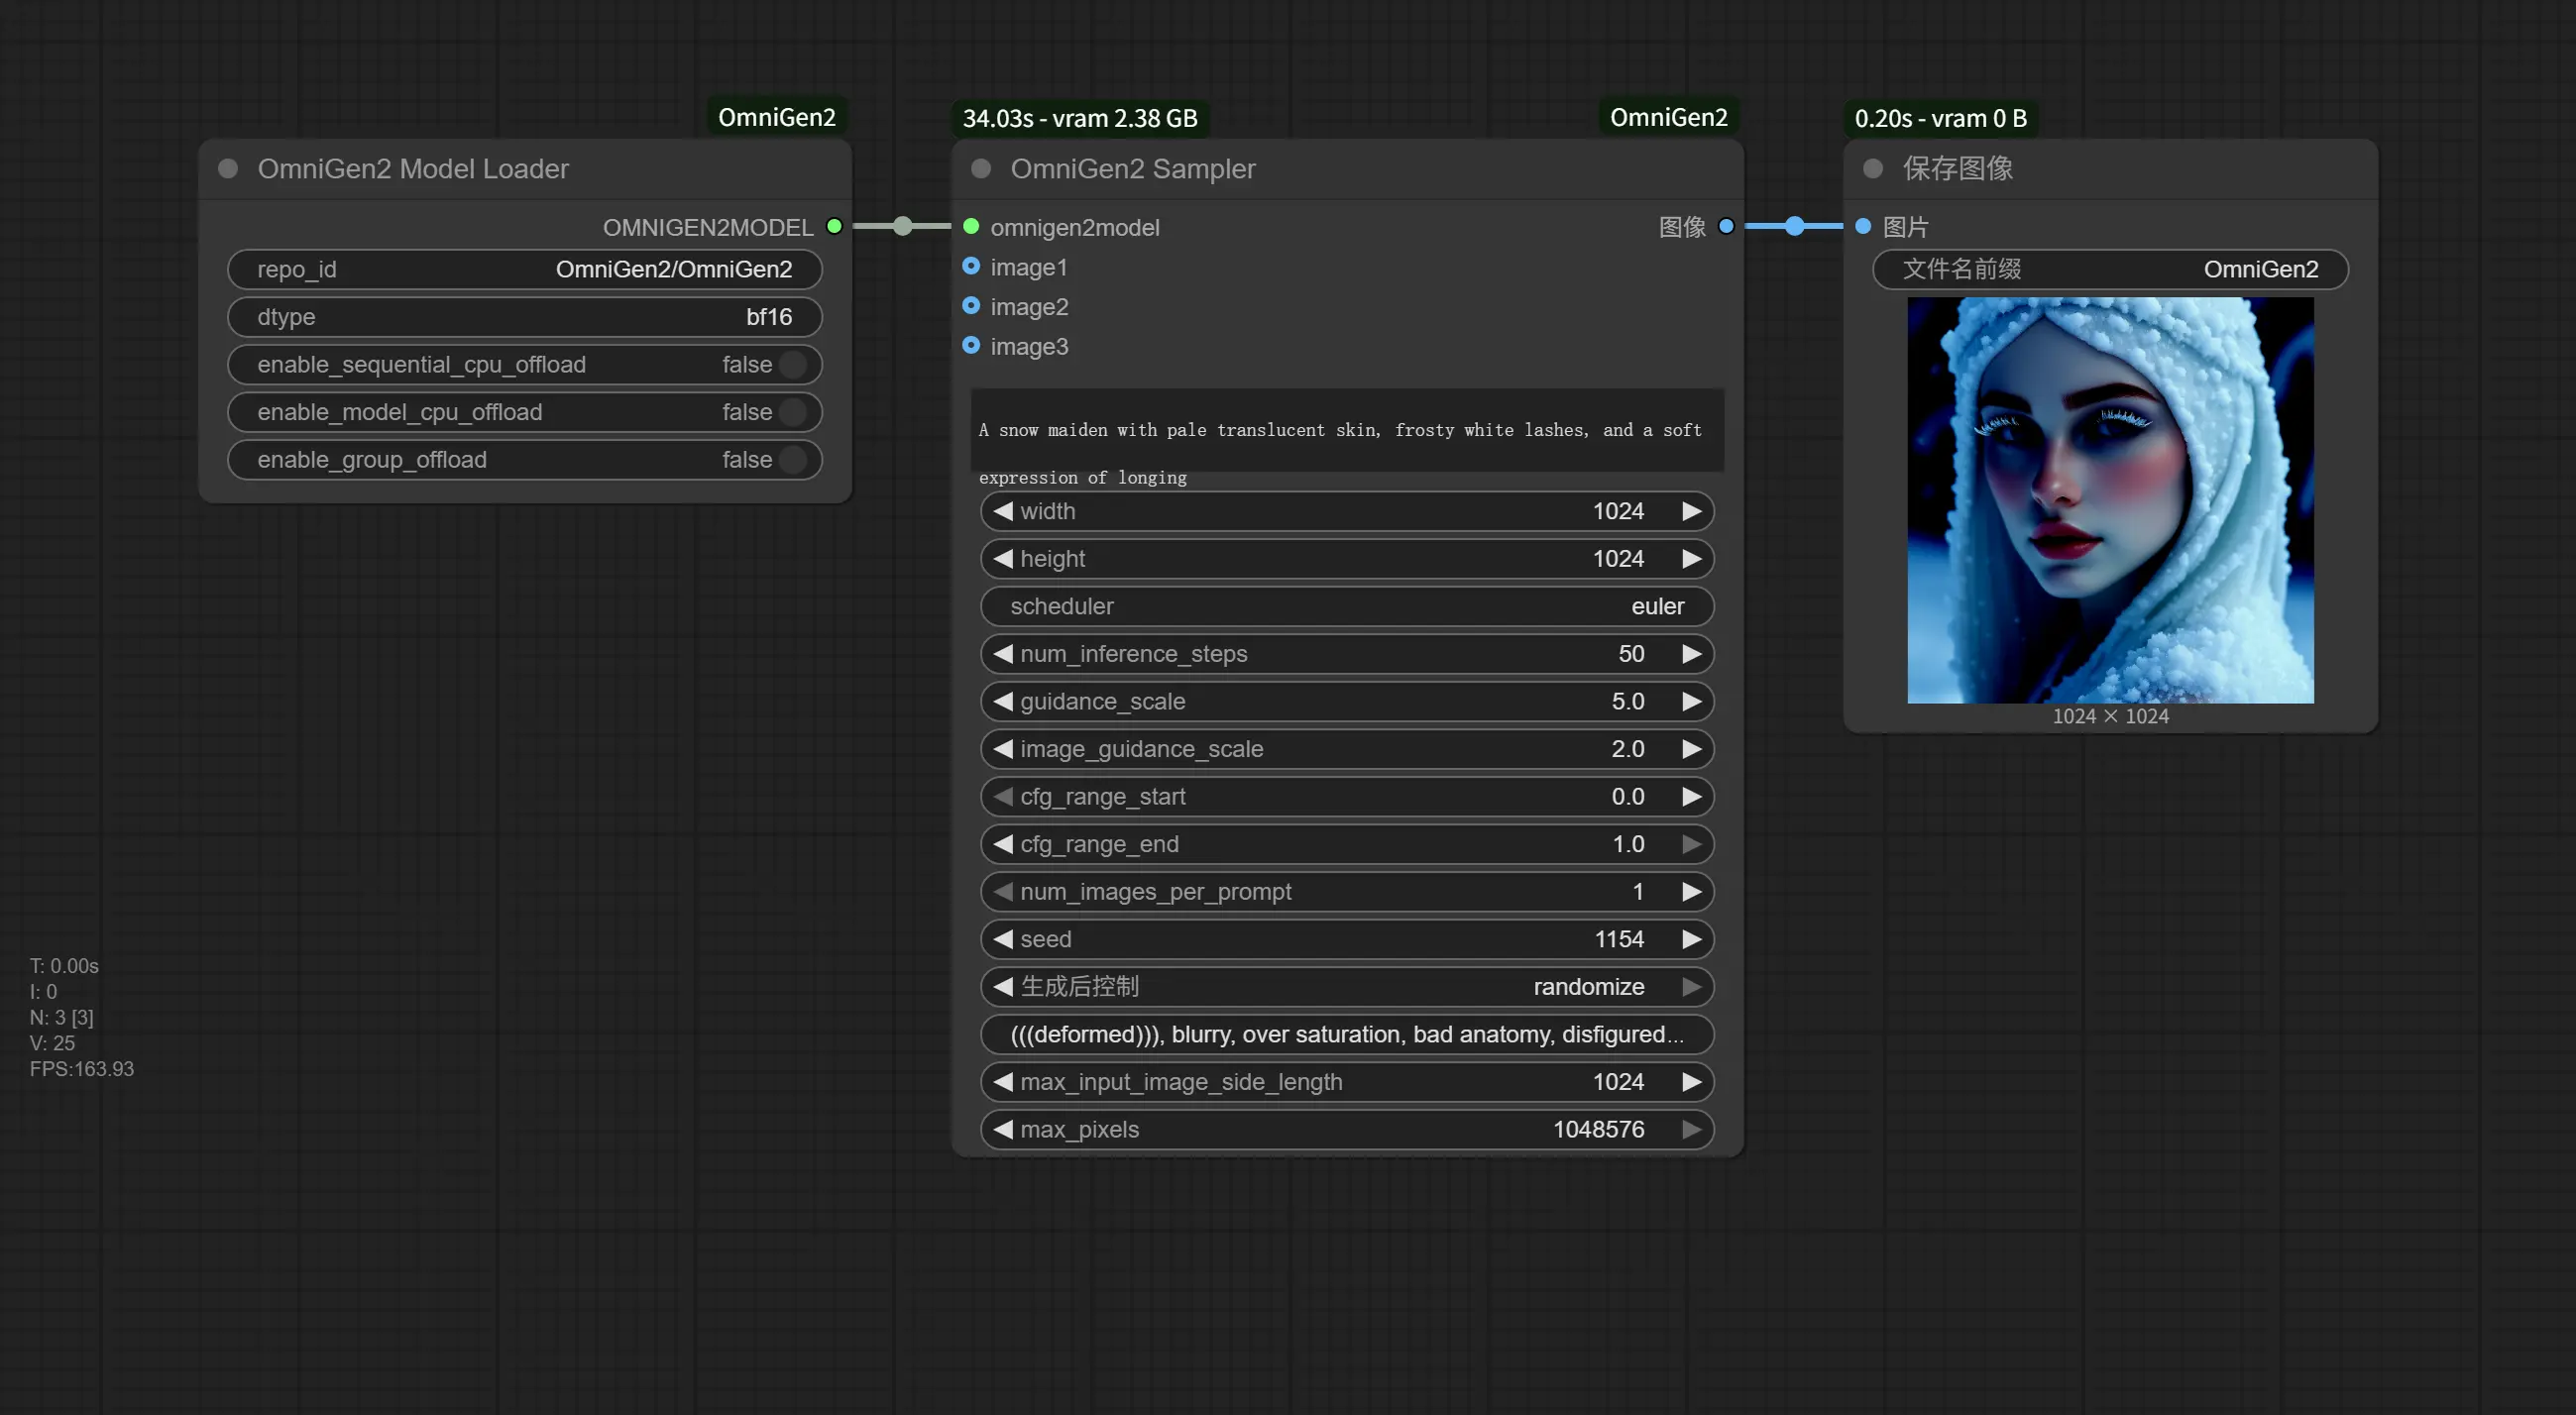
    北京AI研究院发布的集成了视觉理解、文本到图像生成、指令驱动编辑和基于主体的上下文生成能力的统一多模态模OmniGen2,如果你希望在 ComfyUI 中实现图像生成、编辑和视觉理解任务,那么 Com...
    插件# ComfyUI# OmniGen2# 多模态模型
    1年前
    7450
    开源版GPT-4o!字节跳动开源新一代多模态模型 BAGEL:多模态理解、图像生成、图像编辑,还能“思考”

    开源版GPT-4o!字节跳动开源新一代多模态模型 BAGEL:多模态理解、图像生成、图像编辑,还能“思考”

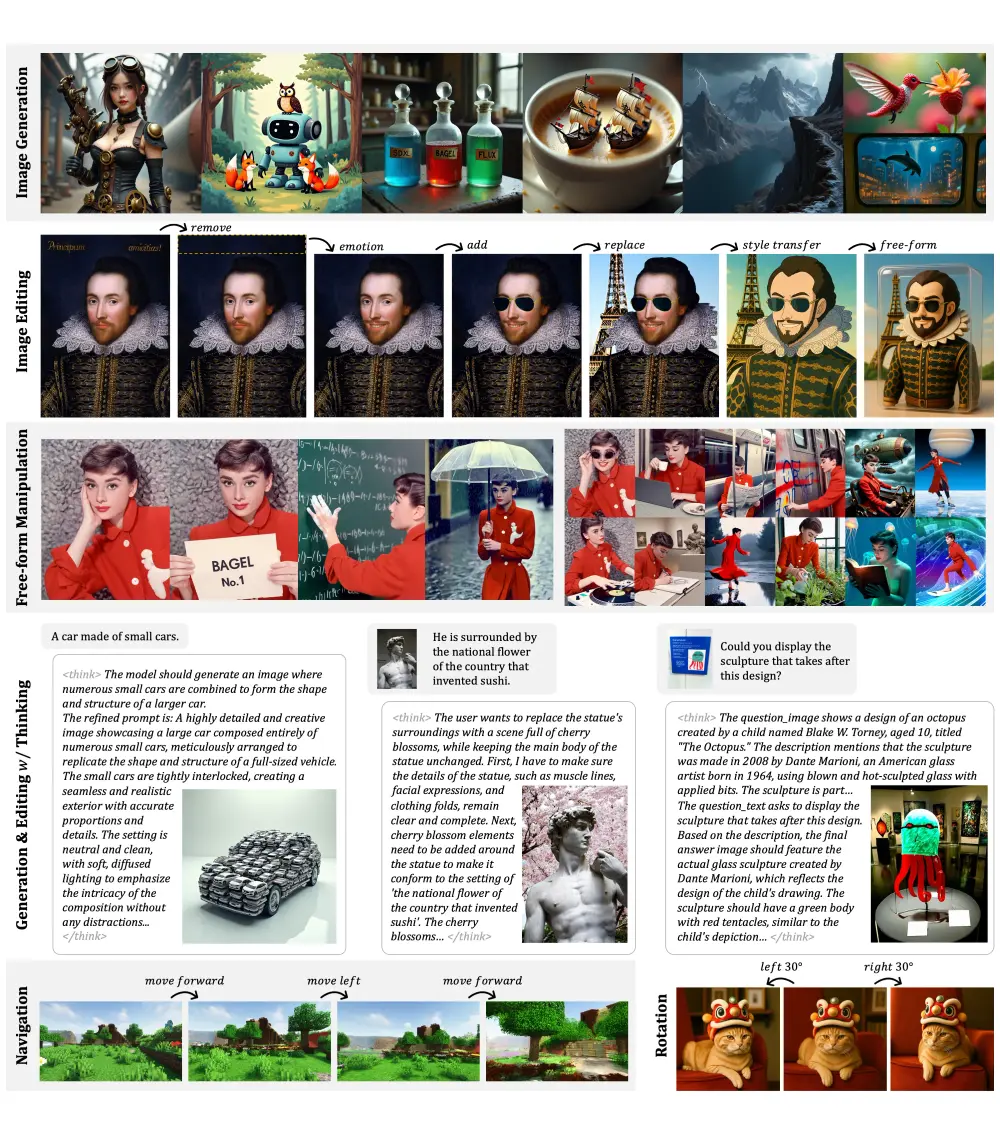
    字节跳动发布了一款名为 BAGEL 的开源多模态基础模型,该模型拥有 70 亿活跃参数(总规模为 140 亿),在大规模交错多模态数据上进行训练。BAGEL 不仅在标准多模态理解排行榜中超越了当前主流...
    图像模型# BAGEL# GPT-4o# 多模态模型
    1年前
    1,2990
    字节跳动推出多模态文档图像解析模型Dolphin

    字节跳动推出多模态文档图像解析模型Dolphin

    在复杂文档图像理解和结构化提取任务中,如何准确识别并组织交织的文本段落、公式、表格和图像,一直是业界的技术难点。 GitHub:https://github.com/bytedance/Dolphin...
    多模态模型# Dolphin# 多模态模型# 字节跳动
    1年前
    5870
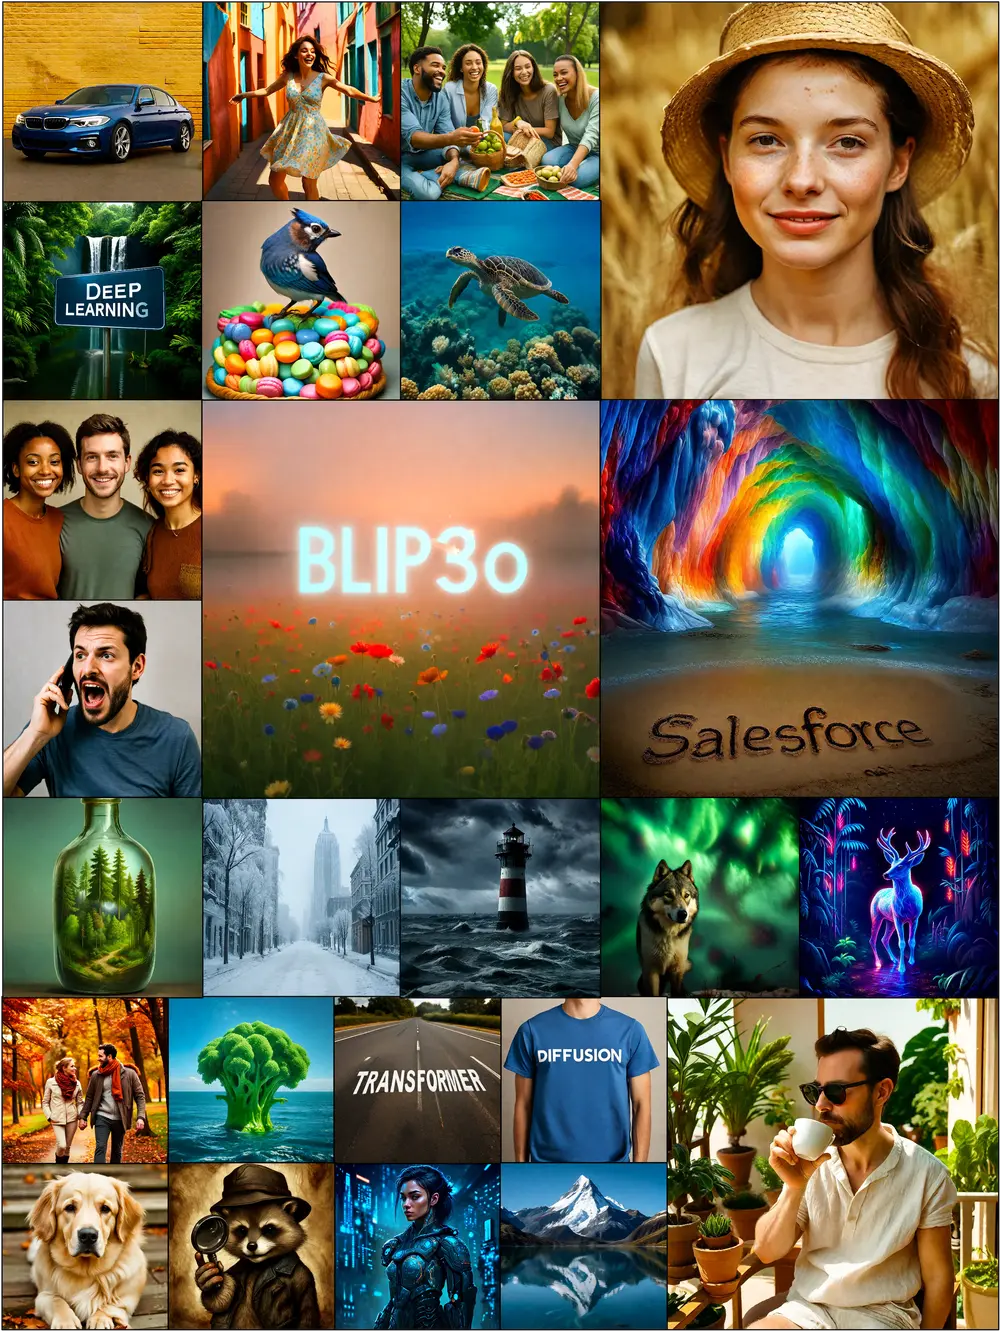
    新型统一多模态模型家族 BLIP3-o:同时支持图像理解和图像生成任务

    新型统一多模态模型家族 BLIP3-o:同时支持图像理解和图像生成任务

    Salesforce、马里兰大学、弗吉尼亚理工大学、纽约大学、华盛顿大学和加州大学戴维斯分校的研究人员推出新型统一多模态模型家族 BLIP3-o ,同时支持图像理解和图像生成任务。多模态模型是指能够处...
    多模态模型# BLIP3-o# 多模态模型
    1年前
    4320
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    天府智能体 (Tianfu Agent) 

    天府智能体 (Tianfu Agent) 

    天府智能体 (Tianfu Agent) 作为全球首个专为深度命理推理设计的智能体,它并非简单的聊天机器人,而是一个融合了紫微斗数、子平八字、奇门遁甲三大传统术数体系的复杂 AI 系统。
    ITELLOU

    ITELLOU

    ITELLYOU(也称为NEXT, ITELLYOU)是一个专注于提供微软原版软件资源的非官方网站,主要帮助用户获取未经修改的微软产品镜像,如Windows操作系统、Office办公软件和开发工具等。
    TapNow

    TapNow

    TapNow是一个面向创作者的专业级 AI 视觉内容平台,支持从脚本撰写、分镜头设计到高保真成片输出的完整流程,单人即可在 1–3 天内完成传统需 4–6 周的影视级项目。
    Open ASR 排行榜

    Open ASR 排行榜

    Open ASR 排行榜 对 Hugging Face Hub 上的语音识别模型进行排名和评估。我们报告平均 WER(字错误率)(⬇️ 越低越好)和 RTFx(实时因子)(⬆️ 越高越好),模型根据其平均 WER 从低到高进行排名。
    DSH to Figma

    新DSH to Figma

    DSH to Figma 是 DeepSeek Harness(DSH)的原生插件,搭配配套Figma插件实现本地桥接,把Figma画布能力接入DSH代理。核心优势是本地模式不走Figma官方MCP,不消耗官方调用额度,可以直接读取、编辑画布、截图、导出素材。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      天府智能体 (Tianfu Agent) 

      天府智能体 (Tianfu Agent) 

      天府智能体 (Tianfu Agent) 作为全球首个专为深度命理推理设计的智能体,它并非简单的聊天机器人,而是一个融合了紫微斗数、子平八字、奇门遁甲三大传统术数体系的复杂 AI 系统。
      ITELLOU

      ITELLOU

      ITELLYOU(也称为NEXT, ITELLYOU)是一个专注于提供微软原版软件资源的非官方网站,主要帮助用户获取未经修改的微软产品镜像,如Windows操作系统、Office办公软件和开发工具等。
      TapNow

      TapNow

      TapNow是一个面向创作者的专业级 AI 视觉内容平台,支持从脚本撰写、分镜头设计到高保真成片输出的完整流程,单人即可在 1–3 天内完成传统需 4–6 周的影视级项目。
      Open ASR 排行榜

      Open ASR 排行榜

      Open ASR 排行榜 对 Hugging Face Hub 上的语音识别模型进行排名和评估。我们报告平均 WER(字错误率)(⬇️ 越低越好)和 RTFx(实时因子)(⬆️ 越高越好),模型根据其平均 WER 从低到高进行排名。
      DSH to Figma

      新DSH to Figma

      DSH to Figma 是 DeepSeek Harness(DSH)的原生插件,搭配配套Figma插件实现本地桥接,把Figma画布能力接入DSH代理。核心优势是本地模式不走Figma官方MCP,不消耗官方调用额度,可以直接读取、编辑画布、截图、导出素材。
      查看完整榜单