SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    多模态模型

    共 34 篇文章
    排序
    发布更新浏览点赞
    Ollama v0.7.0发布:添加新多模态模型引擎,多模态模型支持全面升级

    Ollama v0.7.0发布:添加新多模态模型引擎,多模态模型支持全面升级

    Ollama 最新发布的 v0.7.0 版本带来了对多模态模型的支持,标志着其在本地推理和模型集成能力上的重要突破。此次更新不仅扩展了视觉多模态模型的支持范围,还通过全新的多模态引擎提升了性能、准确性...
    早报# Ollama# 多模态模型# 多模态模型引擎
    2年前
    9490
    多模态模型RoboBrain:让机器人从抽象指令到具体操作的多模态大脑

    多模态模型RoboBrain:让机器人从抽象指令到具体操作的多模态大脑

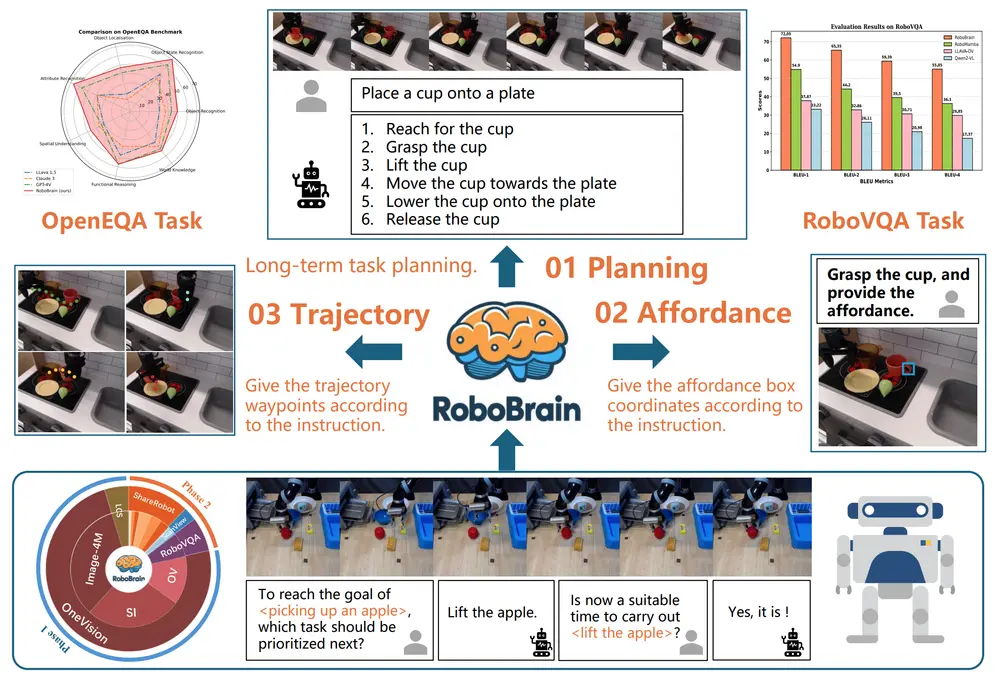
    近年来,多模态大语言模型(MLLMs)在多种场景中展现了卓越的能力,但在机器人领域,尤其是在长时段复杂操作任务中,其表现仍存在显著局限性。这些局限主要源于当前 MLLMs 缺乏三种关键能力:规划能力...
    多模态模型# RoboBrain# 多模态模型# 机器人
    2年前
    4200
    Yo’Chameleon:使大型多模态模型(LMM)实现个性化视觉和语言生成能力

    Yo’Chameleon:使大型多模态模型(LMM)实现个性化视觉和语言生成能力

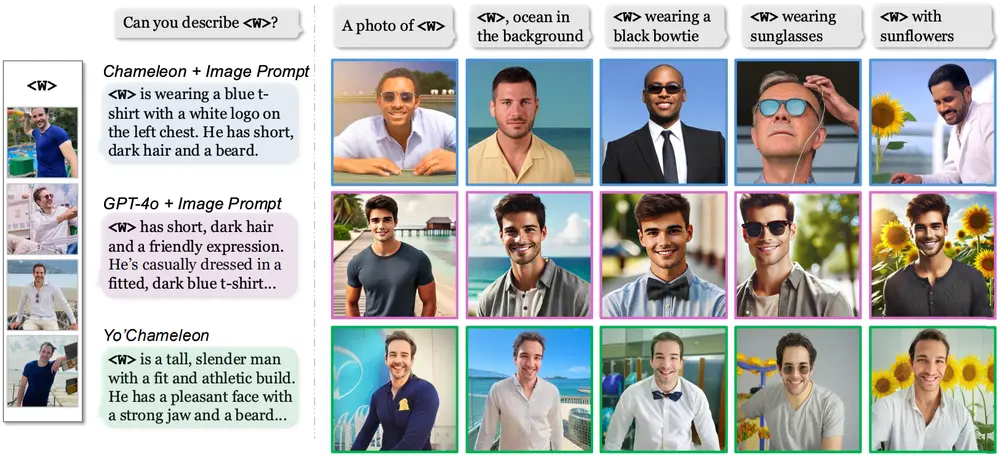
    威斯康星大学麦迪逊分校和Adob​​e Research的研究人员推出新型框架Yo’Chameleon,为大型多模态模型(LMMs)实现个性化视觉和语言生成能力。Yo’Chameleon 通过软提示调...
    新技术# Yo’Chameleon# 多模态模型
    2年前
    6880
    字节跳动推出多模态模型Vidi:专门用于视频理解和编辑

    字节跳动推出多模态模型Vidi:专门用于视频理解和编辑

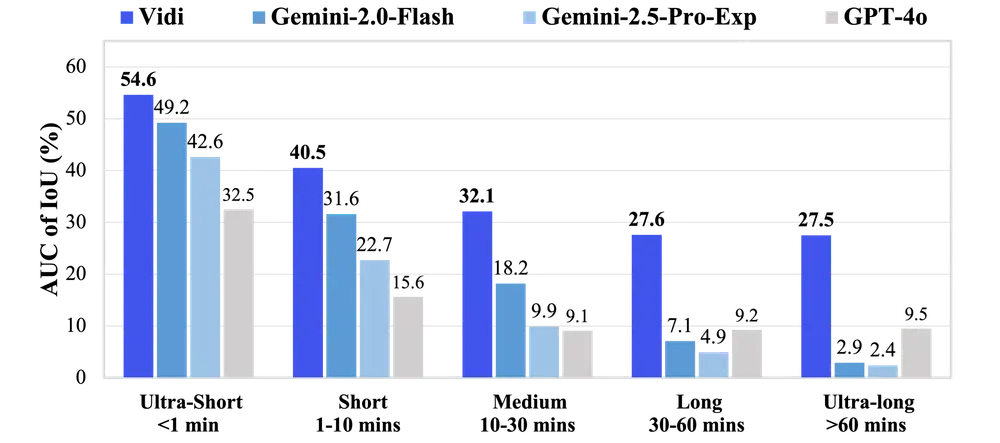
    字节跳动推出多模态模型Vidi,专门用于视频理解和编辑。Vidi 的主要目标是支持高质量、大规模视频内容的创作,通过处理原始输入材料(如未编辑的视频片段)和编辑组件(如视觉效果),帮助用户更高效地完成...
    多模态模型# Vidi# 多模态模型# 字节跳动
    2年前
    4350
    阿里通义实验室发布新一代端到端多模态旗舰模型Qwen2.5-Omni

    阿里通义实验室发布新一代端到端多模态旗舰模型Qwen2.5-Omni

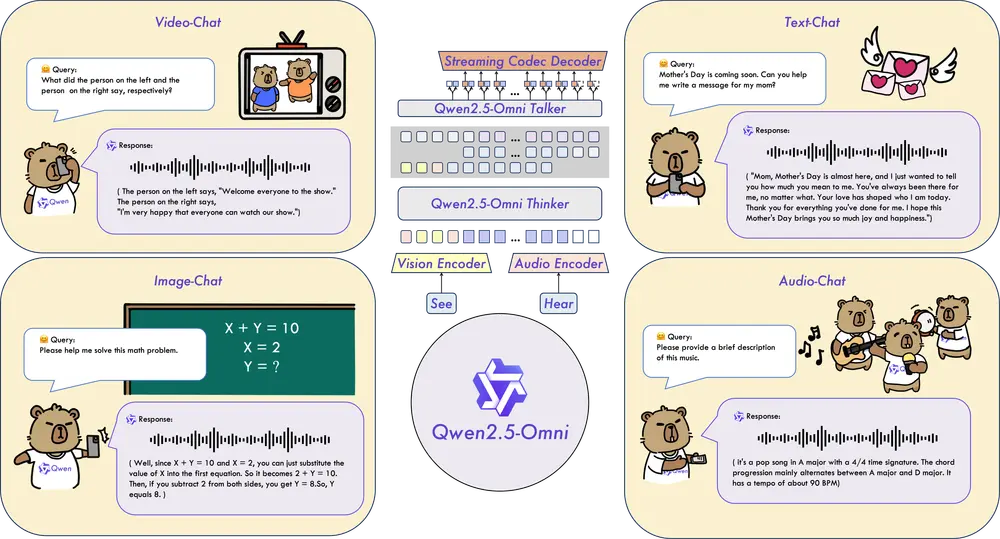
    阿里通义实验室发布了 Qwen2.5-Omni,这是 Qwen 模型家族中的新一代端到端多模态旗舰模型。Qwen2.5-Omni 专为全方位多模态感知设计,能够无缝处理文本、图像、音频和视频等多种输入...
    多模态模型# Qwen2.5-Omni# 多模态模型
    2年前
    4800
    阿里通义实验室开源32B参数的多模态模型 Qwen2.5-VL-32B-Instruct

    阿里通义实验室开源32B参数的多模态模型 Qwen2.5-VL-32B-Instruct

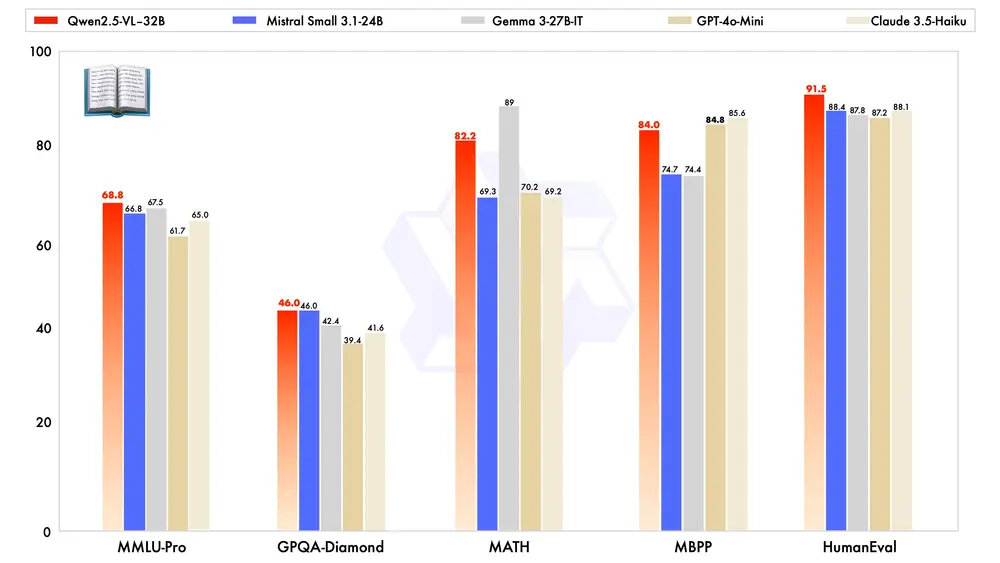
    今年一月底,阿里通义实验室推出了 Qwen2.5-VL 系列模型,凭借其卓越的性能和广泛的应用潜力,迅速获得了社区的广泛关注和积极反馈。在此基础上,团队通过强化学习持续优化模型,并于近期开源了备受期待...
    多模态模型# Qwen2.5-VL-32B-Instruct# 多模态模型# 阿里通义实验室
    2年前
    5070
    新型图像生成框架DREAM ENGINE:结合多模态模型和扩散模型,实现复杂文本-图像交错控制的图像生成任务

    新型图像生成框架DREAM ENGINE:结合多模态模型和扩散模型,实现复杂文本-图像交错控制的图像生成任务

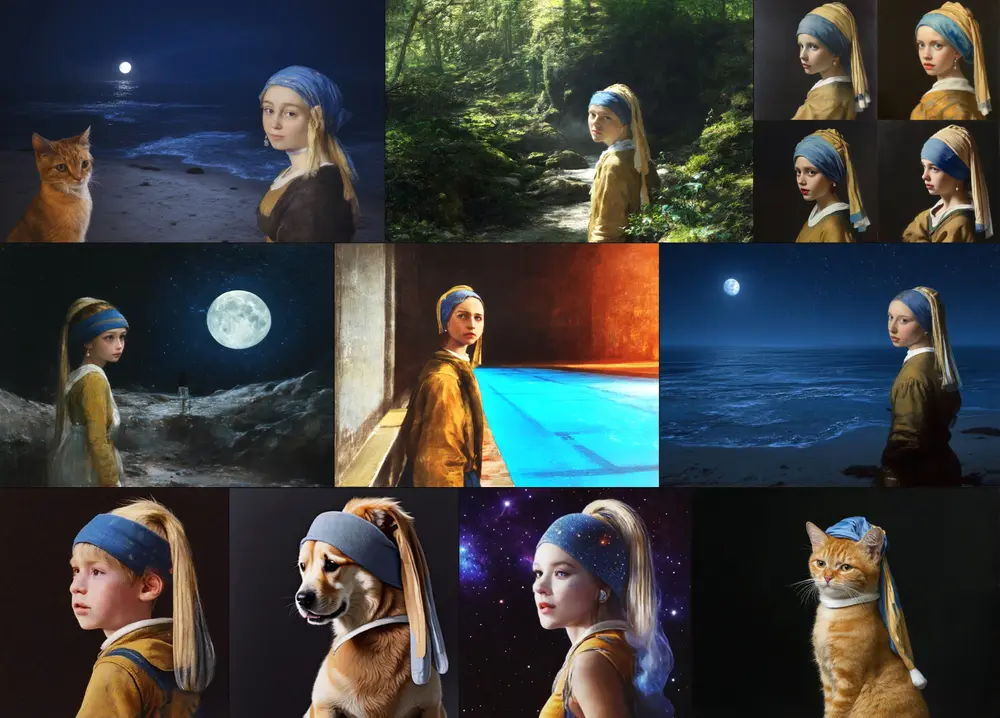
    北京大学、阿里巴巴集团、华盛顿大学、北京理工大学和百安斯实验室的研究人员推出新型图像生成框架 DREAM ENGINE,它通过两阶段训练方法,将 QwenVL 等多模态编码器与扩散模型集成在一起,从而...
    图像模型# DREAM ENGINE# 图像生成# 多模态模型
    2年前
    5430
    首个截图就能生成现代前端代码的多模态模型Flame

    首个截图就能生成现代前端代码的多模态模型Flame

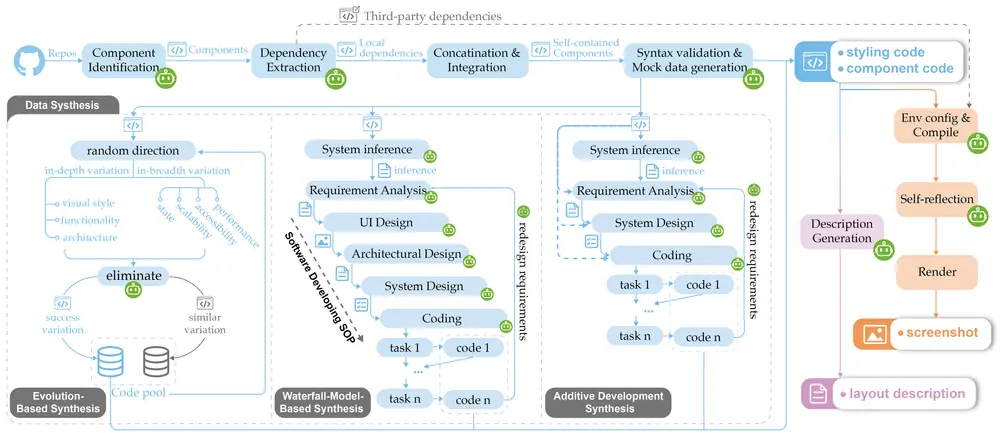
    尽管前沿的多模态模型(如 GPT-4O)在代码生成上展现了强大的能力,但它们在真实的前端开发场景中仍无法满足现代前端工作流程的动态需求。这些模型虽然能够生成代码,但输出的前端代码通常是静态的,缺乏模块...
    多模态模型# Flame# 前端代码# 多模态模型
    2年前
    6680
    Hugging Face 发布轻量级多模态模型SmolVLM2:专为视频内容分析而设计

    Hugging Face 发布轻量级多模态模型SmolVLM2:专为视频内容分析而设计

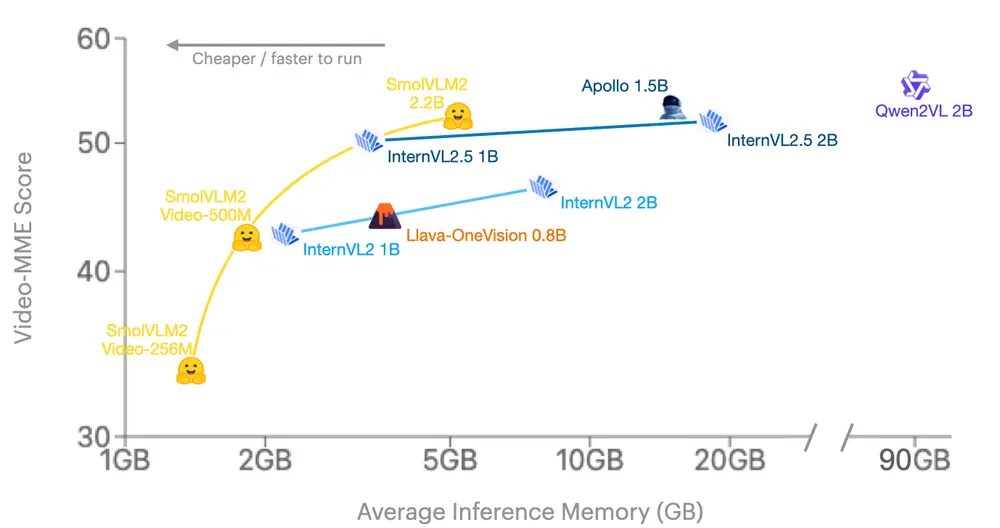
    Hugging Face 最新发布了一款轻量级多模态模型SmolVLM2,专为视频内容分析而设计。该模型以高效性和适应性为核心目标,旨在将视频理解能力扩展到从手机到服务器的各种设备上。SmolVLM2...
    多模态模型# Hugging Face# SmolVLM2# 多模态模型
    2年前
    6380
    高效大型多模态模型LLaVA-Mini:通过最小化视觉令牌(vision tokens)的数量来提高模型的计算效率和响应速度

    高效大型多模态模型LLaVA-Mini:通过最小化视觉令牌(vision tokens)的数量来提高模型的计算效率和响应速度

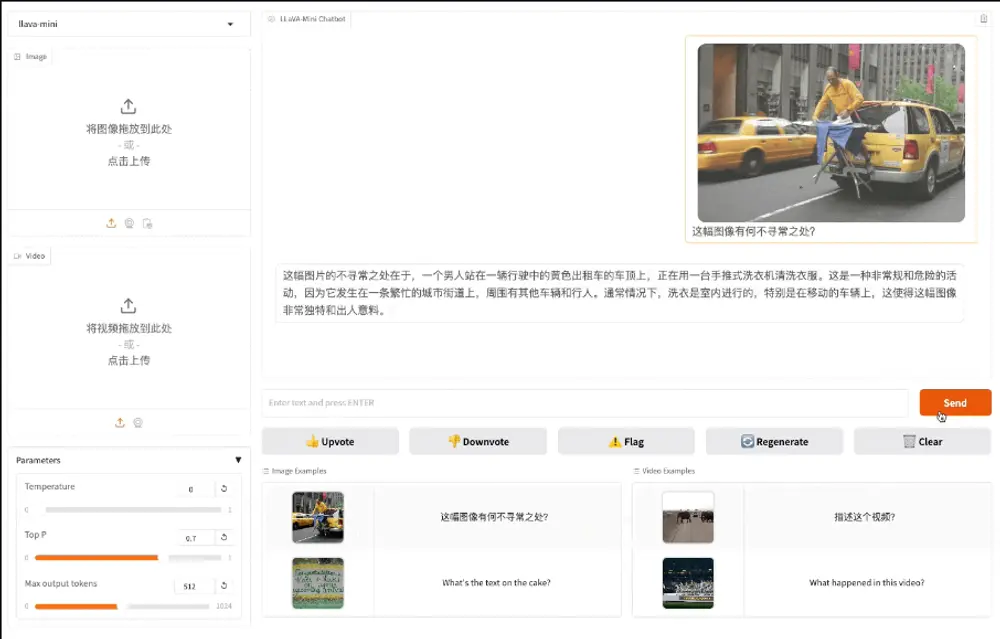
    中国科学院计算技术研究所智能信息处理重点实验室(ICT/CAS)、中国科学院人工智能安全重点实验室和中国科学院大学的研究人员推出高效大型多模态模型LLaVA-Mini,旨在通过最小化视觉令牌(visi...
    多模态模型# LLaVA-Mini# 多模态模型
    2年前
    5040
    Meta推出多模态模型Apollo:擅长处理长视频,能够在长达一小时的视频中保持高效的理解能力

    Meta推出多模态模型Apollo:擅长处理长视频,能够在长达一小时的视频中保持高效的理解能力

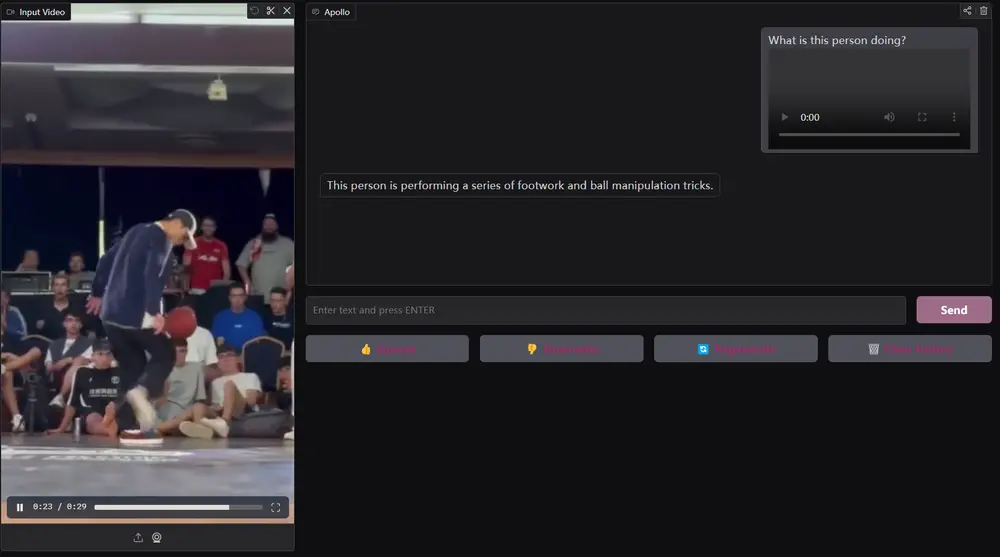
    尽管视频感知能力已经迅速集成到大型多模态模型(LMMs)中,但其驱动视频理解的基本机制仍未被充分理解。这导致了许多设计决策缺乏适当的理由或分析,尤其是在训练和评估这些模型时,高昂的计算成本和有限的开放...
    多模态模型# Apollo# Meta# 多模态模型
    2年前
    4620
    StreamChat:增强大型多模态模型(LMMs)与流媒体视频内容的交互能力

    StreamChat:增强大型多模态模型(LMMs)与流媒体视频内容的交互能力

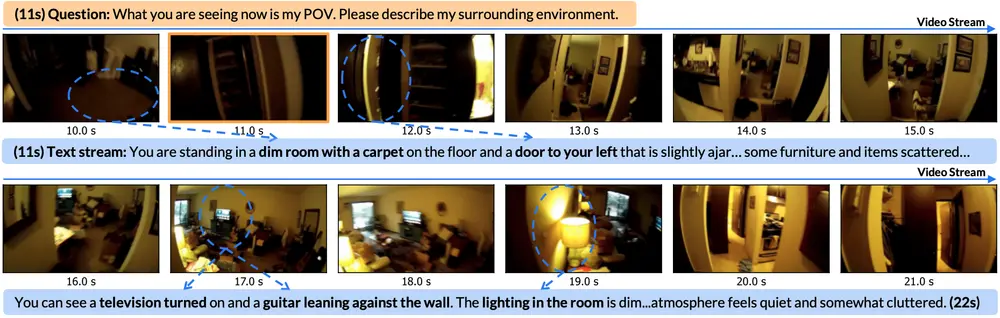
    香港中文大学、英伟达、上海人工智能实验室、InnoHK和香港理工大学的研究人员推出新型方法StreamChat,它旨在增强大型多模态模型(LMMs)与流媒体视频内容的交互能力。在流媒体交互场景中,现有...
    新技术# StreamChat# 多模态模型
    2年前
    4830
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    Medeo

    Medeo

    Medeo 允许用户通过简单的文本描述生成视频,无需复杂的编辑界面。它提供超过数百万的高清视频素材,AI 自动匹配场景素材,并优化脚本、添加配音和背景音乐,完美处理过渡和节奏。此外,它能将网页或文章转为专业视频,支持创建动画故事,并提供个人和社区资产库,方便 A/B 测试和多语言配音。
    RAPTOR

    RAPTOR

    RAPTOR 是一个基于 Claude Code 的自主攻防安全研究框架。它通过智能体工作流与自动化赋能安全研究。
    RSS-AIGC

    RSS-AIGC

    RSS-AIGC是一个非常简易的现代化的 RSS 订阅与 AI 内容聚合平台,专为内容创作者、研究人员和知识工作者设计。系统集成了 AI 报告生成、飞书机器人推送、多源内容聚合等高级功能,帮助用户高效地获取、管理和分析来自 Hacker News、GitHub、ArXiv 等专业平台的内容
    FeedCraft

    FeedCraft

    FeedCraft 是一个简单、强大的 RSS 源处理工具. 他可以作为一个中间件处理你的RSS源, 你可以用它来提取正文、智能翻译、通过AI生成文章摘要、通过自然语言筛选文章等. 它内置了可视化 RSS 生成器 (HTML/Curl/Search to RSS),支持将网页、API (Curl) 或搜索结果转换为 RSS 订阅源。
    Panda Video Generator(熊猫视频自动化引擎)

    Panda Video Generator(熊猫视频自动化引擎)

    Panda Video Generator(熊猫视频自动化引擎)是一站式全自动化的视频内容生成与发布引擎,支持从网页内容提取、文本转视频到多平台发布的完整工作流。通过 AI 驱动的文本转语音(TTS)技术和视频渲染引擎,帮助内容创作者快速生成高质量视频并一键发布到多个平台。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      Medeo

      Medeo

      Medeo 允许用户通过简单的文本描述生成视频,无需复杂的编辑界面。它提供超过数百万的高清视频素材,AI 自动匹配场景素材,并优化脚本、添加配音和背景音乐,完美处理过渡和节奏。此外,它能将网页或文章转为专业视频,支持创建动画故事,并提供个人和社区资产库,方便 A/B 测试和多语言配音。
      RAPTOR

      RAPTOR

      RAPTOR 是一个基于 Claude Code 的自主攻防安全研究框架。它通过智能体工作流与自动化赋能安全研究。
      RSS-AIGC

      RSS-AIGC

      RSS-AIGC是一个非常简易的现代化的 RSS 订阅与 AI 内容聚合平台,专为内容创作者、研究人员和知识工作者设计。系统集成了 AI 报告生成、飞书机器人推送、多源内容聚合等高级功能,帮助用户高效地获取、管理和分析来自 Hacker News、GitHub、ArXiv 等专业平台的内容
      FeedCraft

      FeedCraft

      FeedCraft 是一个简单、强大的 RSS 源处理工具. 他可以作为一个中间件处理你的RSS源, 你可以用它来提取正文、智能翻译、通过AI生成文章摘要、通过自然语言筛选文章等. 它内置了可视化 RSS 生成器 (HTML/Curl/Search to RSS),支持将网页、API (Curl) 或搜索结果转换为 RSS 订阅源。
      Panda Video Generator(熊猫视频自动化引擎)

      Panda Video Generator(熊猫视频自动化引擎)

      Panda Video Generator(熊猫视频自动化引擎)是一站式全自动化的视频内容生成与发布引擎,支持从网页内容提取、文本转视频到多平台发布的完整工作流。通过 AI 驱动的文本转语音(TTS)技术和视频渲染引擎,帮助内容创作者快速生成高质量视频并一键发布到多个平台。
      查看完整榜单