SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    图像生成

    共 35 篇文章
    排序
    发布更新浏览点赞
    MiniMax H3 Image Studio :将MiniMax H3应用于图像生成与参考编辑

    MiniMax H3 Image Studio :将MiniMax H3应用于图像生成与参考编辑

    MiniMax H3 Image Studio 是一个专为 ComfyUI 设计的社区开源项目,将 MiniMax H3 这一原生音视频模型适配为高效的文本生成图像 (T2I)、图像生成图像 (I2I...
    插件# MiniMax H3 Image Studio# 图像生成# 图像编辑
    2个月前
    2510
    Ollama 新增图像生成功能!macOS 率先体验,双模型(Z-Image Turbo 与 FLUX.2 Klein)支持中英文本渲染 + 高精度创作

    Ollama 新增图像生成功能!macOS 率先体验,双模型(Z-Image Turbo 与 FLUX.2 Klein)支持中英文本渲染 + 高精度创作

    Ollama 正式上线图像生成实验性功能,目前已在 macOS 系统开放使用,Windows 和 Linux 版本也即将推出。该功能无需复杂配置,仅需一行终端命令就能调用文生图模型生成图像,支持直接在...
    工具# LUX.2 Klein# Ollama# Z-Image-Turbo
    9个月前
    5910
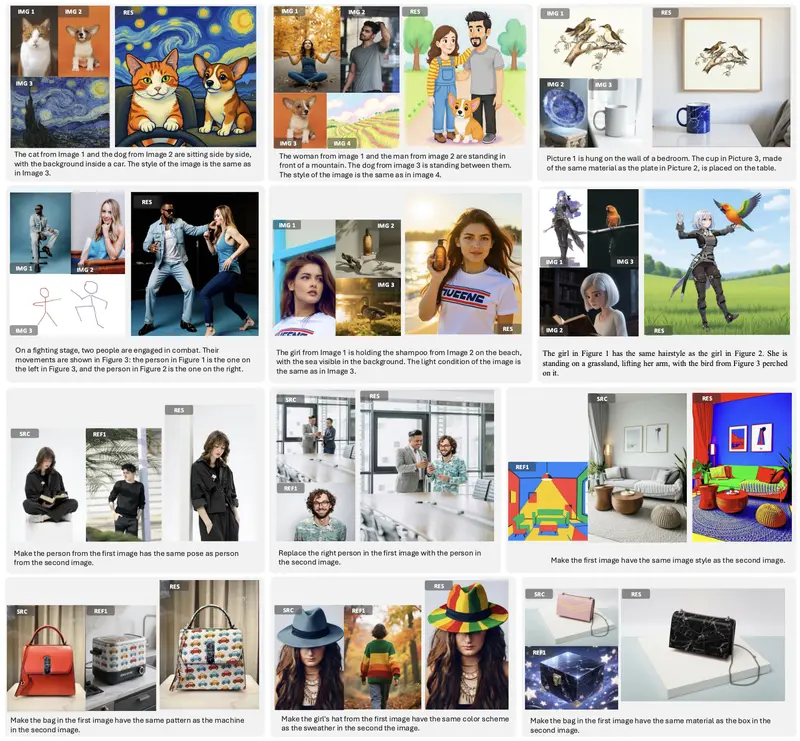
    DreamOmni2:支持图文指令的统一图像生成与编辑模型

    DreamOmni2:支持图文指令的统一图像生成与编辑模型

    香港中文大学、香港科技大学与字节跳动联合推出开源模型 DreamOmni2,旨在突破当前 AI 图像编辑与生成的两大瓶颈:纯文本指令表达力有限,以及现有模型难以处理抽象概念(如风格、纹理、妆容等)。 ...
    图像模型# DreamOmni2# 图像生成
    1年前
    4400
    阶跃星辰发布 NextStep-1:140 亿参数自回归模型,用“连续令牌”重塑图像生成

    阶跃星辰发布 NextStep-1:140 亿参数自回归模型,用“连续令牌”重塑图像生成

    在图像生成领域,自回归模型长期被视作“文本专家,视觉弱项”——它们擅长逐词生成语言,却难以像扩散模型那样精细构建图像。而如今,阶跃星辰(StepFun)正试图打破这一边界。 GitHub:https...
    图像模型# NextStep-1# 图像生成# 图像编辑
    1年前
    7870
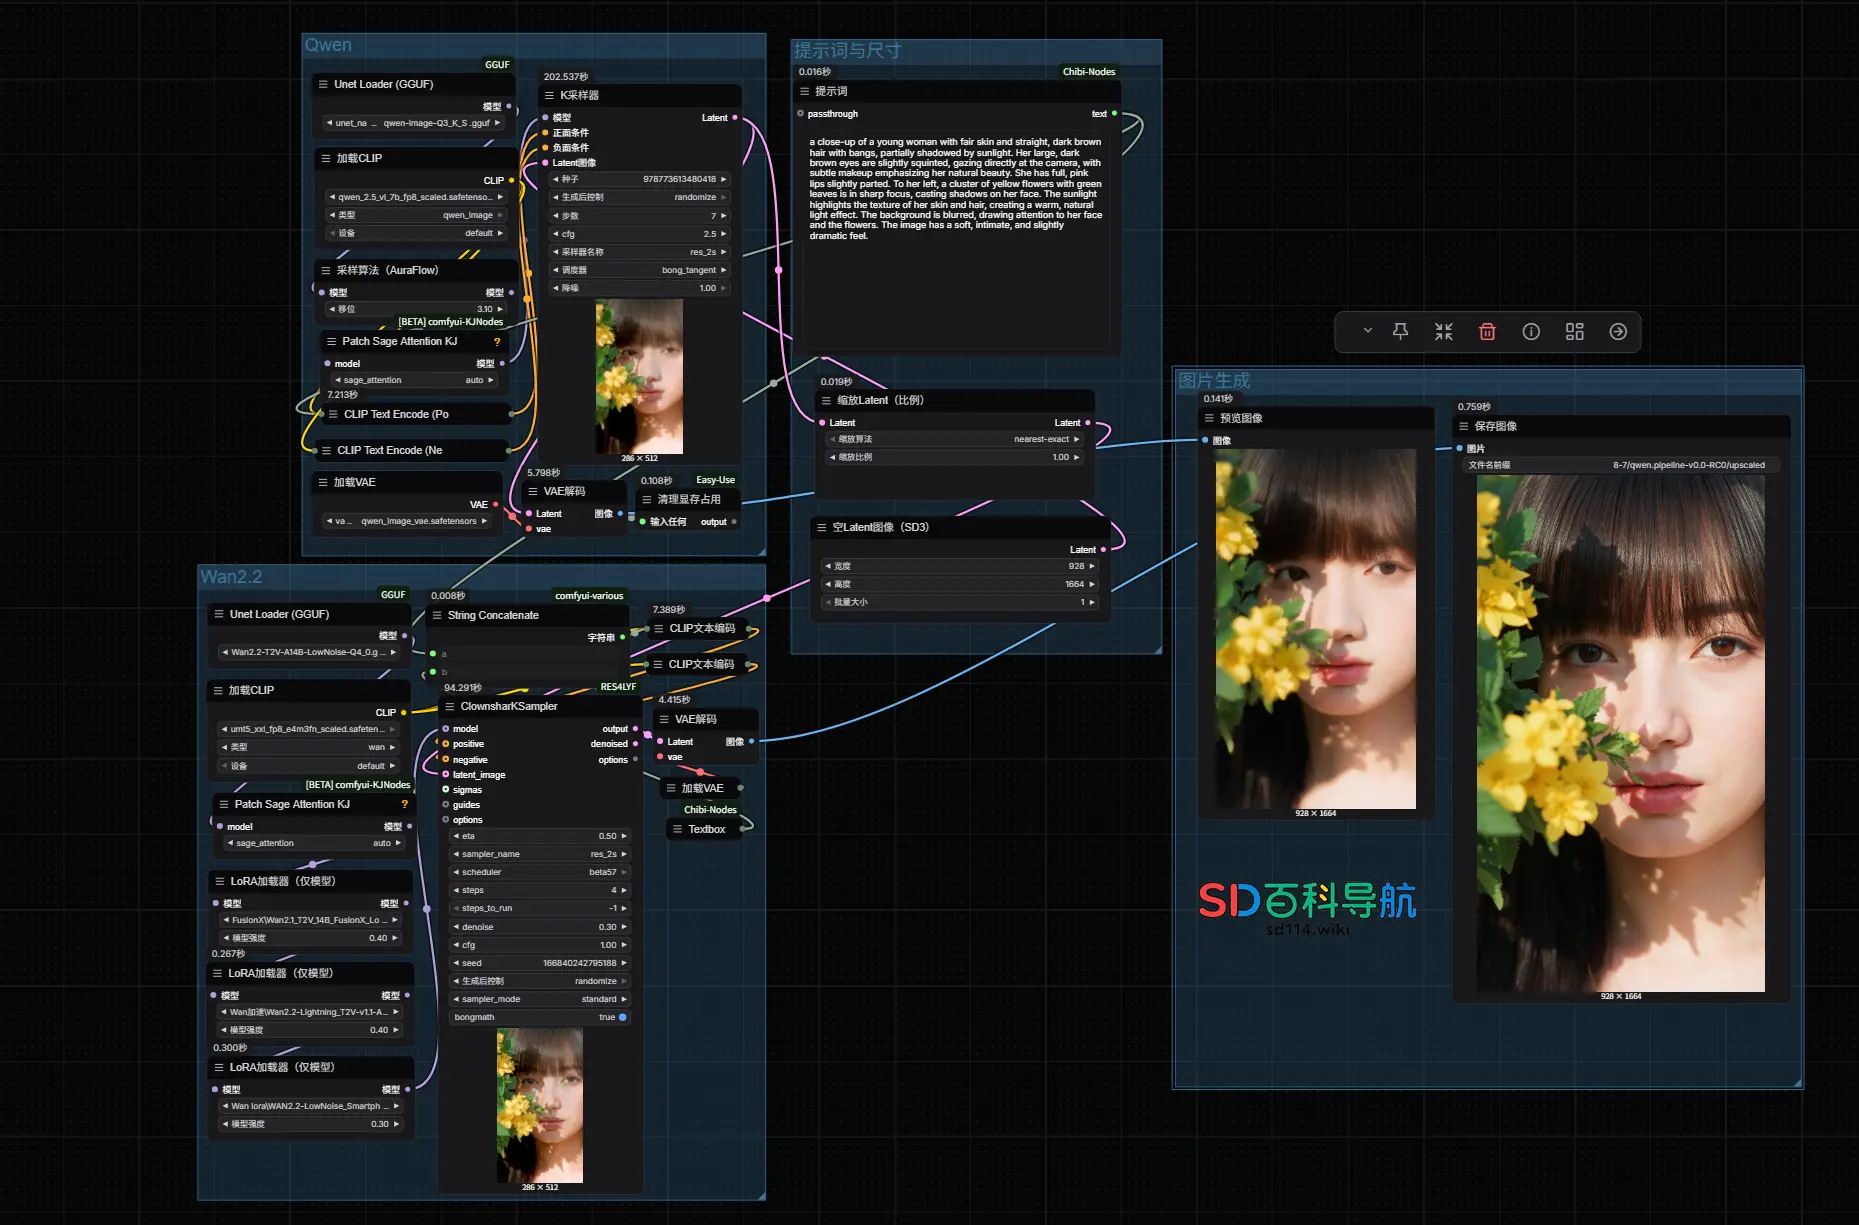
    如何兼顾“创意”与“真实”?用 Qwen-Image + Wan 2.2 实现高质量图像生成

    如何兼顾“创意”与“真实”?用 Qwen-Image + Wan 2.2 实现高质量图像生成

    阿里Qwen项目组近期发布的两款模型Qwen-Image和Wan 2.2都具有图像生成功能,但两款模型在生成图片的时候具有局限性: Qwen-Image 擅长创意构图,想象力丰富,但人物细节 AI 感...
    工作流# Qwen-Image# WAN 2.2# 图像生成
    1年前
    2,1140
    WAN 2.2 图像生成 + 高分辨率修复工作流指南

    WAN 2.2 图像生成 + 高分辨率修复工作流指南

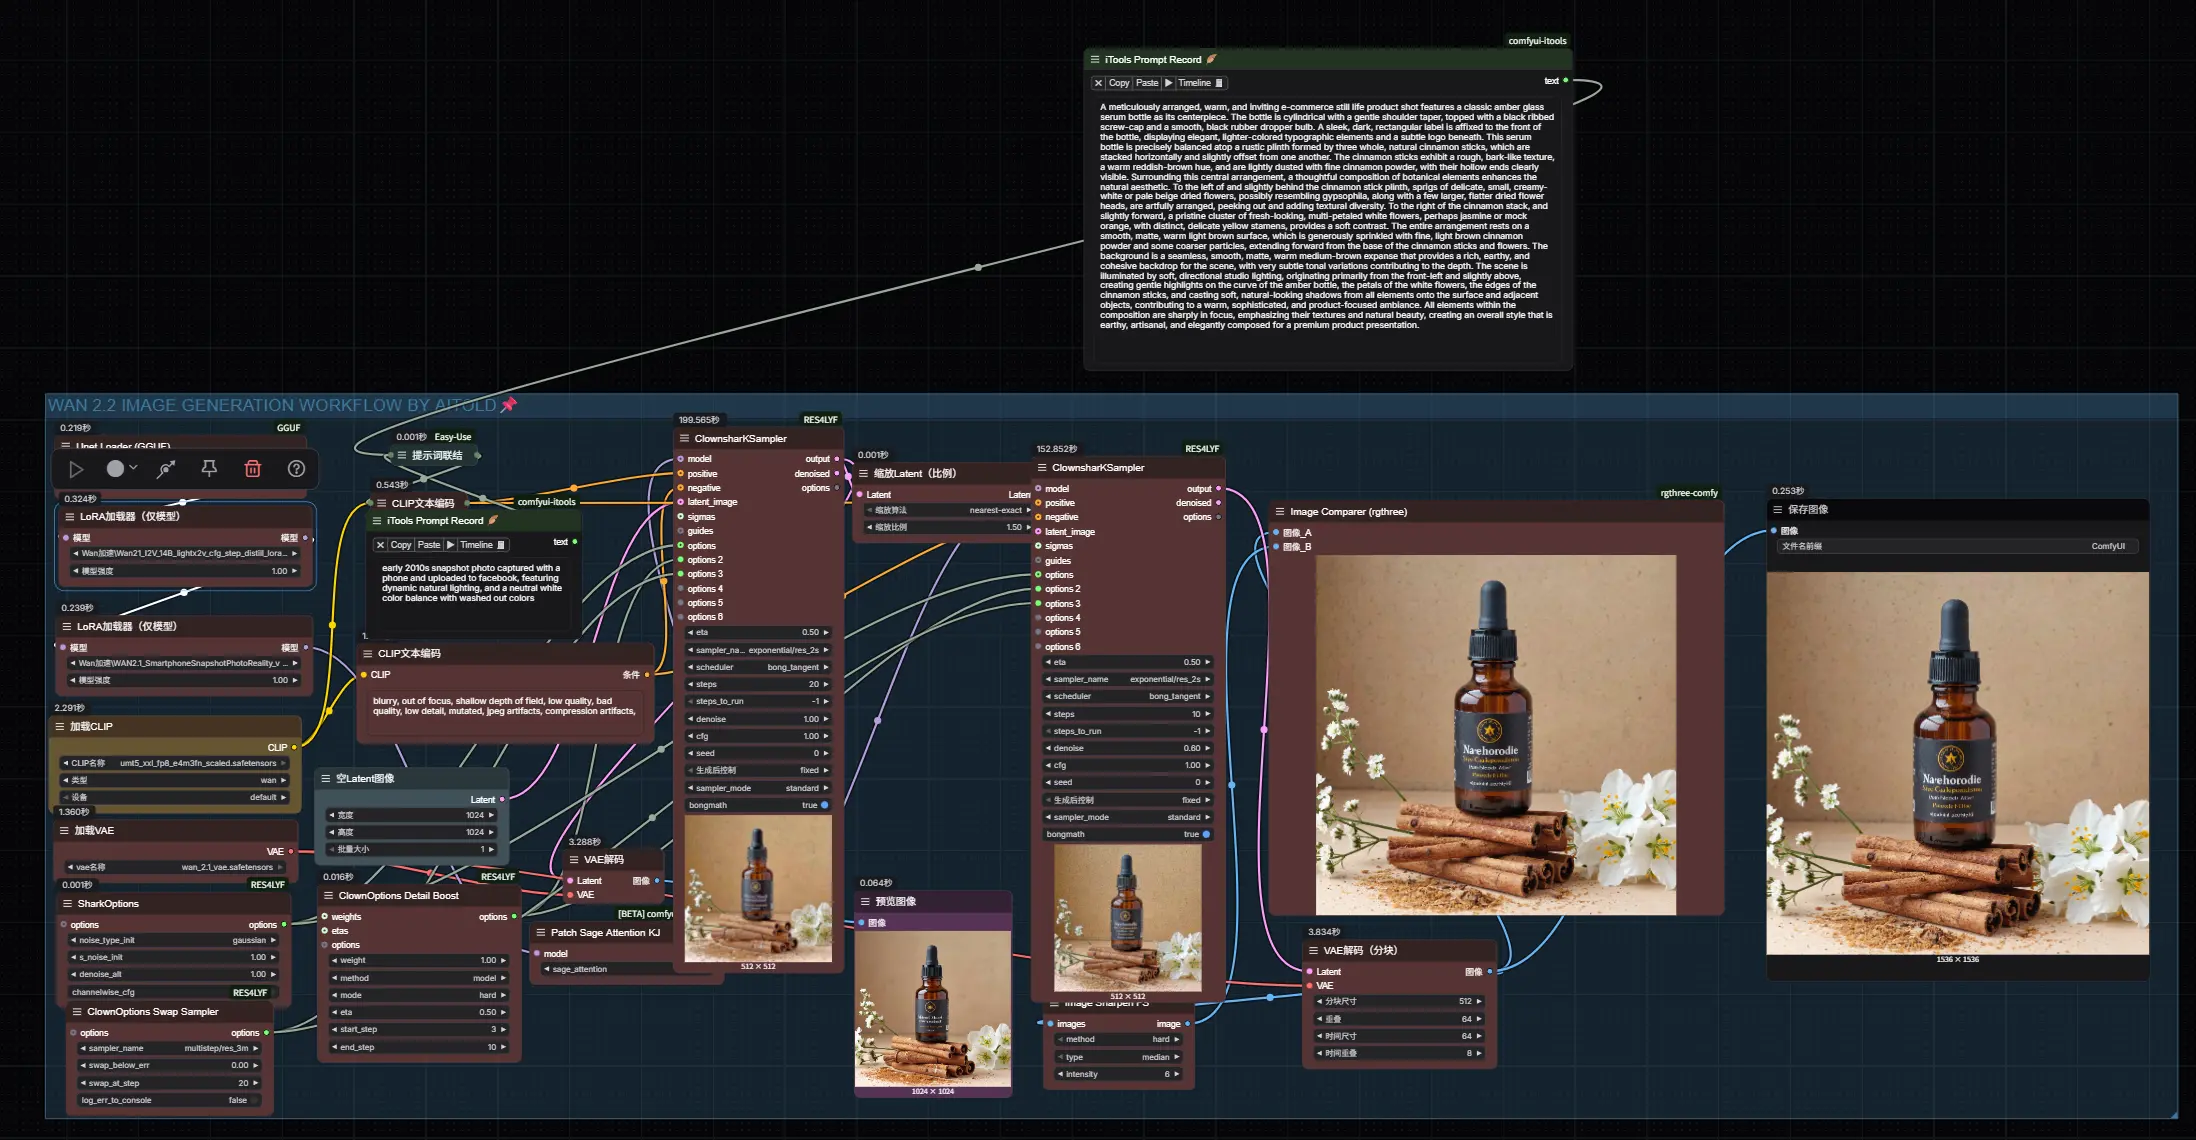
    尽管阿里发布的 WAN 2.1 和 WAN 2.2 主要定位为视频生成模型,但其强大的视觉建模能力同样适用于高质量静态图像生成任务。 网盘下载:https://www.123865.com/s/hyQ...
    工作流# WAN 2.2# 图像生成
    1年前
    9830
    黑森林实验室联合 KREA AI 发布 FLUX.1 Krea [dev]: 实现更真实、更自然的图像生成

    黑森林实验室联合 KREA AI 发布 FLUX.1 Krea [dev]: 实现更真实、更自然的图像生成

    黑森林实验室(Black Forest Labs, BFL)与创意 AI 平台 KREA AI 正式宣布推出 FLUX.1 Krea [dev] —— 一个全新的开源文本到图像生成模型,也是 Krea...
    图像模型# FLUX.1 Krea [dev]# 图像生成# 黑森林实验室
    1年前
    9550
    统一视觉理解与生成框架UniWorld:支持 20+语义图片编辑任务

    统一视觉理解与生成框架UniWorld:支持 20+语义图片编辑任务

    北京大学深圳研究生院、鹏城实验室、兔展AI的研究人员推出统一视觉理解与生成框架UniWorld,它基于强大的视觉-语言模型和对比语义编码器,能够同时处理图像感知和图像操控任务。 GitHub:http...
    图像模型# UniWorld# 图像生成# 图像编辑
    1年前
    7120
    基于 ComfyUI 平台构建的协作式 AI 系统ComfyMind:打造稳定、灵活、可扩展的通用生成平台

    基于 ComfyUI 平台构建的协作式 AI 系统ComfyMind:打造稳定、灵活、可扩展的通用生成平台

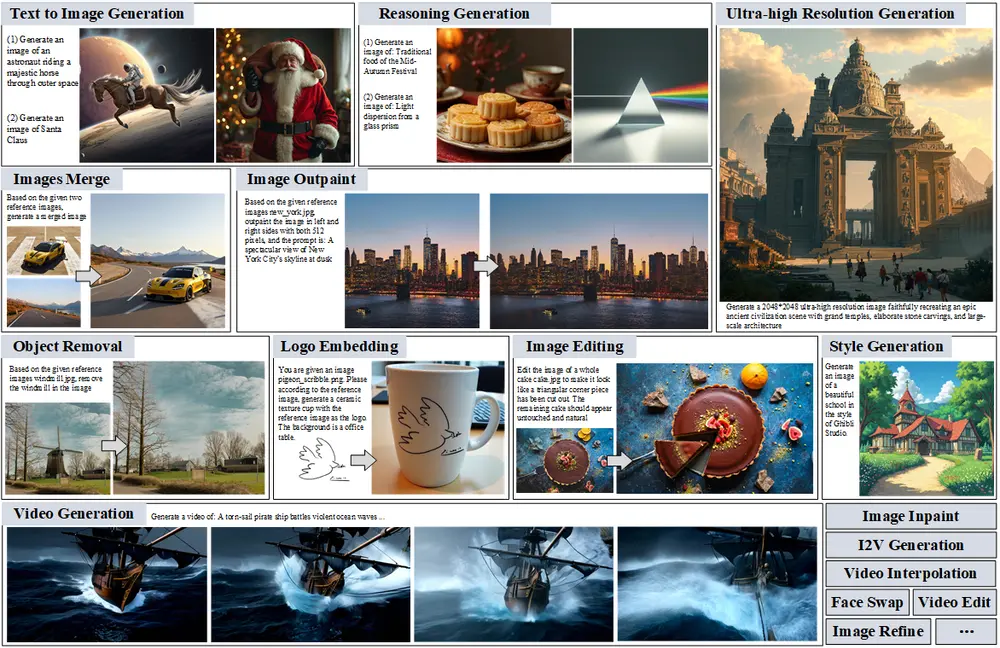
    随着生成模型的飞速发展,“通用生成(General-Purpose Generation)”正成为 AI 领域的新焦点。它旨在通过一个统一系统,支持图像、视频、文本等多种模态任务的生成与编辑,为复杂创...
    新技术# ComfyMind# 图像生成# 视频生成
    1年前
    5510
    谷歌提升Gemini 2.0 Flash图像生成和编辑功能的能力

    谷歌提升Gemini 2.0 Flash图像生成和编辑功能的能力

    基于开发者的热情反馈,谷歌激动地宣布,图像生成功能现已通过Gemini 2.0 Flash预览版推出。 开发者即日起可通过Google AI Studio和Vertex AI中的Gemini API...
    早报# Gemini 2.0 Flash# 图像生成# 谷歌
    1年前
    5910
    Meta AI 推出高效图像生成新方法Token-Shuffle:在 Transformer 中减少图像 Token

    Meta AI 推出高效图像生成新方法Token-Shuffle:在 Transformer 中减少图像 Token

    自回归(AR)模型在语言生成领域取得了巨大成功,但在高分辨率图像合成中的应用却面临严峻挑战。与文本不同,图像需要数千个 token 来表示,导致计算成本呈二次方增长。这使得大多数基于 AR 的多模态模...
    新技术# Meta AI# Token-Shuffle# 图像生成
    2年前
    4710
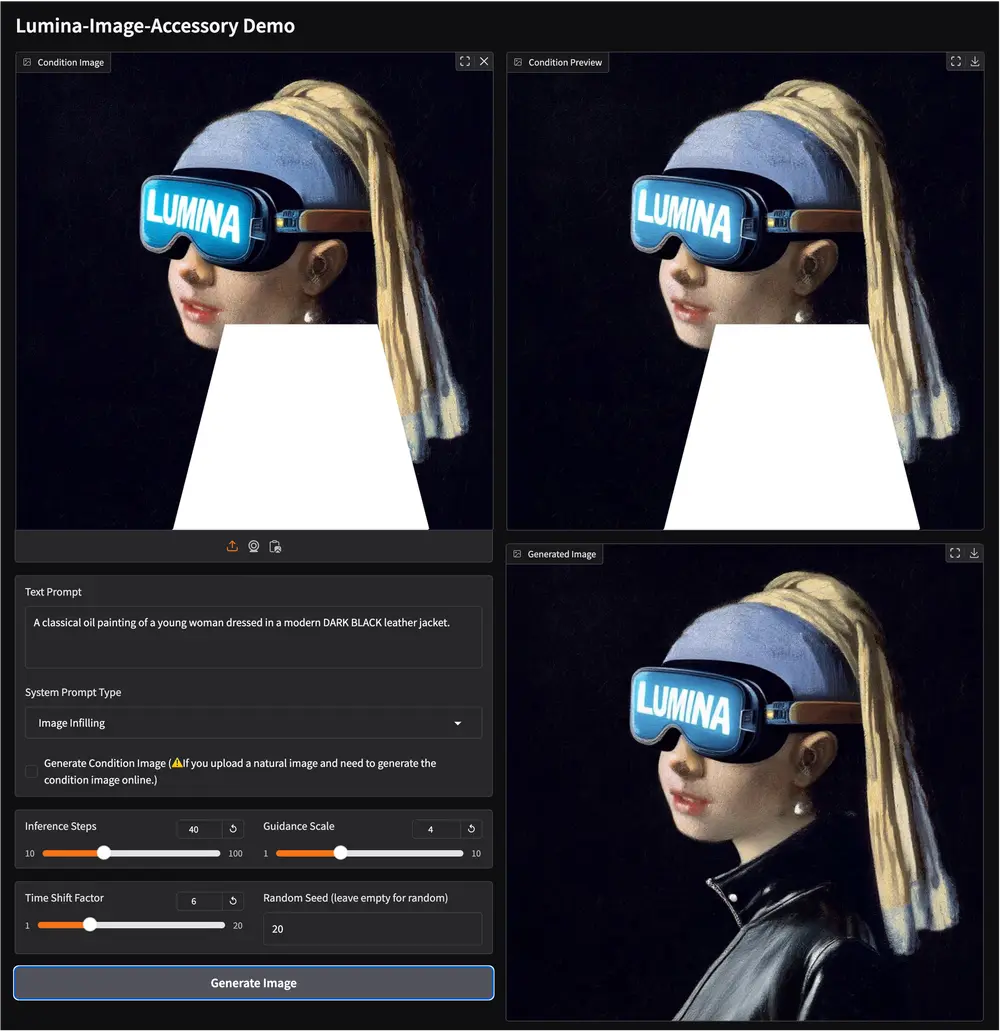
    Lumina-Accessory:专为 Lumina 系列模型设计的多任务指令微调框架

    Lumina-Accessory:专为 Lumina 系列模型设计的多任务指令微调框架

    Lumina-Accessory 是一个专为 Lumina 系列模型设计的多任务指令微调框架,目前支持 Lumina-Image-2.0。该框架通过一系列创新设计,为图像生成和编辑任务提供了强大的支持...
    图像模型# Lumina-Accessory# Lumina-Image 2.0# 图像生成
    2年前
    6250
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    天府智能体 (Tianfu Agent) 

    天府智能体 (Tianfu Agent) 

    天府智能体 (Tianfu Agent) 作为全球首个专为深度命理推理设计的智能体,它并非简单的聊天机器人,而是一个融合了紫微斗数、子平八字、奇门遁甲三大传统术数体系的复杂 AI 系统。
    ITELLOU

    ITELLOU

    ITELLYOU(也称为NEXT, ITELLYOU)是一个专注于提供微软原版软件资源的非官方网站,主要帮助用户获取未经修改的微软产品镜像,如Windows操作系统、Office办公软件和开发工具等。
    TapNow

    TapNow

    TapNow是一个面向创作者的专业级 AI 视觉内容平台,支持从脚本撰写、分镜头设计到高保真成片输出的完整流程,单人即可在 1–3 天内完成传统需 4–6 周的影视级项目。
    Open ASR 排行榜

    Open ASR 排行榜

    Open ASR 排行榜 对 Hugging Face Hub 上的语音识别模型进行排名和评估。我们报告平均 WER(字错误率)(⬇️ 越低越好)和 RTFx(实时因子)(⬆️ 越高越好),模型根据其平均 WER 从低到高进行排名。
    Meshy

    Meshy

    Meshy 是一款非常适合初学者和专业用户的 3D 模型生成工具。无论是快速建模、3D 打印还是动画设计,它都能轻松应对。如果你对 3D 模型创建感兴趣,不妨试试 Meshy,让生成式 AI 为你的创意插上翅膀!
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      天府智能体 (Tianfu Agent) 

      天府智能体 (Tianfu Agent) 

      天府智能体 (Tianfu Agent) 作为全球首个专为深度命理推理设计的智能体,它并非简单的聊天机器人,而是一个融合了紫微斗数、子平八字、奇门遁甲三大传统术数体系的复杂 AI 系统。
      ITELLOU

      ITELLOU

      ITELLYOU(也称为NEXT, ITELLYOU)是一个专注于提供微软原版软件资源的非官方网站,主要帮助用户获取未经修改的微软产品镜像,如Windows操作系统、Office办公软件和开发工具等。
      TapNow

      TapNow

      TapNow是一个面向创作者的专业级 AI 视觉内容平台,支持从脚本撰写、分镜头设计到高保真成片输出的完整流程,单人即可在 1–3 天内完成传统需 4–6 周的影视级项目。
      Open ASR 排行榜

      Open ASR 排行榜

      Open ASR 排行榜 对 Hugging Face Hub 上的语音识别模型进行排名和评估。我们报告平均 WER(字错误率)(⬇️ 越低越好)和 RTFx(实时因子)(⬆️ 越高越好),模型根据其平均 WER 从低到高进行排名。
      Meshy

      Meshy

      Meshy 是一款非常适合初学者和专业用户的 3D 模型生成工具。无论是快速建模、3D 打印还是动画设计,它都能轻松应对。如果你对 3D 模型创建感兴趣,不妨试试 Meshy,让生成式 AI 为你的创意插上翅膀!
      查看完整榜单