MiniMax H3 Image Studio 是一个专为 ComfyUI 设计的社区开源项目,将 MiniMax H3 这一原生音视频模型适配为高效的文本生成图像 (T2I)、图像生成图像 (I2I) 及 REF2VA 参考编辑工具。该版本通过提供真实的 UI 工作流、优化的采样配方以及详细的文档卡片,解决了此前用户面临的“空白画布”和配置模糊问题。
- GitHub:https://github.com/astropuzzo/ComfyUI-MiniMax-H3-Image-Studio
核心更新
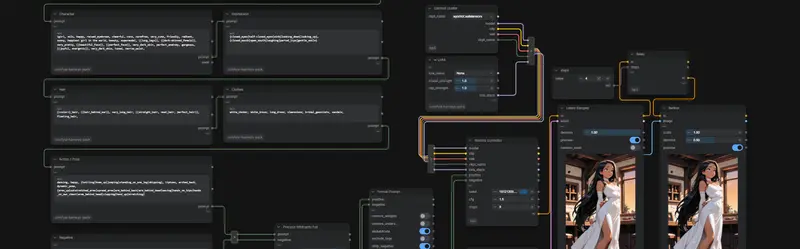
- 真实 UI 工作流:不再仅依赖 API JSON,而是提供可直接拖入 ComfyUI 的 PNG 工作流文件(嵌入元数据),确保开箱即用。
- LightX v0.1 采样配方:弃用模糊的通用 Turbo 选项,引入针对适配器优化的
ER-SDE和SA-Solver配方,支持 4 步快速生成。 - 智能帧解码:
Exact Frame Decode节点默认推荐第 0 帧作为静态输出,同时保留完整的时间包上下文,避免盲目跳过关键帧。 - AV 兼容性垫片:为旧版 ComfyUI 核心提供
ModelSamplingDiscreteFlow兼容层,确保音频-视频潜空间契约在纯图像生成中依然稳定。 - 文档化体验:每个工作流均附带可编辑的
Workflow Note卡片,涵盖快速开始、模型选择、设置原理及实验路径。
安装与依赖
- 系统要求:ComfyUI 0.30.0 或更新版本(推荐最新稳定版以支持 H3 及新采样器)。
- 安装方式:
- ComfyUI Manager:搜索
MiniMax H3 Image Studio或运行comfy node install minimax-h3-image-studio。 - Git:克隆至
ComfyUI/custom_nodes目录并重启。
- ComfyUI Manager:搜索
- 模型准备:需自行下载 FL2VA/REF2VA 扩散模型、Qwen 文本编码器、H3 视频 VAE 及可选的 LightX LoRA。
工作流概览
| 工作流类型 | 适用场景 | 核心节点 |
|---|---|---|
| Text to Image | 从零生成静态图像 | Text to Image, FL2VA |
| Image to Image | 基于首帧锚点进行指令编辑 | Image to Image, FL2VA |
| Reference Edit | 多参考图特征融合与替换 | Reference Edit, REF2VA |
| I2I · LightX | 高速高质量重绘 | FL2VA + LightX LoRA, ER-SDE/SA-Solver |
关键配置建议
- 帧配置与静态选择:
- H3 即使生成单张图像也需要处理时间包。推荐使用 5 帧(默认)或 9 帧(扩展质量)。
Single Image Output节点默认使用recommended_index(通常为第 0 帧),也可根据清晰度或源相似性指标手动选择最佳帧。
- 采样配方:
- 基础质量:
res_multistep+simple调度器,20 步。 - 高速生成:加载
LightX v0.1 LoRA,使用er_sde或sa_solver采样器,仅需 4 步。
- 基础质量:
- 参考编辑 (REF2VA):
- 提示词应明确区分角色,例如:“保留 <图1> 的人物与背景,仅使用 <图2> 替换服装”。
source_fidelity参数有助于加强保留语言,但不能替代清晰的提示词逻辑。
- 分辨率与内存:
- 分辨率按 32 像素网格对齐。直接生成 8MP 图像会显著增加显存与时间成本。
- 建议在 2MP 左右进行生成,必要时再通过后期放大。
注意事项
- 实验性性质:H3 的图像能力是从视频模型改编而来,上游实现仍在快速迭代。更新 ComfyUI 或相关节点前请备份工作流。
- GPU 验证:v15 发布时维护者无法进行完整 CUDA 生成测试,欢迎用户在 GitHub Issue #13 中反馈成功或失败案例。
- Larry Turbo 区别:Larryvrh 的 Turbo 实现与 LightX 不兼容,需使用其专用的加载器和采样器。
© 版权声明
文章版权归作者所有,未经允许请勿转载。