ComfyUI MiniMax H3 Extender 是一个专为 MiniMax H3 模型设计的自定义节点,解决生成长视频时的片段断裂问题。它通过整合运动上下文、磁盘缓存、动态图像/音频参考以及无缝解码技术,帮助用户生成视觉连贯、动作流畅且音画同步的长视频序列。
- GitHub:https://github.com/tritant/ComfyUI_MiniMax_H3_Extender
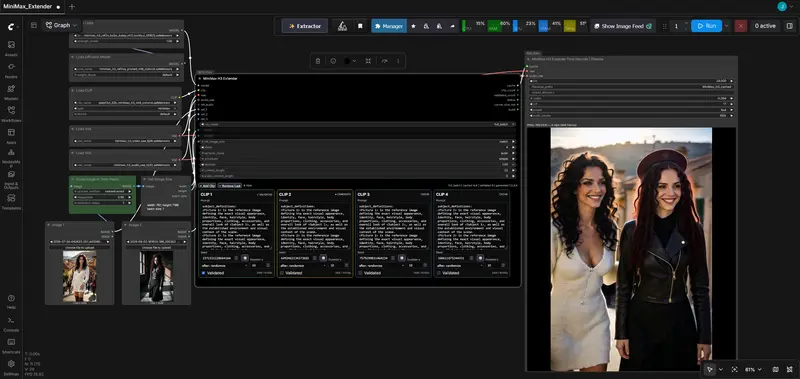
MiniMax H3 Extender 2.0.0
2.0.0 版本现已发布!
此版本引入了 FL2VA 支持。
它还包含重大的速度和内存优化,减少了 RAM/VRAM 使用量,加快了连续性处理,预览行为更流畅,并在更长的项目上性能得到改善。
项目保存/加载、预览恢复、片段连续性以及整体稳定性也得到了改进。
核心功能
- 🎬 多片段连续生成:支持将长视频拆分为多个短片段依次生成,并通过运动上下文(Motion Context)确保片段间的动作平滑过渡。
- 💾 磁盘缓存与断点续传:基于磁盘的潜空间缓存允许用户逐步构建视频。已验证的片段会被锁定并保存,后续生成可直接复用,无需重新采样,极大节省了计算资源。
- 🖼️ 动态参考一致性:支持最多 9 个图像参考和可选的音频参考。通过原生 Ref2VA 条件,确保角色身份、服装、环境及声音在整个序列中保持高度一致。
- 🔊 音画同步与校正:提供音频接缝校正和去咔嗒声功能,确保最终导出的视频在音频层面也保持连续自然。
- 🛠️ 灵活的种子与参数控制:支持随机、固定、递增或递减的种子模式,以及针对每个片段的独立提示词、时长和采样设置。
- 📦 多种导出格式:支持 H.264、H.265 (HEVC) 和 FFV1 无损格式导出,满足不同场景下的质量与体积需求。
关键技巧:Subject Definitions 块
为了在跨片段生成中保持极致的参考一致性,建议在每个片段提示词的开头插入一个 subject_definitions 块。这能明确告诉模型哪些参考图定义了角色外观,哪些定义了环境背景。
示例:
subject_definitions:
<Picture 1> 是定义 <Subject 1> 的精确视觉外观、身份、面部、发型、身体比例、服装、配饰和整体外观的参考图像,同时也是场景的既定环境和视觉上下文。
<Picture 2> 是定义 <Subject 2> 的精确视觉外观、身份、面部、发型、身体比例、服装、配饰和整体外观的参考图像。
<Subject 1> 是 <Picture 1> 中所示的同一位女性。
<Subject 2> 是她的朋友,即 <Picture 2> 中所示的同一位女性。
<Subject 3> 是 <Picture 1> 中建立的同一街道环境和场景上下文。
工作流:验证链机制
Extender 引入了“验证链”概念,确保生成的逻辑严密性:
- 生成片段 1 → 预览满意后点击 验证 (Validate)。
- 生成片段 2 → 模型会自动读取片段 1 的潜空间作为运动上下文 → 验证。
- 依此类推:若修改了片段 1 的参数,其后的所有片段将自动失效并需重新生成。
这种“生成 → 预览 → 验证 → 继续”的模式,让用户能够像搭积木一样稳健地构建长视频。
安装指南
- ComfyUI Manager:直接搜索
MiniMax H3 Extender并安装。 - 手动安装:
cd ComfyUI/custom_nodes/
git clone https://github.com/tritant/ComfyUI_MiniMax_H3_Extender.git
# 重启 ComfyUI
© 版权声明
文章版权归作者所有,未经允许请勿转载。