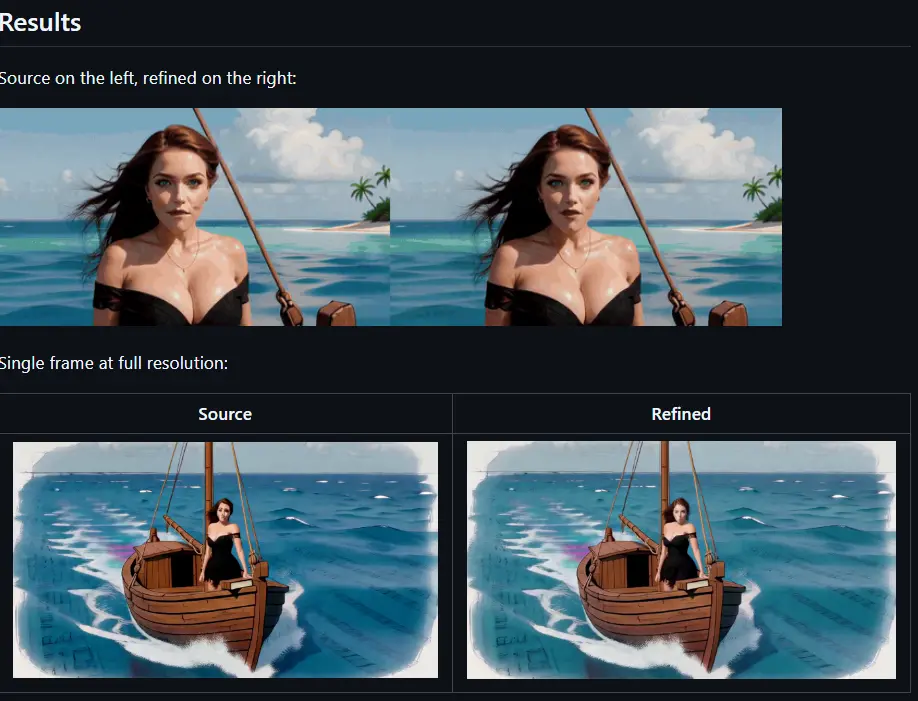
ComfyUI-H3-FaceRefine 是一组专为解决 MiniMax H3 视频中小尺寸面部质量差问题的自定义节点。核心机制是逐帧检测面部→裁剪至画布填充→H3重生成→精确合成回原视频,从静态图像FaceDetailer适配而来。需自备face_yolov8m.pt检测器,依赖Impact Pack(SAM工作流)、VideoHelperSuite、H3-NativeAudioLock(口型同步)等。提供矩形掩码与SAM真实形状两种工作流模板,内置动态去噪强度调节(小脸强合成/大脸弱保留)、身份追踪、轨迹平滑及颜色匹配。关键注意:H3为流匹配模型,去噪值不可迁移SDXL经验;帧数必须符合17k+5网格;成本随画布面积×帧数增长;onnxruntime仅可装一个变体避免GPU静默降级。
- GitHub:https://github.com/Carasibana/ComfyUI-H3-FaceRefine
核心问题与解决方案架构
为何H3小脸质量差?
- 根本原因:面部在画面中占比过小,而非输出分辨率不足(720p+仍存在)
- 技术限制:H3潜空间对微小区域细节编码能力有限,远距离人脸易模糊/失真
- 解决思路:将小脸放大至画布主体→利用H3最佳生成区间重绘→亚像素级合成回原位
端到端处理流水线
源视频 → Face Track+Crop → Inject Video Latent → Per-Frame Denoise
       → Sampler → VAEDecode → Stitch Back → 输出视频
              ↑                      ↑
        Transform(轨迹)      NativeAudioLock(人声)
- Transform核心作用:记录每帧裁剪来源坐标,确保合成时亚像素对齐
- 音频分离:人声轨道驱动口型同步,原始音频单独保存,避免重绘污染音轨
- 多人支持:每人独立流水线+identity_reference,串联缝合(前次输出作下次base_images)
关键节点功能与调参指南
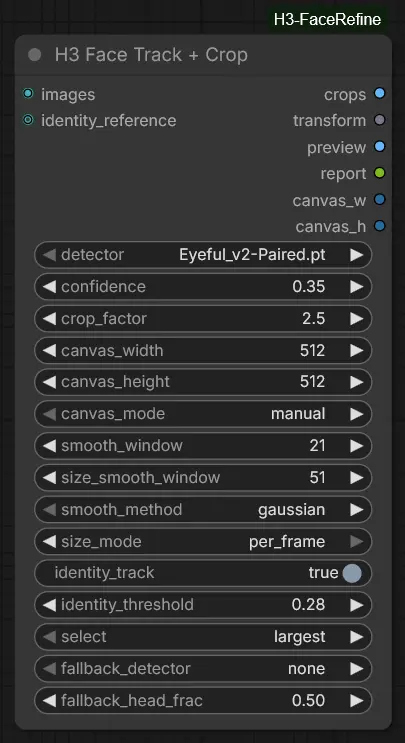
H3 Face Track + Crop(追踪与裁剪)
| 参数 | 推荐值 | 作用与调优 |
|---|---|---|
| crop_factor | 2.0–3.0 | 面部占裁剪区40%左右;↑提供更多上下文但放大倍数↓ |
| canvas_mode | auto_capped_768 | 自动适配最大裁剪尺寸且≤768;平衡质量与显存 |
| smooth_window | 21帧(~0.9s@24fps) | 中心轨迹平滑;抖动↑值,快速运动↓值 |
| size_smooth_window | 51帧 | 尺寸平滑防呼吸闪烁;故意大于中心窗口 |
| identity_threshold | 0.28 | 身份匹配阈值;过低误绑,过高丢失侧脸/遮挡帧 |
| fallback_detector | person_yolov8m-seg | 面部检测失败时用身体框推算头部位置,优于盲插值 |
⚠️ 必须连接canvas_w/h到H3节点:auto模式下尺寸由本节点决定,手动输入不一致将导致潜空间形状错误
H3 Per-Frame Denoise(动态去噪)
| 参数 | 默认 | 原理 |
|---|---|---|
| strength_small_face | 1.0 | 小脸全强度合成(无细节可保留) |
| strength_large_face | 0.35 | 大脸低强度保留真实细节 |
| face_px_small/large | 30/120px | 源像素面部高度阈值 |
| gamma | 1.0 | >1延迟降强,<1提前降强 |
| smooth_frames | 9 | 防相邻帧纹理跳动 |
🔥 H3去噪特殊规则:
- 流匹配+shift=12下,denoise=0.25对应有效sigma=0.800(重写帧!)
- 安全范围:0.02(sigma=0.197) ~ 0.15(sigma≈0.66)
- 禁用SplitSigmas:4步turbo调度最后点已达sigma=0.800
- 基础denoise与乘数需联合调优;绕过本节点时大幅降低基础值
H3 Face Stitch Back(合成)
| 参数 | 推荐 | 说明 |
|---|---|---|
| paste_region | face_only | 仅粘贴面部框(16%画布),避免头发/背景矩形痕迹 |
| feather | 矩形24/SAM4-8 | 源像素高斯模糊半径;SAM紧密需小羽化 |
| colour_match | 1.0 | 均值/标准差匹配防亮度差异 |
| undetected_frames | fade_out | 检测间隙渐隐合成,避免硬切或后脑幻觉 |
💡 SAM vs 矩形掩码选择:
- 矩形通常更优:接缝落在头发/背景,漂移不显眼
- SAM仅当轮廓精度至关重要时使用;需Impact Pack+SAMLoader
- 掩码输入必须是追踪器crops而非生成结果,否则侧面镜头鼻子露出
部署与依赖管理
必需组件
git clone https://github.com/Carasibana/ComfyUI-H3-FaceRefine.git ComfyUI/custom_nodes/
# Python包自动安装:ultralytics, scipy, insightface
模型清单
| 模型 | 路径 | 必要性 |
|---|---|---|
| face_yolov8m.pt | models/ultralytics/bbox/ | 必需 |
| MiniMax H3全套 | diffusion_models/text_encoders/vae/ | 必需(H3生成基础) |
| lightx2v_turbo LoRA | models/loras/ | 可选,大幅提速 |
| SAM模型 | models/sams/ | 仅SAM工作流 |
| InsightFace buffalo_l | models/insightface/ | 首次使用自动下载 |
⚠️ onnxruntime陷阱:
- 仅安装
onnxruntime或onnxruntime-gpu其一 - 混装会导致CPU包覆盖GPU版,身份匹配静默降级
- 验证:
python -c "import onnxruntime; print(onnxruntime.get_available_providers())"
示例工作流启动
- ComfyUI菜单 → Workflow → Browse Templates → 选”H3 Face Refine”(矩形版优先)
- 设置:Source clip / Ref image(s) / Vocals(人声) / Prompt / length(精确帧数)
- 首次运行保持默认,后续根据report调整
性能优化与故障排查
成本控制
- 成本 ∝ canvas² × frames;auto模式可能选超显存画布→RAM流式传输→速度暴跌
- 长片段建议手动设canvas或分段处理
- GGUF加载H3可适配12GB显存(示例工作流已配置)
常见问题速查
| 现象 | 原因 | 解决 |
|---|---|---|
| 缝合错位 | transform未连接/canvas不一致 | 检查连线;用Face Transform Info调试 |
| 面部闪烁 | size_smooth_window过小 | ↑至51+;确认size_mode=per_frame |
| 大脸被重写 | denoise过高/未用Per-Frame Denoise | ↓基础值;启用动态节点 |
| SAM掩码慢10-50x | SAMLoader AUTO模式未调prepare_device() | 本包已处理;自定义路径需手动调用 |
| 口型不同步 | 用了原始音频而非人声轨道 | 分离人声;NativeAudioLock接vocals |
| magnification<1.0x | 裁剪被缩小,细节丢失 | ↑canvas或跳过全程特写片段 |
帧数合规检查
H3要求帧数=17k+5(5,22,39…362)。生成片段已符合;若外部导入视频需预处理对齐。
© 版权声明
文章版权归作者所有,未经允许请勿转载。