现在AI生成3D场景已经很常见,但大部分方案生成出来的模型是一整块网格。场景里的桌子、杯子、椅子全部粘连在一起,没法单独选中、移动、删除物体,想导入游戏引擎或者三维软件二次修改基本行不通。
另外传统三维重建还有一个痛点:物体互相遮挡时,被盖住的模型部分会直接出现空洞;而现有的生成式3D工具,大多只能处理桌面少量物件,碰到堆满几十上百件物品的复杂空间,效果会断崖式下跌。
Alaya Lab推出的WorldSculpt,这是一套组合式三维场景生成框架。输入一段普通多视角拍摄的视频或者一组照片,就可以把整个复杂环境,拆成一个个独立的三维模型物件。
ComfyUI-WorldSculpt是一套基于ComfyUI Pixal3D / TRELLIS.2节点开发的第三方WorldSculpt的ComfyUI节点。不需要额外安装Python依赖,DINOv3+NAF、Shape DiT、VAE和网格后处理,全部复用comfy_extras/nodes_trellis2.py自带能力。
- GitHub:https://github.com/jtydhr88/ComfyUI-WorldSculpt
- WorldSculpt:https://github.com/AlayaLab/WorldSculpt
只需要输入多视角照片或者一段拍摄视频,WorldSculpt就能把整个场景拆解成一个个独立网格物件。每一件家具、摆件都是独立模型,统一放在同一个世界坐标中。就算物体之间相互遮挡,AI也会自动补全物体背面的结构。
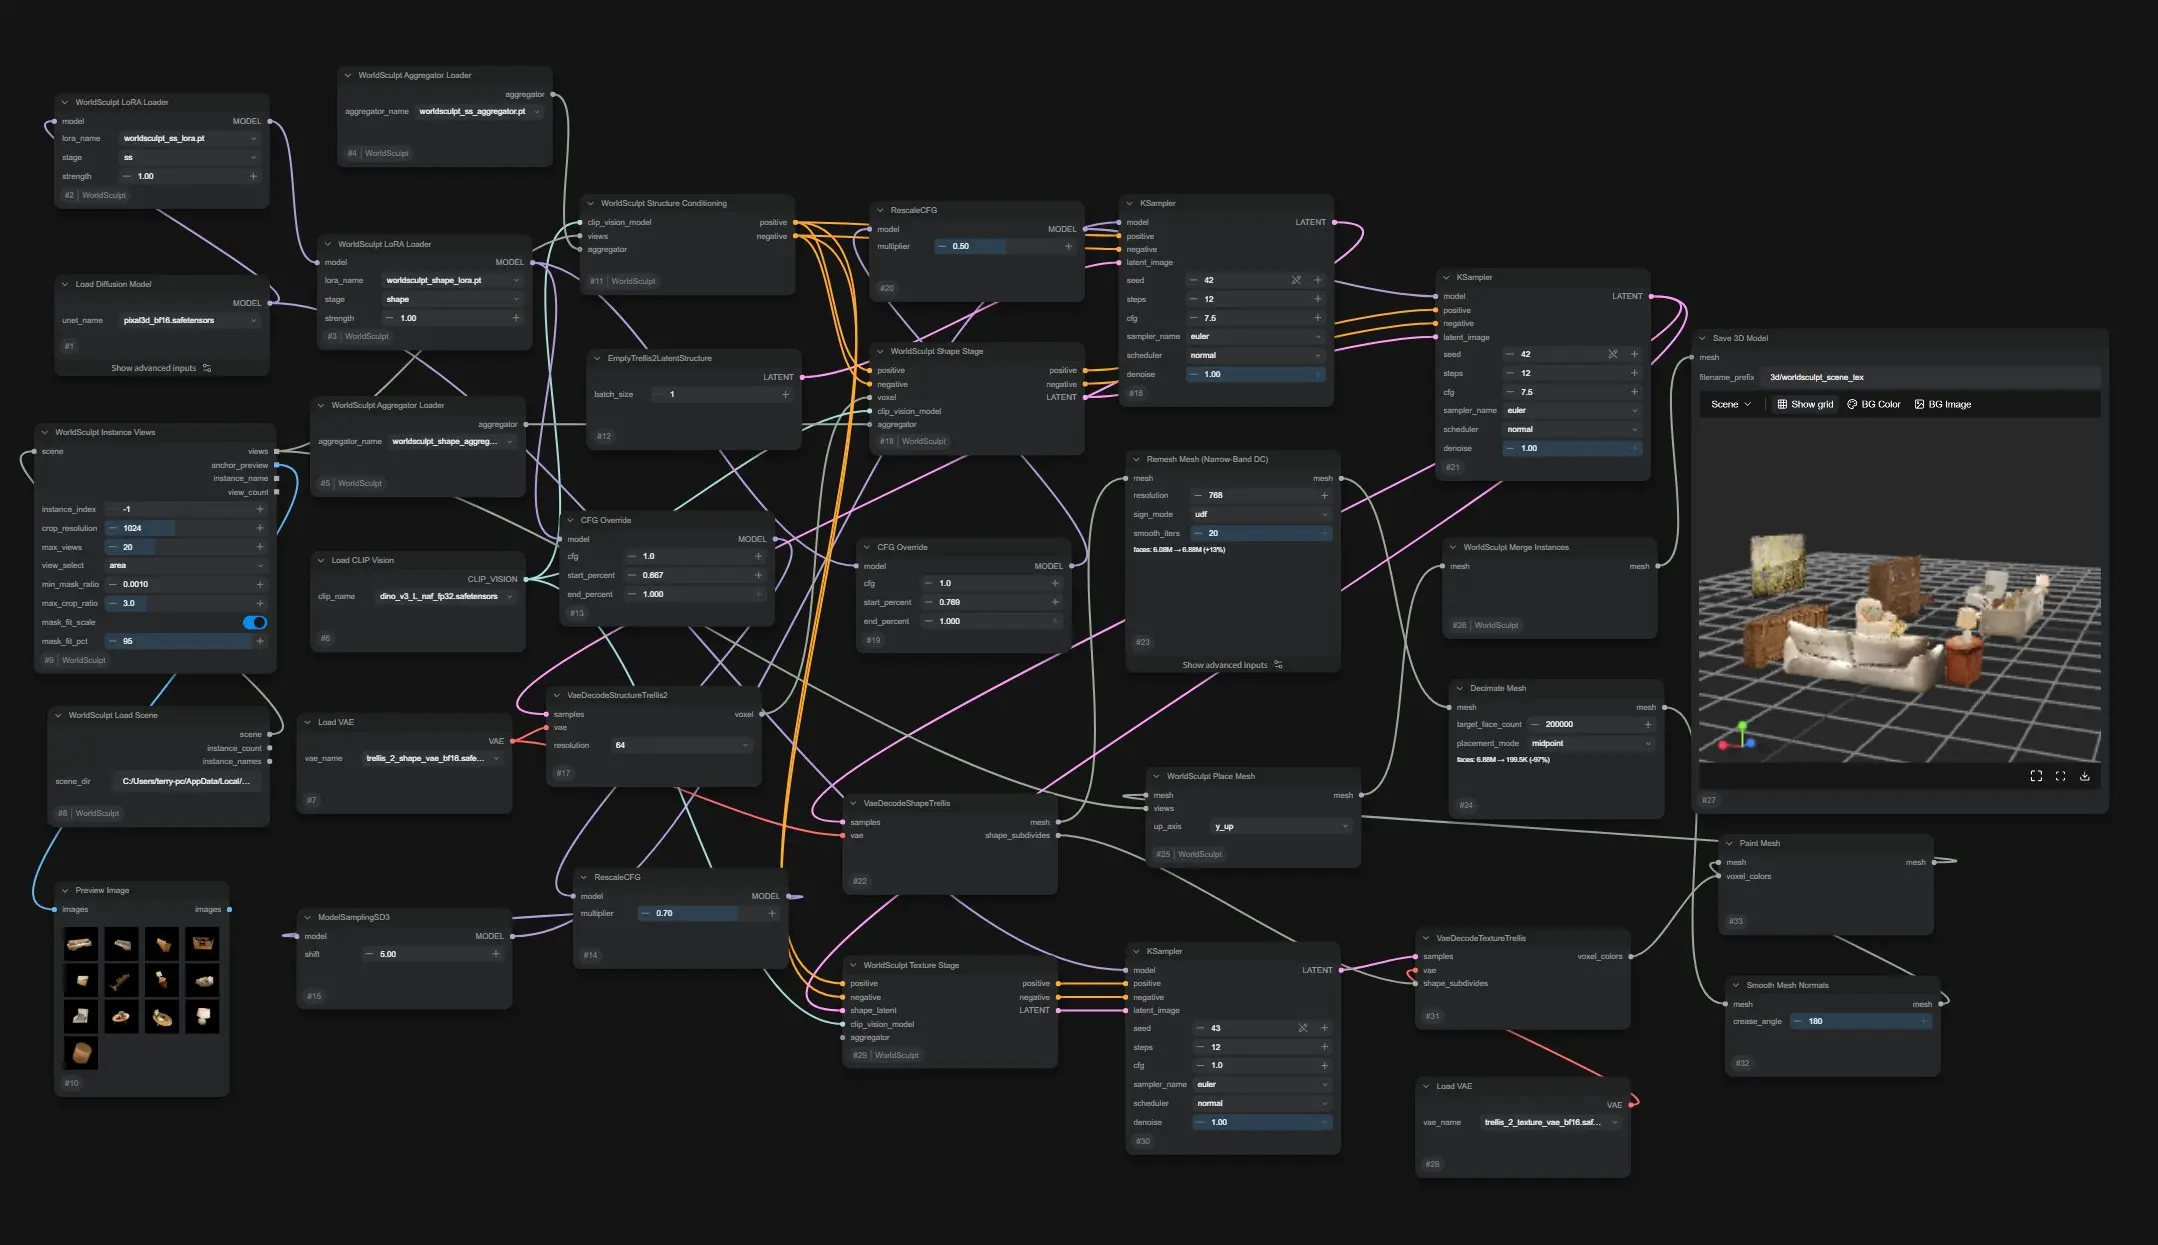
内置ComfyUI节点一览
| 节点名称 | 功能说明 |
|---|---|
| WorldSculpt Load Scene | 读取场景文件夹,加载transforms.json、画面帧与物体掩码 |
| WorldSculpt Instance Views | 根据相机参数,为场景里每一个物体单独裁切对应的画面 |
| WorldSculpt LoRA Loader | 加载多视角SS/Shape LoRA,适配Pixal3D基础模型 |
| WorldSculpt Aggregator Loader | 载入多视角特征聚合器 |
| WorldSculpt Structure Conditioning | 替换原生Pixal3D条件节点,融合多视角相机信息与聚合特征 |
| WorldSculpt Shape Stage | 替换Trellis2形状生成节点,完成物体几何结构生成 |
| WorldSculpt Texture Stage | 负责物体纹理生成,沿用原生Pixal3D纹理模型 |
| WorldSculpt Place Mesh | 将生成的网格放置到真实米制世界坐标系 |
| WorldSculpt Merge Instances | 收集全部独立物体网格,合并成完整场景 |
| WorldSculpt Scene From Estimates | 输入视频,通过Depth Anything3、SAM3自动检测物体、估算相机、深度,生成带3D包围盒的场景 |
模型获取与文件结构
模型存放路径:models/worldsculpt/
hf download AlayaLab/WorldSculpt --local-dir tmp
需要下载两组LoRA与聚合器权重:
- ss分支:
worldsculpt_ss_lora.pt、worldsculpt_ss_aggregator.pt - shape分支:
worldsculpt_shape_lora.pt、worldsculpt_shape_aggregator.pt
同时需要Pixal3D基础模型:pixal3d_bf16.safetensors、dino_v3_L_naf_fp32.safetensors、trellis_2_shape_vae_bf16.safetensors。
注意:LoRA不能搭配int8版本Pixal3D使用。
内置工作流
仓库workflows目录提供两套现成工作流:
worldsculpt_instance.json:单次只生成单个物体worldsculpt_scene.json:批量处理全部物体,逐个生成网格,最后合并导出GLB场景文件
完整管线逻辑:
加载Pixal3D模型 → 载入SS、Shape两套LoRA → 读取场景素材 → 裁切每个物体多视角画面 → 结构条件编码 → 采样生成物体几何 → 网格重网格化、减面 → 放置到世界坐标 → 全部物体合并 → 保存GLB。
可选开启纹理分支,生成物体顶点色;如果需要标准PBR贴图,则额外执行UV展开、贴图烘焙。
实拍视频重建工作流
worldsculpt_video.json支持直接导入视频做重建,不需要提前标注。
视频经过SAM3物体追踪、Depth Anything3深度估算,自动提取物体掩码、相机参数、深度信息,筛选有效帧,剔除漂移、低质量物体轨迹,生成场景包围盒,再接入上面的逐物体生成管线。
小提示:Depth Anything3推荐fp32精度加载;fp16会出现解码器数据类型报错。
实测效果与硬件参考
- Marble客厅场景:一共13个物体,每个物体取12个视角,RTX5090整机耗时6.5分钟。
- UE-MeshyScene场景:93个物体,265帧2560×1440素材,ComfyUI完整运行46分钟,输出1880万面合并GLB。93物体批量运算峰值占用56GB内存,低配机器建议拆分场景分批生成。
存在的局限
- 物体追踪容易出现识别偏差,比如墙板被识别成独立板材;
- 深色、半透明物体容易生成一团杂乱网格;
- 场景尺度依赖Depth Anything3估算,不一定是真实物理尺寸。
适合的使用场景
适合创作者、独立开发者快速制作可编辑3D场景,产出的GLB文件可以直接导入Unity、Unreal、Blender。可以单独挪动、删除场景内任意物件,解决传统AI场景模型无法二次编辑的痛点。
© 版权声明
文章版权归作者所有,未经允许请勿转载。