ComfyUI-H3-Continuum 是面向 MiniMax H3 模型的 ComfyUI 自定义节点,核心能力是分块生成长篇视频与配套音频。生成过程中可以逐段审查结果,不满意的片段单独重试,还能基于已保存的Take记录断点继续渲染。当前稳定版本为V3.9,旧版V3.8X2也保留可用。
- GitHub:https://github.com/ukr8b3g-cmyk/ComfyUI-H3-Continuum
安装更新方式
放置目录:ComfyUI/custom_nodes,模型与第三方节点不随包捆绑,需要自行准备。
- ZIP压缩包安装
下载节点压缩包,校验校验和后解压至custom_nodes,更新时直接覆盖旧文件夹,不要保留重复副本。重启ComfyUI,浏览器强制刷新(Ctrl+F5),加载V3.9工作流并选择模型与输入文件。更新不会覆盖本地工作流、Run/Take目录与配置。
- Git 命令安装
cd ComfyUI/custom_nodes
git clone https://github.com/ukr8b3g-cmyk/ComfyUI-H3-Continuum.git
已有Git版本更新:
cd ComfyUI/custom_nodes/ComfyUI-H3-Continuum
git pull --ff-only origin main
也可以使用ComfyUI-Manager一键更新。
环境最低要求:Python3.10+,ComfyUI 0.32.0+。
必需模型与依赖节点
MiniMax H3模型文件(自行下载)
| 组件 | 模型文件 | 存放路径 |
|---|---|---|
| H3扩散模型 | minimax_h3_fl2va_pruned_int8_convrot.safetensors | models/diffusion_models/ |
| 文本编码器 | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | models/text_encoders/ |
| 视频VAE | minimax_h3_video_vae_int8_convrot.safetensors | models/vae/ |
| 音频VAE | minimax_h3_audio_vae_fp32.safetensors | models/vae/ |
加载文本编码器时类型选择
minimax;视频VAE加载器选择INT8。V3.8X2使用另一套旧模型文件。
第三方自定义节点
- KJNodes:提供H3 SageAttention补丁,必选依赖
- rgthree-comfy:Power Lora Loader
- Spectrum:可选加速组件,默认在模板内禁用
- 可选:LightX2V Turbo LoRA,放到
models/loras/,用于Turbo采样工作流
工作流版本选择
| 工作流 | 格式 | 用途 |
|---|---|---|
| V3.9 | JSON/ZIP | 当前主推版本,支持固定参考图像槽位 |
| V3.9 Turbo Sample | JSON/ZIP | 自动采样,示例8秒舞蹈、泰语说唱场景 |
| V3.8X2 | JSON/合并ZIP | 历史保留版本,合并包内附带V3.9 |
V3.8X2工作流无法自动升级迁移到V3.9,新旧工作流分开保存使用。
基础生成流程
正式生成长序列前,建议先用2个分块做小测试验证环境:
- 加载H3扩散模型、文本编码器、采样器、VAE;
- 编写提示词,支持固定全局提示、分块独立提示、时间线指令三种模式;
- 图像生视频场景选择首图,设置分辨率;
- 块数量设为2,单块时长5秒,总时长10秒;
- 固定种子,开启「审查每块」和进度保存;
- 设置
从此重新生成为自动,点击队列开始生成。
两种生成模式:
- 逐块审查模式:生成一块就暂停,等待人工确认,可选择重试当前片段;
- 完整一次性生成:连续渲染全部片段,适合不需要中间校验的场景。
片段审查、重试与断点续跑核心操作
| 操作 | 作用 |
|---|---|
| 使用它并继续 | 保留当前合格片段,继续生成下一段 |
| 再次尝试此块 | 保留前面所有已完成片段,重新生成当前块,生成结果存入新Take |
| 使用它并完成其余 | 确认当前片段,一次性生成剩下全部内容 |
| 返回设置 / 返回审查 | 在设置面板和审查面板切换,不排队、不删除Take |
| 使用此Take | 直接读取历史保存的结果,不重新采样 |
| 从此处继续 | 在选中Take的基础上,向后继续生成后续片段 |
续跑时模型、LoRA、种子、提示词、分辨率、采样参数等配置必须保持一致,仅固定种子不足以保证连续性。
支持对指定序号块单独重生成:设置
从此重新生成 = 块N,可选择重建N到末尾所有片段。
提示词与参考图像规则
提示词模式分为全局固定提示、分块列表提示、时间线时序指令。
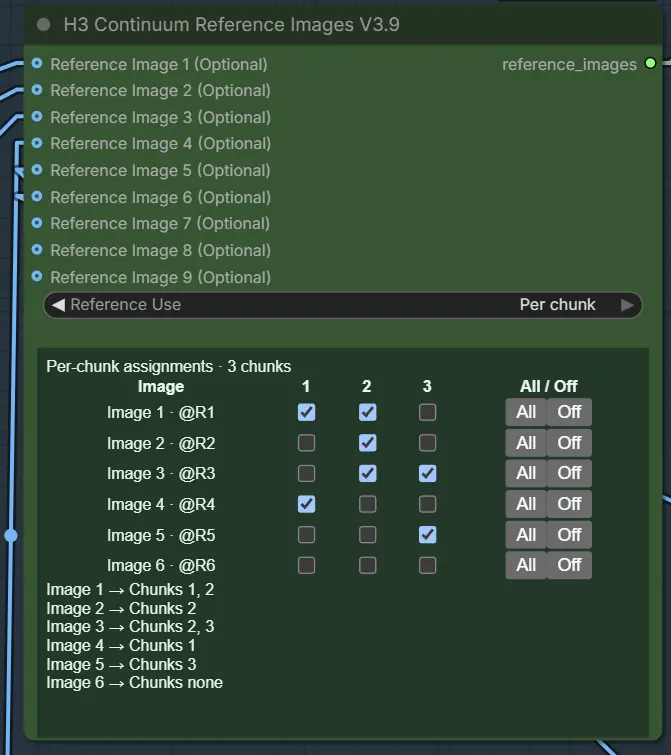
V3.9提供9个参考图像槽位,@R1代表1号参考图;首图、末图、参考图像、参考音频、驱动音频功能相互独立。
参考图像条件会占用显存,建议提前预处理图片尺寸。
存储、解码与第二遍细化
Run/Take生成记录单独保存,解码缓存可独立开启。在存储设置中配置临时目录,用于Finalize合并和解码缓存。
第二遍属于可选外部放大/细化链路,和分段重试机制相互独立;V3.9支持对已校验片段继承条件做二次处理。
兼容性边界与已知限制
兼容范围
- 旧Take记录可读取;v5版本历史无法自动升级;
- 仅在指定Spectrum、KJNodes版本下完成验证;测试环境:RTX 5060 Ti 16GB。
已知局限
- 参考计划检查器存在陈旧信息显示bug;
- 高分辨率、多参考图场景容易耗尽显存;
- 长视频连续性无法保证完全一致的人物特征、唇形同步;
- 高倍率潜空间缩放容易出现画面伪影。
© 版权声明
文章版权归作者所有,未经允许请勿转载。