MiniMax‑H3原生单次生成存在镜头时长上限,做多段连续故事视频时,很容易出现人物外貌、服装、道具漂移,镜头衔接断裂,音频不同步的问题。
MiniMax‑H3‑Longvideos 这款ComfyUI自定义节点,只需要一份脚本,自动切分多镜头链路,最高生成约120秒视频并输出同步音频;依靠H3原生能力,同时支持FL2VA帧锚定、REF2VA参考图角色锁定,解决跨镜头角色崩坏、画风跳变。
- Hugging Face:https://huggingface.co/Smite79/MiniMax-H3-Longvideos
核心逻辑:H3一次渲染单个镜头,该节点把完整脚本拆解为一个个镜头节拍,根据剧情动作自动分配镜头时长;复用上一个镜头末尾帧做交接,持续维护角色、服饰、道具状态,避免跨镜头发生身份重置。
安装方式
把项目文件夹复制到 ComfyUI/custom_nodes/,重启ComfyUI服务端(仅刷新浏览器无效)。
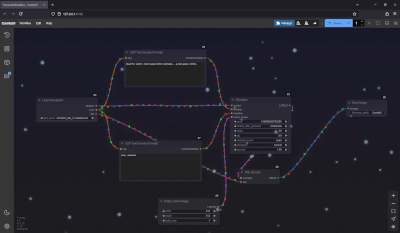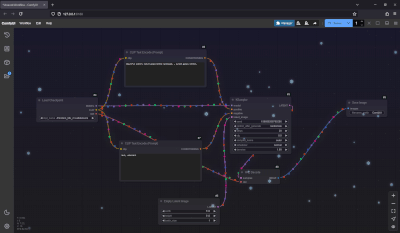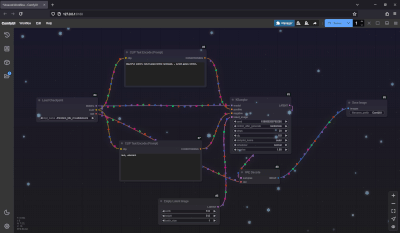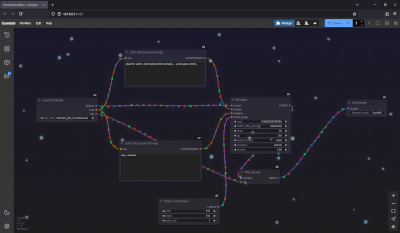
基础工作流示意
UNETLoader ─┐
CLIPLoader ─┼─> H3 Long Videos ─> images ─> Video Combine
VAELoader ──┘                     audio  ─┘
                                  latent ─>(可选)潜空间后处理
输出端口说明
images:拼接完成视频帧序列,送入视频合并节点audio:同步生成音频latent:拼接后的时间维度潜空间,可对接潜空间放大器;⚠️多镜头模式下潜空间和图像不完全一一对应,接缝裁剪仅作用在解码图像层;单镜头模式下完全匹配。soundscape:从脚本自动推导的环境音描述文本,可以接文本预览,也可以回连至global_soundscape输入锁定环境音,禁止系统二次推导。info:运行日志,输出镜头拆分、分辨率、风险警告,渲染前即可预览。
快速上手,仅需要填写四项核心输入
全部文本参数都是输入插槽,不要使用节点内置小文本框;
prompt为必填,未连接直接报错,不会生成空白内容。
- prompt 脚本提示词
第一段作为全局锚点,定义整体场景、光影、画风,所有镜头继承;之后每一个段落代表一个节拍,对应一个镜头。
示例:
自然光,强烈的阳光和深阴影。浅景深,背景柔和虚化。细腻的颗粒感,轻微的运动模糊,中性色彩。一个有谷仓的农场。
Dom 驾驶一辆面包车驶入车道,停在谷仓前。
Dom 下车,走到谷仓后面。
Mara 从谷仓里走出来,问他:“那是最后一趟了吗?”
- character_memory 角色记忆
定义出场人物外貌、穿着,节点全程追踪;服装增减会被脚本语义识别。
Dom = 他,高个子,35岁,深棕色头发,白色T恤,蓝色牛仔裤,工装靴
Mara = 她,30岁,红头发,灰色外套,黑色牛仔裤
- 分辨率 + megapixels百万像素预算
宽高比与像素预算相互独立,改变画幅不会改变算力开销。1.0 MP等价1024×1024总像素,是H3原生适配档位;降低MP可以节省显存、加速渲染,支持更长镜头。
注意:显示短边尺寸不能代表算力开销,超宽画幅、方形画幅实际像素预算差异巨大,以百万像素为准,输出会自动对齐32网格。
4. shot_seconds 镜头时长上限
接入H3 Shot Length节点,或者留空auto,由显存预算自动分配镜头时长。
💡优先打开 plan_only模式:只做脚本解析、镜头拆分、参数校验,不实际渲染,秒速预览全部风险警告,避免浪费算力。
节点内置大量自动防护逻辑
角色、服装、道具状态追踪
- 段落=镜头,不会自动合并段落;镜头时长由动作、台词复杂度自动计算。
- 角色首次出现记录外貌,后续重复名字自动转为代词,避免生成重复人物。
- 识别脚本语义完成衣物穿脱;道具跨镜头保持身份指代。
lock_restraints默认开启:手铐、锁链等束缚类道具属于剧情状态,不会因为脱下外套这类动作被意外移除;需要解除必须显式写wardrobe: Mara -= handcuffs。- 身体裸露区域持续追踪,防止人物转身时衣服莫名复原;支持
exposed_terms自定义描述词,也可以直接在character_memory声明topless / bottomless / nude初始状态。 prevent_nudity默认开启,不会主动生成裸露描述;info日志依旧会提示脚本触发的裸露状态。
多类防护Guard,弥补H3无CFG短板
MiniMax‑H3运行在CFG=1,否定提示词完全无效,全部约束依靠正向描述实现。
- anatomy_guard解剖防护:约束肢体数量、骨骼连接关系,减少畸形肢体;多人、低分辨率、加载LoRA时自动激活。
- solidity_guard实体防护:防止人物穿墙、物体互相穿透,只对脚本提到的实体生效。
- motion_guard运动防护:避免姿势突变,人物移动时补充运动路径描述,解决“瞬移、断颈”类画面。
- contact_guard接触防护:多人场景约束身体体积、上下方位、重量支撑关系,防止肢体错误分配、身体互相穿插。
音频与台词处理
auto_soundscape自动从锚点场景推导环境音,不会凭空生成人声对话。- 对话台词归属指定人物,同画面其余角色自动设置嘴唇闭合,解决所有人乱对口型。
- 无台词镜头做多层静音处理:文本约束、交接帧偏移、音频分支锚定静音,避免模型凭空生成语音。
allow_nonspeech_vocals开关:开启允许喘息、尖叫、抽泣这类非语言人声,依旧抑制随机对话。
镜头交接与渲染细节
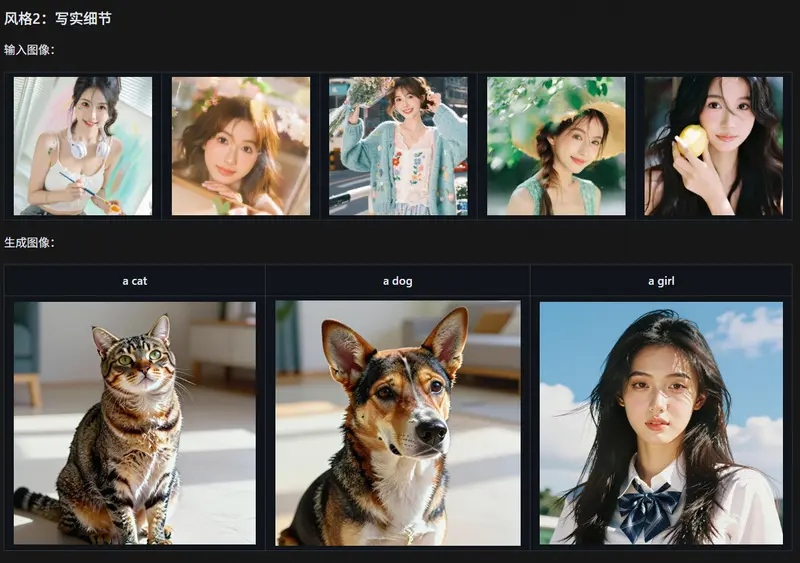
trim_seam默认开启:丢弃每个后续镜头第一帧,消除上一帧重复播放的接缝;排查问题时可以关闭。vary_seed_per_shot默认关闭:全局统一噪声场,保证颗粒、微纹理跨镜头统一;只有刻意想要每个镜头质感割裂时开启。- 参考图REF2VA支持最多4张参考图,脚本标记
<Picture 1>在指定镜头生效;同时保留上一帧作为帧锚定,参考图不会牺牲镜头连续性。
shift调度参数
移除旧版auto_shift;固定推荐shift_video=12,shift_audio=3,音频必须保持视频1/4比例,否则音频分支崩坏。适配蒸馏LoRA不要随意调低shift,会产生大量伪影。
日志输出info
渲染前后输出完整报告:镜头拆分、实际分辨率MP值、薄弱节拍、对话风险、裸露状态、LoRA匹配警告,提前规避坑点。
可选加速:Sol‑Attn稀疏注意力
第三方独立节点ComfyUI‑sol‑attn,专门针对H3优化稀疏注意力,长镜头链相比SageAttention速度提升。
⚠️必须配套SLA LoRA一起使用;普通LoRA搭配稀疏注意力会出现人物重复、崩坏;节点会在plan_only阶段检测组合不匹配并告警。
ComfyUI便携版Triton编译会缺失头文件,需要手动补充NuGet包内的include与lib文件才能正常启用。
版本依赖要求
- ComfyUI ≥0.31,推荐0.33;0.30版本音频shift行为异常
- 仅依赖Pillow(ComfyUI自带)
- H3为CFG=1,不支持否定提示词
- denoise固定等于1.0,不支持部分去噪,会破坏音视频同步
© 版权声明
文章版权归作者所有,未经允许请勿转载。