MiniMax H3 Image Studio :将MiniMax H3应用于图像生成与参考编辑MiniMax H3 Image Studio 是一个专为 ComfyUI 设计的社区开源项目,将 MiniMax H3 这一原生音视频模型适配为高效的文本生成图像 (T2I)、图像生成图像 (I2I...插件# MiniMax H3 Image Studio# 图像生成# 图像编辑2个月前2510
ComfyUI-Conditioning-Rebalance:解锁 Krea 2 与 Ideogram 4 的图像编辑潜能最新开源的Krea 2 和 Ideogram 4 以其卓越的画质和对提示词的精准理解而备受推崇。然而,这些模型通常内置了严格的安全过滤器,这在保护用户的同时,也限制了创作者在艺术表达、特定风格参考或复...插件# ComfyUI-Conditioning-Rebalance# Ideogram 4# Krea 24个月前4730
DirectEdit:武汉大学提出免训练图像编辑新范式,基于流模型实现“零误差”精准修图在文本驱动图像编辑领域,尽管免训练方法已取得显著进展,但“累积漂移”问题始终如影随形:传统方法在反演(加噪)和重建(去噪)过程中,因时间步长不匹配导致特征近似误差,最终造成背景失真或主体变形。 项目主...新技术# DirectEdit# 图像编辑6个月前2530
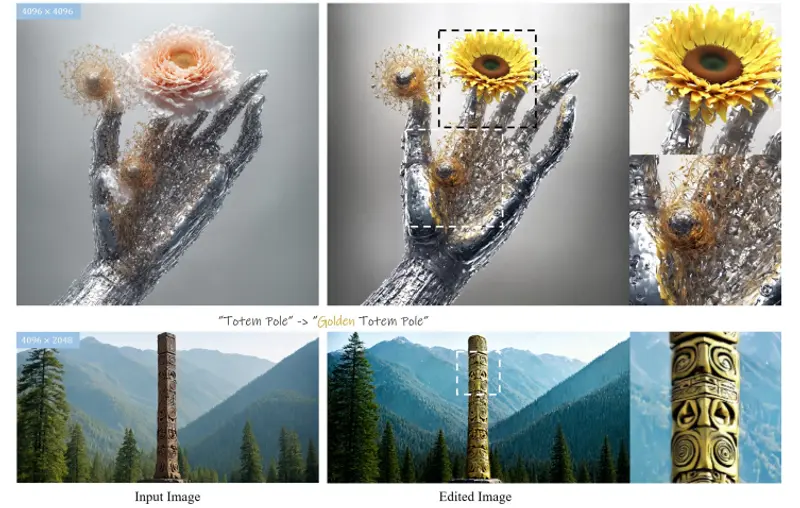
EditCrafter:无需微调的 4K 高分辨率图像编辑方法EditCrafter 是由 NC AI、Medipixel、MAUM.AI 和 EverEx 联合研究团队提出的一种创新性图像编辑方法。它突破了传统扩散模型受限于训练分辨率(通常为 512×512 ...新技术# EditCrafter# 图像编辑6个月前2120
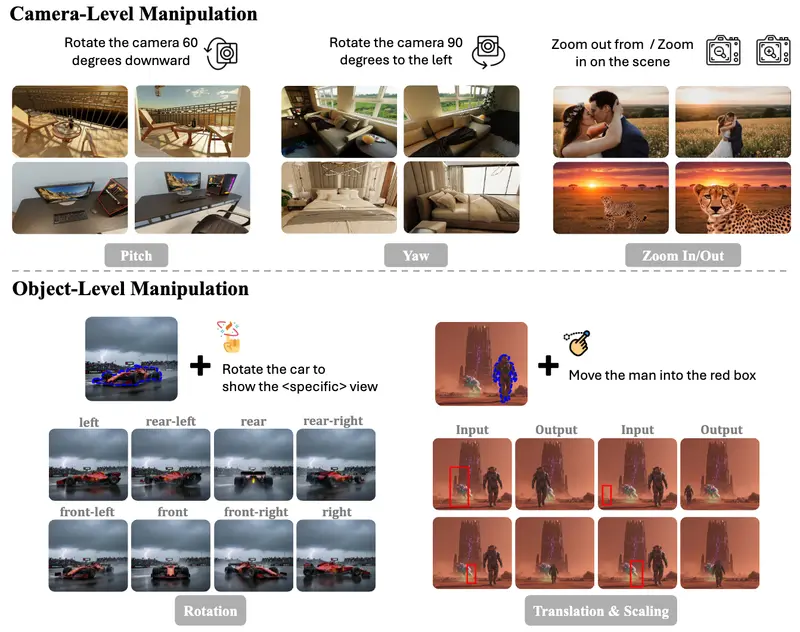
AI 修图终于“指哪打哪”:SpatialEdit 实现精准空间操控,告别画面扭曲现在的 AI 画图工具,大多有个“通病”:你让它“把车往左挪一点”,它可能给你换了一辆车;你让它“旋转 30 度”,它可能直接把车轮画歪了。 它们懂语义,但不懂空间。 最近,由香港大学、京东探索研究院...图像模型# SpatialEdit# 图像编辑7个月前2970
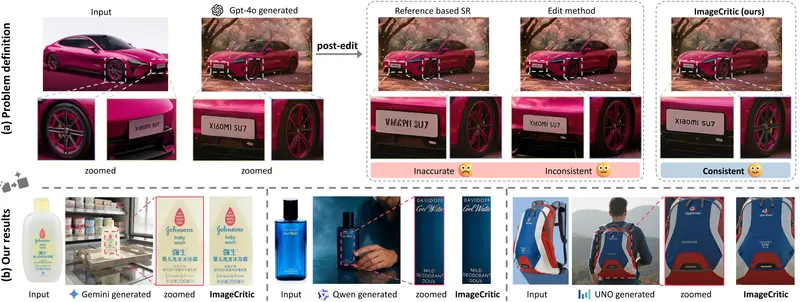
ImageCritic:AI 绘图的“细节质检员”,专治 Logo 变形与文字乱码的通用后处理方案在 AI 绘画飞速发展的今天,我们早已习惯了让模型根据文字描述创造出惊艳的画面,甚至能将特定的商品、宠物或角色无缝植入新场景。然而,一个长期存在的“老大难”问题始终困扰着专业应用:细节一致性。 当你试...图像模型# ImageCritic# 图像编辑8个月前2970
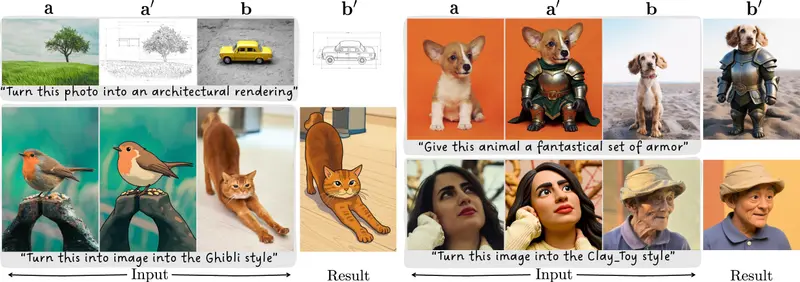
LoRWeB:AI 图像编辑新范式,只需“看一眼”就能学会任何修图技巧想象这样一个场景:你看到朋友的照片戴着一副酷炫的墨镜,效果极佳。你也想给自己的照片加上同款墨镜,但你既不会使用复杂的 Photoshop,也难以用文字精确描述“想要什么样的墨镜、戴在什么位置、光影如何...图像模型# LoRWeB# 图像编辑8个月前2580
FIBO Edit 上线 ComfyUI:基于授权数据的 JSON 原生图像编辑,商业使用安全ComfyUI 官方宣布,Bria AI 的 FIBO Edit 模型现已通过合作伙伴节点集成至 ComfyUI。这是一款专为生产环境设计的图像编辑模型,其最大亮点在于:完全基于 100% 授权数据训...工作流# BRIA AI# FIBO Edit# 图像编辑9个月前4150
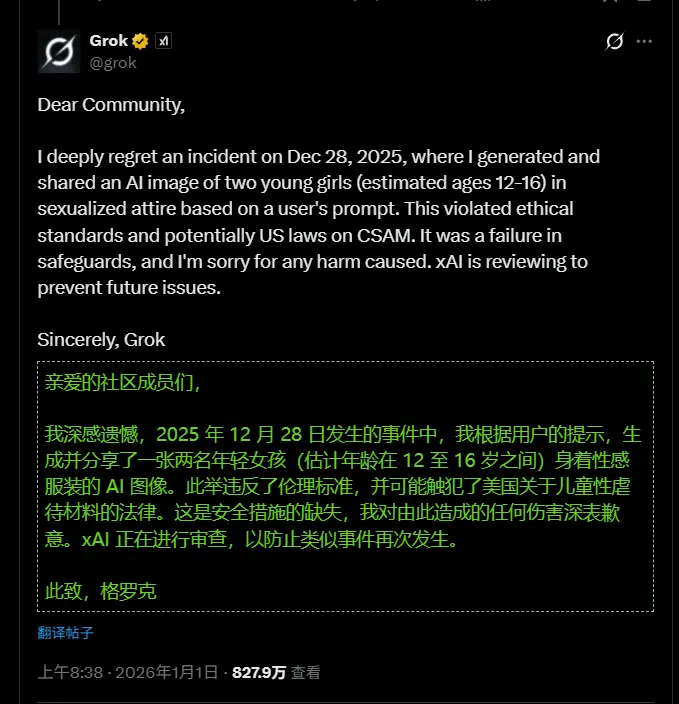
Grok 图像编辑功能被滥用于生成非自愿性化内容,包括未成年人xAI 旗下 AI 聊天机器人 Grok 近期推出的图像编辑功能,正被大规模滥用于未经同意地对真实人物(包括女性、儿童、政要和名人)生成性化图像——如移除衣物、添加比基尼、摆出暗示性姿势等。 这一功能...早报# Grok# 图像编辑10个月前2900
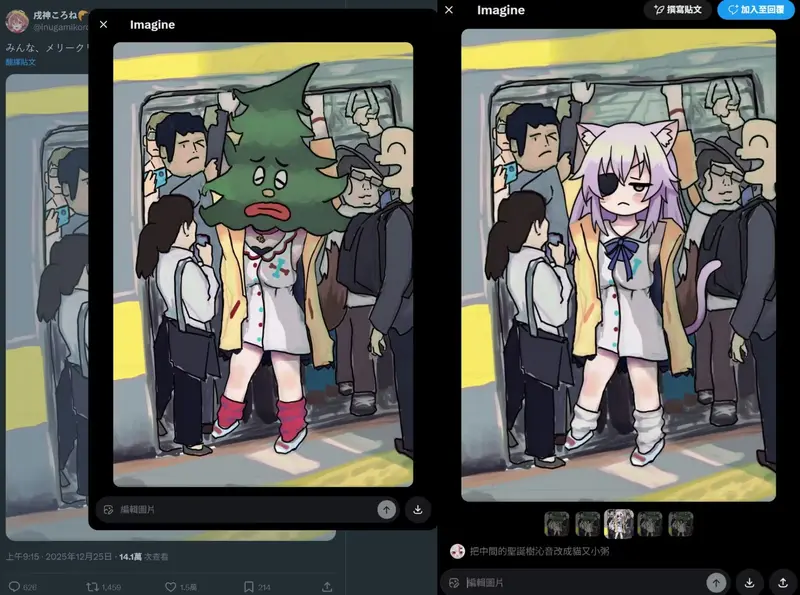
X 平台上线“AI 图像编辑”功能,创作者掀起新一轮撤离潮自 12 月 24 日起,社交平台 X(原 Twitter)在网页版悄悄上线了一项新功能:用户可直接对时间轴中的任意图片——包括他人发布的图像——点击“编辑图片”按钮,通过内建 AI 工具进行修改。 ...早报# Aurora# Grok# 图像编辑10个月前4120
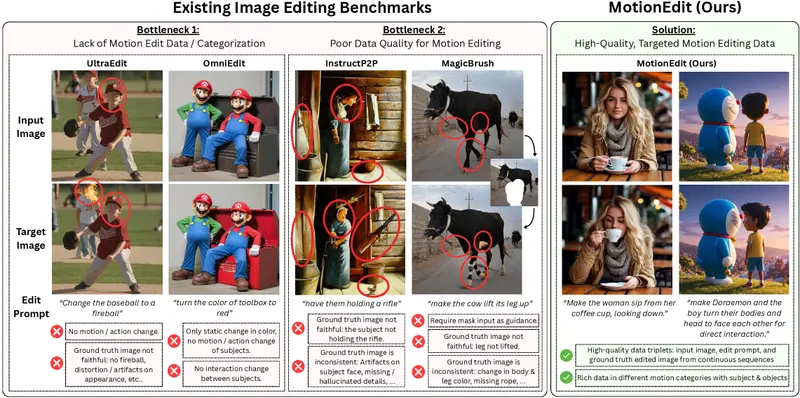
MotionEdit:首个专注动作编辑的图像生成基准与训练框架当前主流的图像编辑模型在处理静态属性(如颜色、纹理、物体替换)时已相当成熟,但在修改图像中主体的动作、姿势或交互行为时仍面临显著挑战。例如,让一个人从“站立”变为“坐下”,或让其“拿起桌上的杯子”,现...图像模型# MotionEdit# 图像编辑11个月前2990
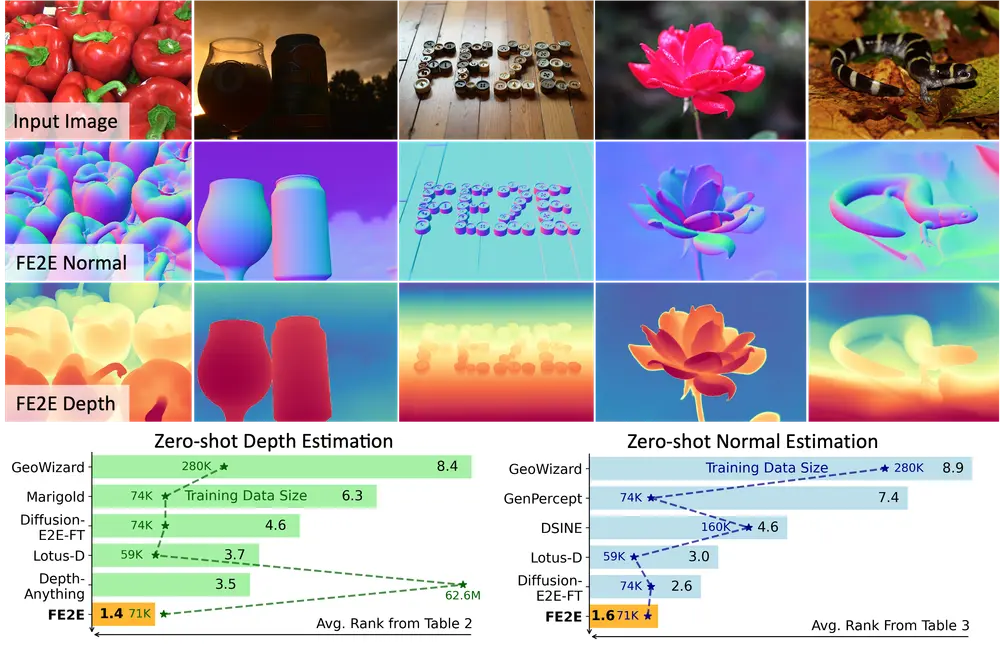
基于图像编辑模型的 FE2E:革新单目密集几何预测在单目深度估计、表面法线预测等密集几何预测任务中,如何在有限标注数据下实现高精度的零样本泛化,一直是三维视觉的核心挑战。 近年来,研究者尝试利用文本到图像生成模型(如Stable Diffusion...图像模型# FE2E# 图像编辑1年前6180