在文本驱动图像编辑领域,尽管免训练方法已取得显著进展,但“累积漂移”问题始终如影随形:传统方法在反演(加噪)和重建(去噪)过程中,因时间步长不匹配导致特征近似误差,最终造成背景失真或主体变形。
- 项目主页:https://desongyang.github.io/Directedit
- GitHub:https://github.com/Tr1stesse/DirectEdit
来自武汉大学的研究团队提出了 DirectEdit,一种基于流模型(Flow-based Models)的创新编辑框架。它通过直接对齐正向路径,从根本上消除了重建误差,在不增加额外计算负担的前提下,实现了超越 SOTA(最先进水平)的编辑精度与保真度。
核心功能:精准指令,完美保留
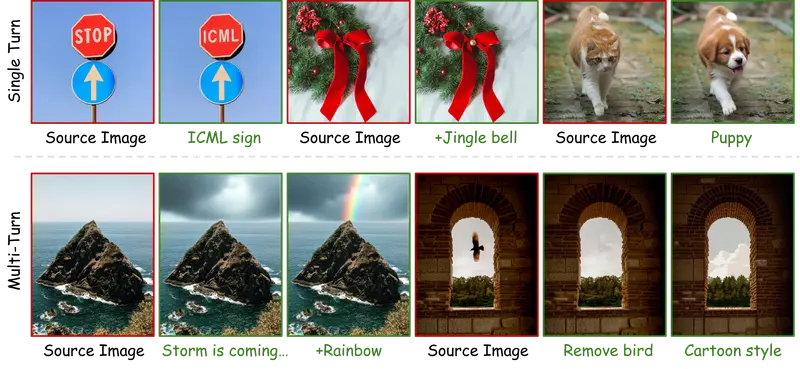
DirectEdit 能够根据自然语言指令,对图像进行精细且可控的修改,同时最大程度保留非编辑区域:
- 局部精准修改:替换物体(如狗变猫)、改变颜色、调整表情、添加装饰(如给猫戴帽子),边缘过渡自然。
- 背景无缝替换:仅更换背景(如草地变沙滩、街道变森林),主体光影与透视自动适配,毫无违和感。
- 全局风格迁移:将照片一键转换为卡通、油画、赛博朋克等艺术风格,保持原有构图与细节。
- 物体增删:智能添加元素(云朵、飞鸟)或移除杂物(路人、电线杆),自动填补背景缺失。
- 细节微调控制:精确调整眼睛颜色、嘴巴开合、肢体姿势等细微特征,避免过度修改。
三大核心优势:为什么选择 DirectEdit?
1. 零训练,即插即用
- 无需微调:直接利用预训练的文本到图像生成模型(如 FLUX, SD3.5),无需收集特定数据集或进行耗时昂贵的模型微调。
- 通用性强:适用于多种主流流匹配模型,部署简单,落地成本低。
2. 步骤级零误差,彻底解决漂移
- 路径对齐:不同于传统方法试图“修正”反演路径,DirectEdit 专注于直接对齐正向去噪路径。
- 原路返回:在编辑过程中,严格按照反演记录的步骤数据进行反向还原,确保每一步都与原图路径完全匹配,从根源上杜绝了累积误差。
3. 高保真与高可编辑性的完美平衡
- 智能保护机制:引入基于注意力特征注入和多分支掩码引导的噪声混合策略。
- 指哪打哪:自动识别并生成保护蒙版,只修改指定区域,同时将原图的高频细节特征注入编辑区,确保“想改的改得准,不想改的纹丝不动”。
工作原理:三步实现精准编辑
DirectEdit 的逻辑简洁而高效,主要分为三个阶段:
- 精准反演 (Precise Inversion):
将原图逐步转化为纯噪声,并详细记录每一步的潜在特征变化数据,建立完整的“轨迹档案”。 - 路径对齐 (Path Alignment):
在执行编辑指令时,严格遵循反演阶段的轨迹进行反向去噪。通过数学上的直接对齐,保证重建路径与原始路径的一致性,消除因时间步长不匹配带来的近似误差。 - 智能保护与特征注入 (Smart Protection & Injection):
利用多模态 AI 识别编辑区域,生成动态掩码。在去噪过程中,将原图的非编辑区域特征直接注入,并结合噪声混合策略,确保编辑区域与自然背景的无缝融合。
实验结果:全面领先
在多项标准测试集和主流模型(FLUX, SD3.5 等)上的广泛实验表明,DirectEdit 表现卓越:
- 修图精度第一:在结构保留率、背景保真度和文本指令匹配度三项关键指标上,均超越现有所有免训练 SOTA 方法。
- 近乎无损还原:步骤级重建误差极低,视觉上几乎无法区分编辑前后的非目标区域。
- 最佳平衡度:有效解决了“改不动”或“乱改”的两难困境,实现了高精度编辑与高保真保留的完美统一。
- 高效稳定:不增加额外的神经函数评估(NFE),推理速度与原生模型相当,且效果更稳定。
© 版权声明
文章版权归作者所有,未经允许请勿转载。