随着 AI 大模型能力的飞跃,其庞大的体积和高昂的计算成本成为了落地应用的巨大阻碍——这就是行业公认的“推理墙”。普通手机、笔记本电脑往往难以承载这些“巨无霸”模型,导致强大的 AI 能力被困在云端。
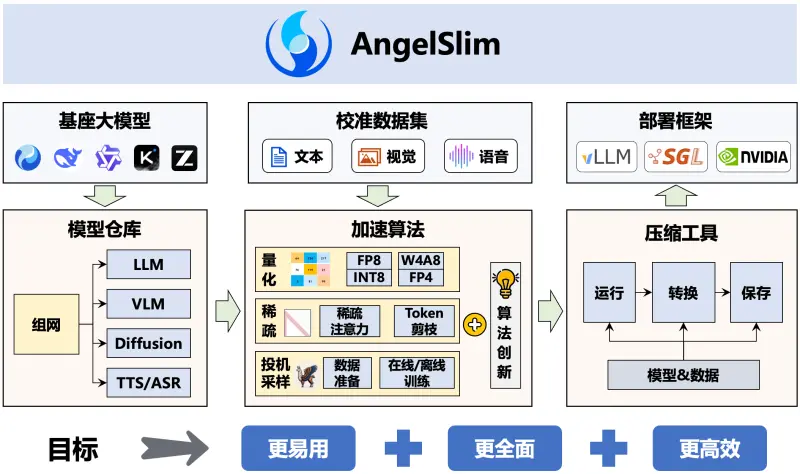
腾讯混元团队正式推出了 AngelSlim,一套专为大型 AI 模型设计的全面压缩与加速工具包。它通过整合量化、推测解码、Token 剪枝和蒸馏等前沿算法,提供了一条从模型压缩到工业级部署的统一流水线。
- 官方文档:https://angelslim.readthedocs.io/zh-cn
- GitHub:https://github.com/Tencent/AngelSlim
- 模型:https://huggingface.co/AngelSlim
AngelSlim 的目标很明确:把大模型变小、变快,且不损失核心能力,让高性能 AI 能够轻松运行在手机、平板等边缘设备上。
核心突破:极致压缩与高效加速
AngelSlim 并非单一技术的堆砌,而是一个深度融合的优化体系。其核心能力体现在以下五个方面:
1. 极致精度压缩:低至 2-bit
传统量化通常止步于 4-bit 或 8-bit,而 AngelSlim 突破了这一极限。
- 超低位宽支持:支持 2-bit 甚至 1.25-bit 的极端压缩。
- 工业级可行性:推出的 HY-1.8B-int2 是首个在工业场景中真正可行的 2-bit 大模型。
- 性能保留:实测显示,2-bit 压缩后的混元 1.8B 模型,性能下降不到 4%,与传统的 4-bit 模型表现几乎一致,但体积缩小了 6 倍。
2. 推测解码:推理速度翻倍
针对生成速度慢的问题,AngelSlim 引入了训练对齐的推测解码框架。
- 小模型猜,大模型验:利用小模型快速生成候选 Token,大模型仅负责并行验证。
- 吞吐量提升:在不牺牲输出正确性的前提下,实现 1.8 倍至 2.0 倍 的吞吐量提升。
- 广泛兼容:完美适配多模态架构和现代推理引擎。
3. 稀疏注意力:长文本秒响应
处理长上下文时,首字延迟(TTFT)往往是痛点。AngelSlim 开发了免训练的稀疏注意力框架:
- 动静结合:通过静态模式与动态 Token 选择的混合机制,解耦稀疏内核与模型架构。
- 关键信息聚焦:只计算长文本中关键信息的关联,大幅减少无用计算,显著缩短等待第一句回答的时间。
4. 多模态智能裁剪:减负不减质
对于图文、语音等多模态模型,冗余数据是效率杀手。AngelSlim 集成了专门的剪枝策略:
- 视觉优化:通过 IDPruner(基于最大边际相关性)优化视觉 Token,剔除冗余图像信息。
- 音频优化:利用 Samp 算法进行自适应音频 Token 合并与剪枝。
- 效果显著:在保持高测试得分的同时,大幅提升多模态模型的推理速度。
5. 一键式部署:开发者友好
- 统一流水线:将复杂的压缩策略封装为易用的工具,开发者无需深入底层算法细节。
- 免训练优化:许多优化步骤无需重新训练模型,直接加载即可加速,极大降低了部署门槛。
为什么选择 AngelSlim?
与市面上其他压缩方案相比,AngelSlim 具备三大突出优势:
| 特性 | 传统方案 | AngelSlim |
|---|---|---|
| 技术整合 | 单一技术,组合易冲突 | 全能融合:量化、稀疏、剪枝无缝协同 |
| 压缩极限 | 通常止步于 4-bit | 极致压缩:支持 2-bit/1.25-bit,体积更小 |
| 部署难度 | 需复杂微调或重训 | 开箱即用:支持免训练优化,适配主流模型 |
| 端侧表现 | 速度慢,耗电高 | 边缘友好:手机/PC 速度提升 3-8 倍 |
实际成效:数据说话
在实际测试中,AngelSlim 交出了令人瞩目的成绩单:
- 体积骤减:2-bit 模型体积仅为原版的 1/6。
- 速度飙升:在边缘设备(手机、普通电脑)上,推理速度比原版快 3-8 倍。
- 长文提速:长文本场景下的首字延迟大幅降低,用户体验更流畅。
- 多模态高效:图片和音频 Token 裁剪后,模型运行更快,且各项基准测试得分依然保持高位。
© 版权声明
文章版权归作者所有,未经允许请勿转载。