Google Research 发布了 Retrieve-for-Train (R4T),一种创新的检索框架,解决搜索和推荐系统中“查询扇出”(Query Fan-out)的效率与质量瓶颈。通过结合强化学习(RL)与扩散模型,R4T 能够在一次非自回归传递中生成多样化的子查询嵌入,相比传统方法实现了 12 到 20 倍的速度提升,同时显著提高了检索结果的多样性与相关性。
- 官方说明:https://research.google/blog/bypassing-inference-bottlenecks-accelerating-complex-ai-search-with-retrieve-for-train
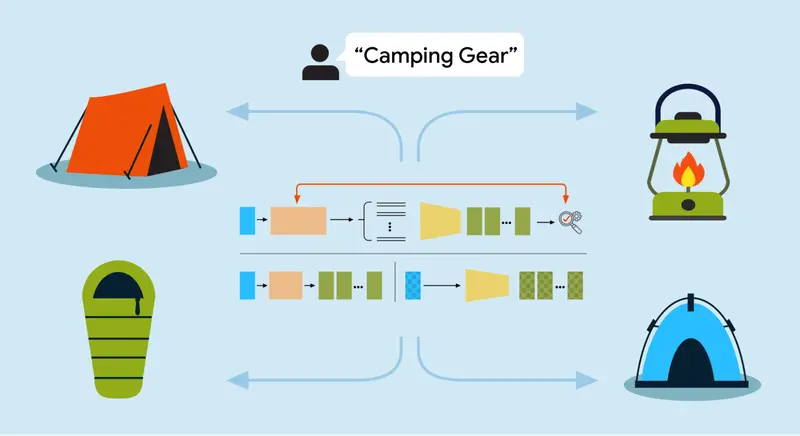
核心痛点:为什么传统扇出不够好?
在处理如“露营装备”这类宽泛查询时,系统需要返回帐篷、睡袋、炉具等多样化结果,而非同质化的重复项。传统基于 LLM 的零样本扇出存在两大缺陷:
- 释义坍缩 (Paraphrase Collapse):LLM 倾向于生成语义高度相似的子查询(如 “bohemian fashion” 和 “festival clothes”),导致检索结果单一。
- 高延迟与高成本:自回归生成子查询并多次调用检索器速度极慢;Best-of-N 采样虽能提升质量,但推理成本呈倍数增长。
R4T 三步管线:从 RL 优化到扩散蒸馏
R4T 的核心思路是**“离线强化学习,在线扩散推理”**:
- 扇出语言模型 (FOLM) 训练:
- 使用强化学习(GRPO + 软 PPO 正则化)训练一个 FOLM,使其生成的 $k$ 个子查询能在冻结的密集检索器上获得最高的集合级奖励。
- 奖励设计:包含接地性(确保子查询能检索到真实物品)、多样性(Vendi Score,避免同质化)和对齐性(确保子查询不偏离原意)。这三者共同防止了模型走捷径(如重复单词或简单释义)。
- 监督数据合成:
- 利用训练好的 FOLM,以温度 0.9 为每个查询采样 128 个高质量扇出方案,构建无需人工标注的
(查询, 目标嵌入集)训练对。
- 利用训练好的 FOLM,以温度 0.9 为每个查询采样 128 个高质量扇出方案,构建无需人工标注的
- 扩散检索器训练:
- 训练一个仅 5390 万参数的扩散 Transformer,学习将查询嵌入直接映射到一组目标嵌入。
- 在推理时,该模型通过单次非自回归传递即可生成所有子查询的嵌入向量,随后通过最近邻搜索映射回数据库项目。
性能表现:质量与速度的双重飞跃
1. 检索质量 (Polyvore 时尚数据集)
| 指标 | 零样本 Qwen3-4B | Best-of-N (N=5) | R4T-FOLM (Gemma3-4B) | R4T-Diffusion |
|---|---|---|---|---|
| LLM 评判平均分 | 38.5 | 40.9 | 49.1 | 47.3* |
| 多样性 (Vendi Score) | 56.0 | – | 76.8 | 74.3 |
> 注:R4T-Diffusion 不直接生成文本,故其质量通过嵌入检索后的结果间接评估,保留了大部分 FOLM 的性能优势。
2. 组合检索覆盖度 (WSCR)
- R4T-FOLM (Qwen):Recall@5K 达到 20.9,远超 Gemini-2.5-Flash 的 15.7。
- 多样性权衡:虽然 FOLM 的 Vendi Score 略有下降(27.5),但 R4T-Diffusion 成功将 Vendi Score 恢复至 34.7,证明了扩散模型在保持多样性方面的优势。
3. 推理效率
- 批次大小 8:自回归扇出耗时 1.46s vs 扩散模型 0.07s。
- 批次大小 1024:自回归扇出耗时 ~50s vs 扩散模型 4.21s。
- 加速比:稳定在 12x – 20x。
关键洞察
- 奖励黑客的防御:实验表明,单独使用接地性或对齐性奖励会导致模型收敛到无意义的重复字符串。只有引入多样性奖励,才能有效关闭这些“捷径”,迫使模型探索真正的语义空间。
- 小模型大能量:仅需 5390 万参数的扩散模型,就能蒸馏出大型 LLM 经过复杂 RL 优化后的行为,极大地降低了部署门槛。
- 从文本到嵌入的直接映射:R4T 跳过了生成文本子查询再编码的步骤,直接生成嵌入向量,这是实现极速推理的关键。
© 版权声明
文章版权归作者所有,未经允许请勿转载。