随着 AI 文生图模型从几十步进化到仅需 4-8 步的逐步蒸馏(Step Distillation)时代,生成速度大幅提升。然而,一个长期困扰业界的难题随之浮现:如何在不破坏模型“快速出图”能力的前提下,对其进行持续微调?
- 项目主页:https://vvvvvjdy.github.io/d-opsd
- GitHub:https://github.com/vvvvvjdy/D-OPSD
传统的监督微调(SFT)往往导致推理状态不一致,使模型变慢或画质下降;而基于强化学习的方法又依赖难以获取的奖励模型。来自香港科技大学、阿里巴巴 Z-Image 团队、UCSD 和港中文的研究人员联合推出了 D-OPSD,一种创新的 On-policy 自蒸馏方法,完美解决了这一矛盾。
核心突破:为什么 D-OPSD 如此重要?
1. 保留极速生成能力
- 无损微调:D-OPSD 专门针对少步采样器设计。微调后,模型依然能用极少的步数(如 4-8 步)生成高质量图像,彻底告别“微调即变慢/变糊”的困境。
- 训练-推理一致性:确保模型在训练时的行为分布与推理时完全一致,避免分布偏移导致的性能崩塌。
2. 无需外部奖励模型
- 自监督学习:利用模型自身的多模态理解能力作为“老师”,无需人工标注偏好数据或训练额外的奖励模型(Reward Model)。
- 低成本落地:仅需标准的图像-文本对数据即可训练,极大降低了二次开发和领域适配的门槛。
3. On-policy 自蒸馏机制
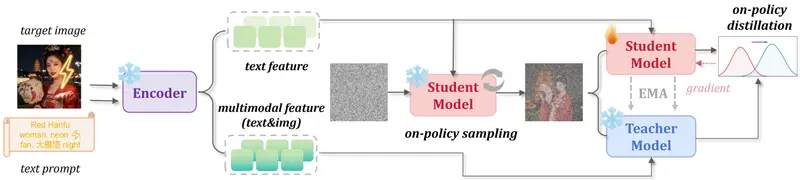
- 自我博弈:模型在同一生成轨迹上扮演“学生”和“老师”两个角色。
- 动态调整:“学生”基于纯文本提示生成轨迹,“老师”基于文本+目标图像的多模态特征提供更强指引。通过最小化两者在轨迹上的预测差异,实现精准调优。
4. 强大的持续学习能力
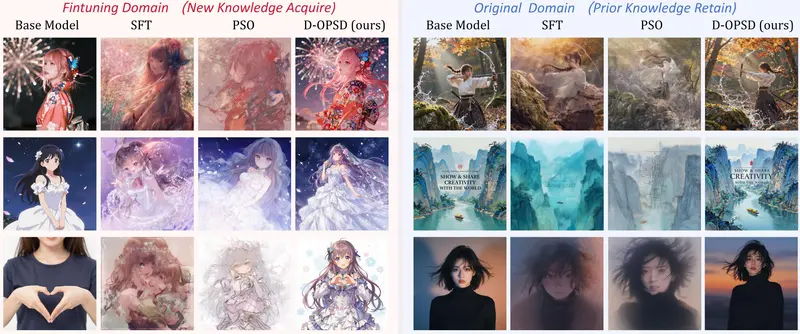
- 新知习得:能快速学习新的物体概念、艺术风格或领域偏好(如动漫、写实摄影)。
- 抗遗忘:在学习新知识的同时,牢固保留原有的通用生成能力,实现真正的终身学习。
工作原理:模型自己当教练
D-OPSD 的核心逻辑巧妙利用了现代多模态扩散模型的涌现属性:
- 双路编码:
- 学生路径:仅输入文本提示,模拟真实的少步推理过程,生成一条采样轨迹。
- 老师路径:输入文本提示 + 目标图像,利用 VLM/LLM编码器提取多模态特征,获得更精准的生成指引。
- On-policy 蒸馏:
- 在学生自己生成的轨迹状态上,计算“老师”预测的速度场与“学生”预测的速度场之间的差异。
- 通过最小化这一差异,引导学生向老师的精准方向靠拢,同时不改变其基础的少步采样逻辑。
- 推理复用:
- 训练完成后,丢弃“老师”分支。推理时,模型仍使用原始的纯文本到图像流程,保持极速体验。
性能表现:全面领先
研究团队在 Z-Image-Turbo、FLUX.2-klein 等主流高效模型上验证了 D-OPSD 的有效性:
| 指标 | 传统 SFT / DreamBooth | D-OPSD |
|---|---|---|
| 生成速度 | ❌ 显著下降,步数增加 | ✅ 保持原速,少步生成 |
| 图像质量 | ⚠️ 易模糊,细节丢失 | ✅ 高清锐利,媲美原版 |
| 风格贴合度 | ✅ 良好 | ✅ 卓越,泛化性强 |
| 知识遗忘 | ❌ 严重,原有能力受损 | ✅ 极低,持续学习稳定 |
| 训练成本 | ⚠️ 需大量数据或奖励模型 | ✅ 低,仅需图文对 |
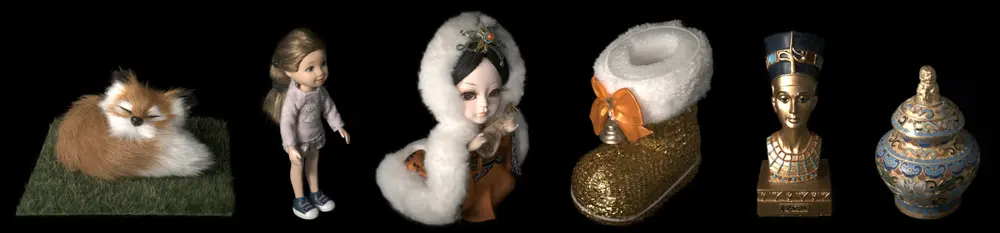
- 小数据微调:仅用几张图片即可学会新物体/风格,相似度与美感评分远超基线。
- 大规模适配:在动漫等新领域全参数微调中,表现出极强的风格捕捉能力且无灾难性遗忘。
适用场景
- 个性化 IP 创作:为品牌或角色定制专属形象,同时保持快速生成以支持实时互动。
- 特定风格迁移:将模型微调为特定艺术家风格或行业规范(如建筑设计图、医疗影像模拟)。
- 垂直领域应用:在电商、游戏素材生成等需要高频、快速出图的场景中,注入领域专业知识。
- 边缘设备部署:由于保持了少步特性,微调后的模型更适合在算力受限的设备上运行。
© 版权声明
文章版权归作者所有,未经允许请勿转载。