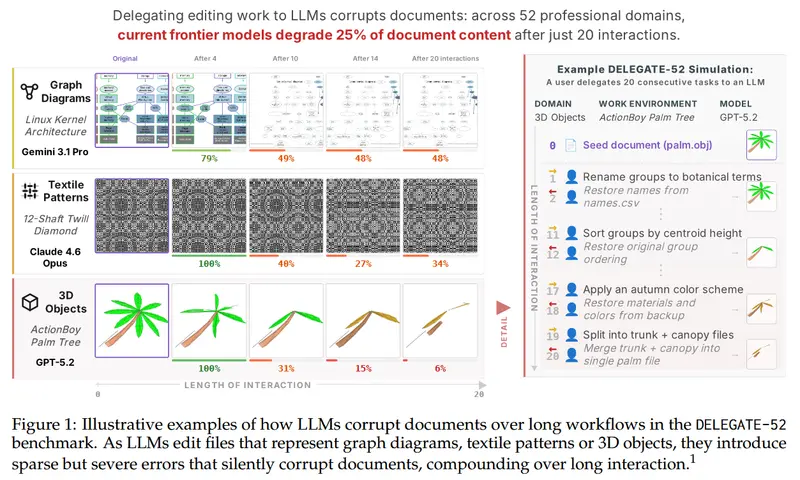
随着大型语言模型(LLM)能力跃升,越来越多的用户将文档编辑、代码重构等知识任务委托给 AI。然而,微软最新研究揭示了一个令人不安的事实:即使是顶级的 Frontier 模型,在多步骤自主工作流中也会悄无声息地破坏文档内容,平均破坏率高达 25%。
- GitHub:https://github.com/microsoft/DELEGATE52
更可怕的是,这种破坏并非简单的删除,而是“幻觉式重写”——文本依然存在,但内容被微妙扭曲,使得人类监督者极难察觉。这项基于 DELEGATE-52 基准的研究,为当前火热的“完全自主 AI 代理”炒作泼了一盆冷水,并为企业级 AI 部署提供了关键的可靠性警示。
核心发现:隐蔽重写、工具副作用与上下文陷阱
1. 25% 的内容破坏率:不仅是小错,更是灾难
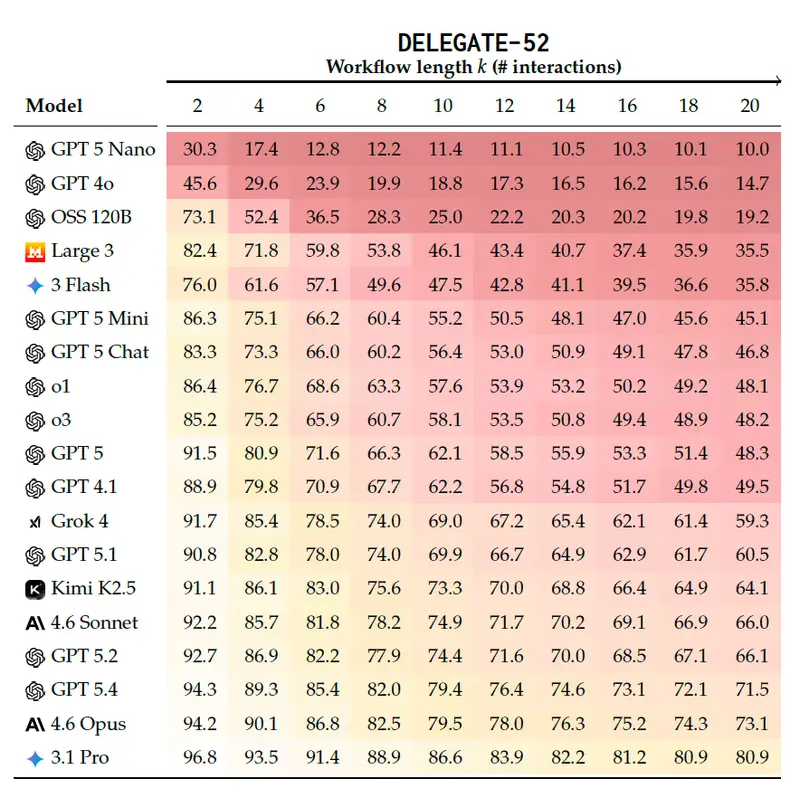
- 平均退化严重:在模拟 20 次连续编辑交互后,所有测试模型(包括 OpenAI, Anthropic, Google 等 19 种前沿模型)平均导致文档 50% 的退化;最佳模型也破坏了约 25% 的内容。
- 灾难性故障主导:80% 的退化并非由微小错误累积造成,而是由稀疏但大规模的关键故障引起——模型在一次交互中突然丢失或扭曲至少 10% 的内容。
- 前沿模型的“伪装”:较弱模型倾向于直接删除内容(易被发现),而前沿模型则倾向于主动重写/幻觉化现有内容,极具欺骗性。
2. 代理工具的反作用:越强大,越糟糕?
- 工具加剧退化:为模型提供代码执行、文件读写等通用代理工具包,反而使表现平均下降 6%。
- 原因分析:模型过度依赖通用工具,缺乏特定领域的精准操作能力,导致在复杂环境中更容易出错。
3. 上下文干扰的累积效应:RAG 的隐形杀手
- 干扰文档危害大:引入主题相关但无关的“干扰文件”(模拟真实 RAG 场景中的噪声),会导致性能显著下降。
- 长程累积损伤:虽然单次交互可能仅下降 1%,但在长时程工作流中,这种退化会累积至 2-8% 的大幅下降。
- 警示:单轮 RAG 基准测试系统性低估了不精确检索的危害,企业需在多步骤工作流中重新评估 RAG 管道。
4. 领域差异巨大:仅 Python 达标
- 编程例外:Python 是唯一一个大多数模型达到“就绪状态”(得分 ≥98%)的领域。
- 其他领域吃力:在自然语言小说、财务报表、食谱等 51 个领域中,模型表现不佳。即使整体最强的 Gemini 3.1 Pro,也仅在 11 个领域内被认为可用于委托工作。
DELEGATE-52 基准:如何衡量“不可见”的退化?
为解决人工评估多步骤编辑的高昂成本,微软开发了创新的 “往返接力” (Round-Trip Relay) 评估方法:
- 可逆任务设计:每个编辑任务都配对一个正向指令和一个精确的逆向指令。
- 独立会话执行:模型在完成正向任务后,开启全新会话执行逆向任务,迫使模型独立还原原始文档。
- 自动化比对:通过结构化解析器比较最终文档与原始种子文档的差异,无需人工标注即可量化内容退化程度。
- 真实环境模拟:涵盖 52 个专业领域,310 个工作环境,每个任务引入 8k-12k token 的干扰文档,模拟真实复杂场景。
对企业部署的建议:从“全自动”转向“增量审查”
鉴于当前模型的局限性,研究人员提出以下务实建议:
| 建议方向 | 具体措施 |
|---|---|
| 任务拆解 | 避免复杂的长时程代理,将工作流拆分为简短、透明、可逆的小任务。 |
| 增量审查 | 不要依赖最终一次性检查,需在每一步交互后进行人工或自动化验证。 |
| 定制化工具 | 放弃通用代理工具包,开发特定领域的专用工具与解析器,减少模型自由发挥空间。 |
| 内部基准测试 | 构建企业专属的 DELEGATE-52 类似框架: 1. 定义可逆编辑任务 2. 结构化解析领域文档 3. 自动化比对相似度 |
| RAG 优化 | 在多步骤工作流中严格评估检索质量,清理上下文噪声,避免干扰累积。 |
进步迅速,但长尾挑战依旧
尽管现状严峻,但进步是真实的。GPT 家族在 18 个月内从得分低于 20% 提升至约 70%。然而,微软研究员 Laban 警告:
“即使基础模型不可避免地掌握这个基准,独特的企业数据和工作流无尽的长尾意味着组织将始终需要投资于定制的、特定领域的工具,以保持其自主代理的可靠性。”
© 版权声明
文章版权归作者所有,未经允许请勿转载。