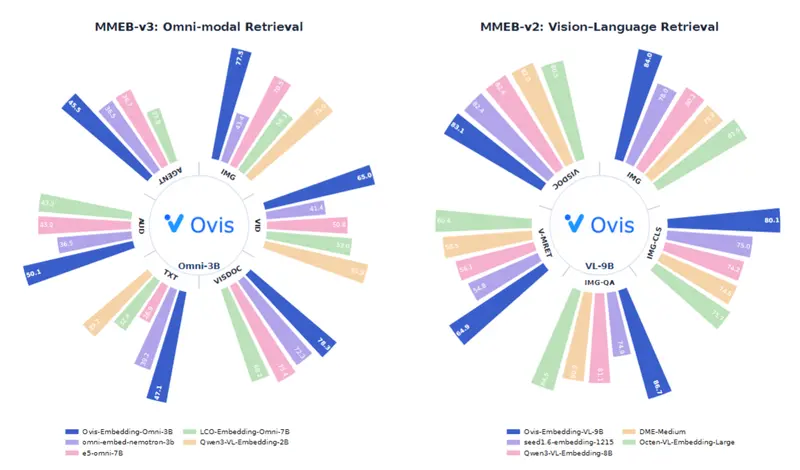
阿里ATH-MaaS开源Ovis-Embedding系列嵌入模型:文字/图/视频/音频统一语义空间,实现任意模态互搜阿里ATH-MaaS推出 Ovis-Embedding 系列嵌入模型,核心目标是把文字、图片、视频、音频全部映射到同一个共享语义向量空间,实现任意模态检索:用任意一类内容作为查询,检索其他类型素材。官...多模态模型# Ovis-Embedding# 嵌入模型2个月前960
Liquid AI 发布 LFM2.5-VL-3B-DSpark:VLM 投机解码草稿模型,Apple Silicon 解码加速达 3.13 倍Liquid AI 推出 LFM2.5-VL-3B-DSpark,一个专为 LFM2.5-VL-3B 视觉语言模型设计的实验性投机解码草稿模型。该草稿器仅增加约 2.8 亿参数(+8.9%),在不改变...多模态模型# LFM2.5-VL-3B-DSpark# Liquid AI2个月前780
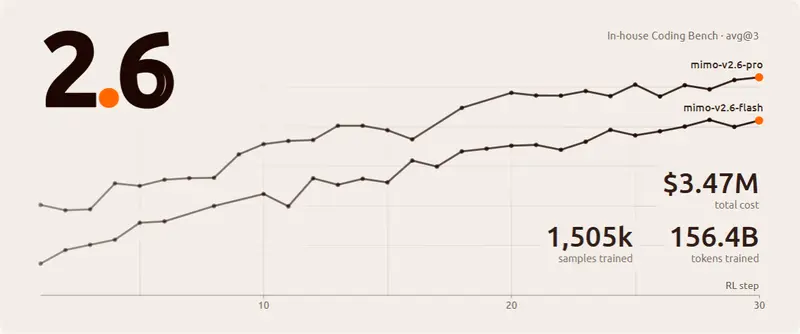
小米开源 MiMo-V2.6 系列:全模态 RL 扩展模型,Pro 版登顶开源智能榜首小米正式发布并开源 MiMo-V2.6 系列原生全模态模型,包含 MiMo-V2.6-Pro、MiMo-V2.6-Flash,同时推出 MiMo-V2.6-Pro-UltraSpeed 极速版本,在同...多模态模型早报# MiMo-V2.6# 小米2个月前3430
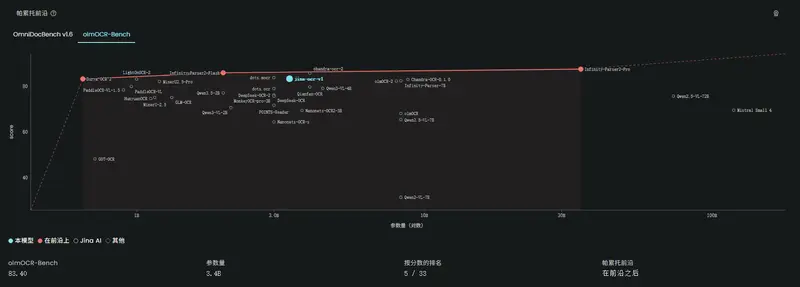
Jina AI 发布 jina-ocr-v1:3.4B MoE 文档解析器,适配低预算 GPU,自带投机解码Jina AI(Elastic 旗下)正式开源 jina-ocr-v1,一款端到端视觉文档解析模型。该模型总参数量为 3.4B,每个 token 仅激活约 570M 解码器参数,专为 NVIDIA L...多模态模型# Jina AI# jina-ocr-v12个月前880
阿里发布 Qwen3.8-Omni-Flash:百万上下文全模态模型,主打代理式音视频理解阿里巴巴通义千问团队正式发布了 Qwen3.8-Omni-Flash,号称业界首个围绕 Agent(智能体)能力 构建的全模态模型。该模型能够同时理解文本、图像、音频和视频,并通过内置的推理与工具使用...多模态模型早报# Qwen3.8-Omni-Flash# 通义千问2个月前1040
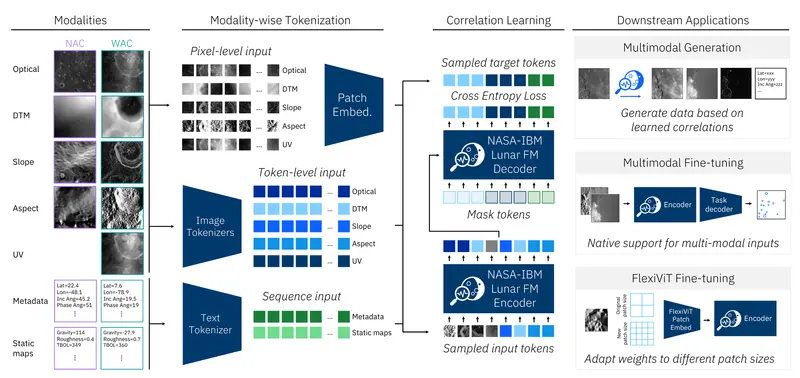
NASA 联合 IBM 开源月球基础模型 LFM,多模态 AI 助力月球遥感科研NASA 和 IBM 今日正式发布了一款专为月球遥感设计的多模态、多分辨率开源 AI 基础模型(NASA-IBM Lunar Foundation Model, LFM)。这是首个整合多种数据模态、不...多模态模型# IBM# LFM# NASA2个月前750
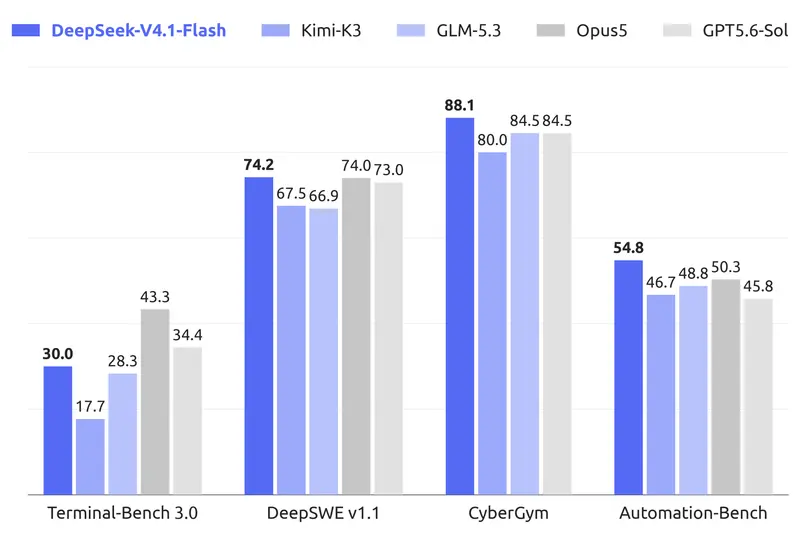
深度求索发布DeepSeek-V4.1-Flash :百万上下文,KV缓存大幅压缩,代理任务性能暴涨随着AI智能体(Agent)的普及,大模型的工作模式正在发生改变。大量长周期任务带来海量输入,反复预填充、百万级上下文会持续占用KV缓存,对HBM显存、SSD存储以及带宽都带来巨大压力。 深度求索(D...多模态模型# DeepSeek V4.1 Flash# 深度求索2个月前1660
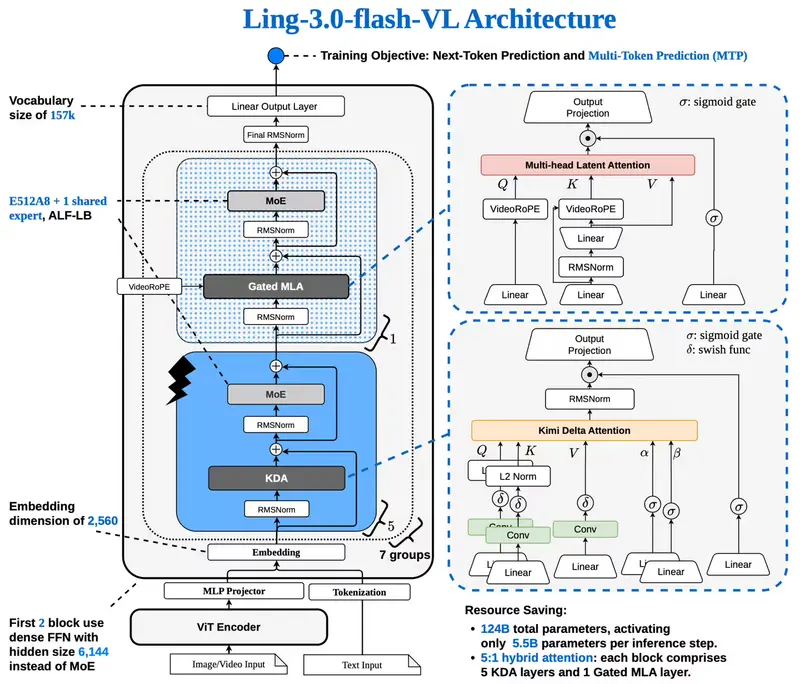
蚂蚁开源百灵首个原生多模态大模型 Ling-3.0-flash-VL,搭载视觉反馈闭环,可自我修正GUI任务蚂蚁集团正式发布并开源百灵(Ling)系列首款原生多模态大模型 Ling-3.0-flash-VL。模型在Ling-3.0-flash MoE混合专家底座上扩展而来,原生支持图、文、视频多模态输入,主...多模态模型# Ling-3.0-flash-VL# 蚂蚁集团2个月前1160
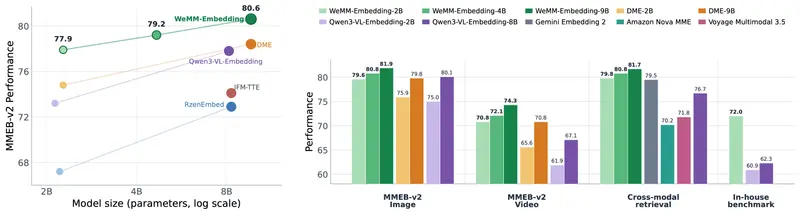
微信视觉团队开源通用多模态向量模型家族WeMM‑Embedding:2B‑9B 全规格,经过微信真实业务大规模验证腾讯微信视觉团队(WeChat Vision)正式开源了 WeMM-Embedding,这是一套包含 2B、4B、9B 三种规模的通用多模态 Embedding 模型家族。它旨在解决互联网内容形态日益...多模态模型# WeMM‑Embedding# 微信2个月前1240
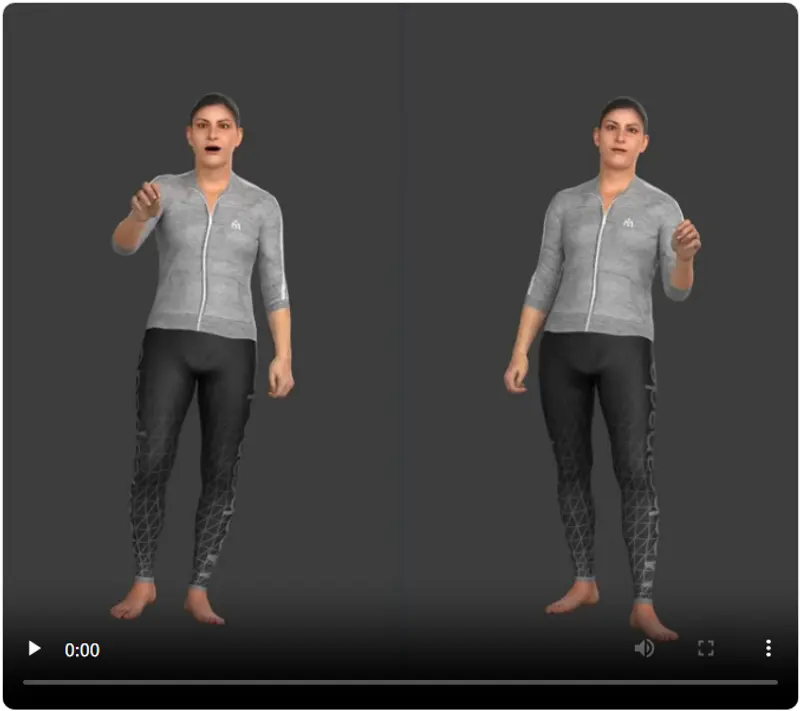
北大发布端到端口语对话系统Motion-Omni:端到端生成语音与全身动作,让数字人告别“录播感”北京大学研究团队最新发布的 Motion-Omni(参考实现为 Motion-Omni-Q7)是一个端到端口语对话系统。它打破了传统数字人“先生成语音、再驱动动作”的串联流水线模式,能够同时生成同步的...多模态模型# Motion-Omni2个月前1050
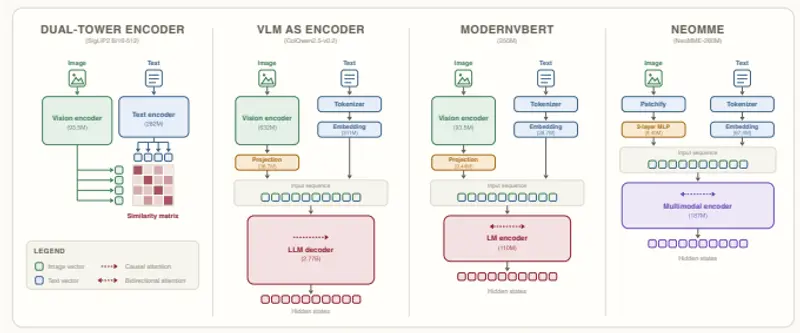
H Company 发布NeoMME:单塔多模态编码器家族,抛弃视觉塔与解码器,轻量化文档检索新方案H Company 正式发布了 NeoMME,这是一个包含 260M 和 800M 参数的双向多模态编码器家族。与当前主流的“二手”视觉文档检索器(如 ColPali,即复用生成式 VLM 的编码器部...多模态模型# H Company# NeoMME2个月前920
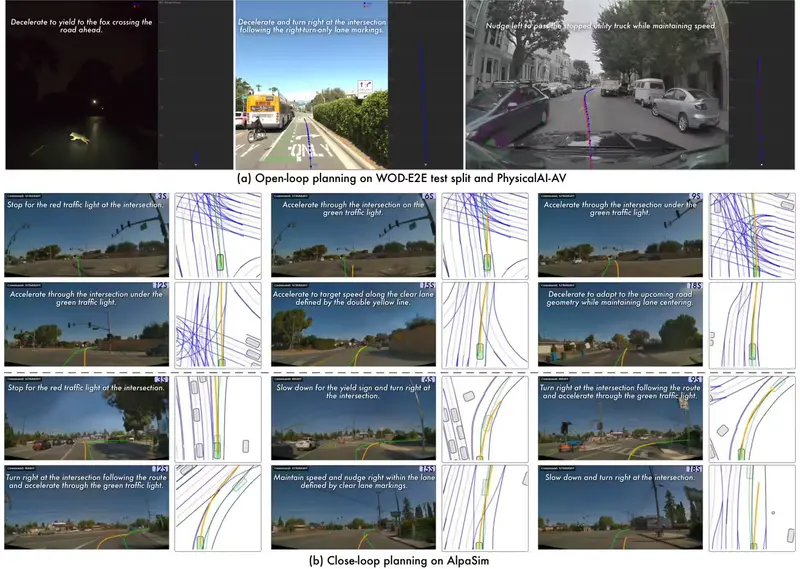
阿里千问开源 Qwen‑Drive‑1.0‑4B,自动驾驶视觉语言基础模型正式开放阿里巴巴通义千问团队本周正式开源了 Qwen-Drive-1.0-4B,这是基于 Qwen3.5-4B 构建的、专为自动驾驶场景设计的视觉语言模型(VLM)。作为业界首个将 3D 感知、视觉问答与运动...多模态模型# Qwen-Drive-1.0-4B# 自动驾驶# 阿里巴巴2个月前1050