小米推出了 Xiaomi-OCR-0,这是一款参数量为 0.8B 的统一视觉语言模型,专注于文档解析与以 OCR(光学字符识别)为中心的深度理解。
- GitHub:https://github.com/xiaomi-research/Xiaomi-OCR-0
- 模型:https://huggingface.co/xiaomi-research/Xiaomi-OCR-0
- Demo:https://huggingface.co/spaces/loongwayX/Xiaomi-OCR-0-demo
该模型以 Qwen3.5-0.8B 为基础架构,在约 1.7 亿条 OCR 核心样本上进行了针对性训练。训练过程引入了 Q-Mask 文本锚定技术,通过掩码机制强化文本与视觉特征的对应关系。
同时,模型结合了继续预训练(CPT)与混合任务强化学习(Mix-RL),进一步注入领域知识并优化了多任务决策能力。
权威基准测试表现
在多项行业基准测试中,Xiaomi-OCR-0 展现了与其参数量相匹配的性能表现。
需要注意的是,其文档解析基准测试均采用两阶段(2-stage)方法进行评估。具体成绩如下:
- 综合文档解析:在 Real5-OmniDocBench 中得分 95.24,位列第 1;在 OmniDocBench v1.6 与 Wild-OmniDocBench 中分别得分 96.83 与 87.94,均位列第 2。
- 公式与表格识别:在 UniMER-Test(公式识别)中得分 97.84,在 PubTabNet(表格识别)中得分 92.27。
- 复杂手写体识别:在 Chronicles-OCR Mature Scripts(涵盖隶书、草书、行书、楷书)中得分 73,与参数量更大的 Seed 2.0 Pro(72 分)能力相当。
- 视觉问答能力:在五项 OCR 中心 VQA 基准测试中,平均得分达到 83.2,以 0.8B 的参数量超过了 Qwen3.5-2B 的 80.9 分。
核心功能模块
Xiaomi-OCR-0 将多种文档处理需求整合在一个模型中,主要提供以下核心能力:
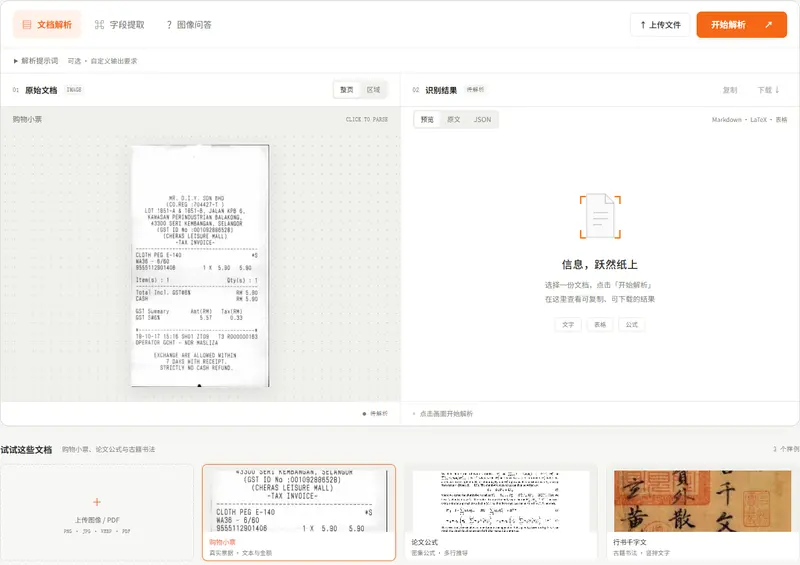
- 结构化文档解析:能够识别文档页面并输出结构化的 Markdown 格式。其中,模型输出的 OTSL 表格会由后处理程序转换为 Markdown 中的 HTML 表格,数学公式则统一使用 LaTeX 格式呈现。
- 关键信息抽取(KIE):支持按照用户指定的字段规则,从非结构化文档中精准提取信息,并直接输出为标准的 JSON 格式。
- OCR 视觉问答(VQA):具备深度理解能力,能够直接回答基于文档图像中文字内容与版面布局提出的具体问题。
工程部署与使用策略
为了方便开发者集成与实际业务落地,Xiaomi-OCR-0 提供了完善的工程化支持与明确的使用建议。
- 本地 Agent 工具集成:通过 MCP(模型上下文协议)服务,系统可自动处理提示词构建、PDF 或图像预处理。同时支持可选的区域检测、裁剪并发推理以及最终结果的自动组装。
- 本地浏览器 Demo:提供了基于本地网页的体验入口,用户可以直接在浏览器中测试整页解析与区域解析的实际效果。
在实际应用中,针对不同版式的文档,官方给出了两种解析策略的建议:
- 区域解析模式:适合印刷清晰、版式规整的标准化文档。该模式可自动检测特定区域并进行并发处理,从而提升整体解析效率。
- 整页解析模式:适合场景文字、手写笔记、书法作品、古籍以及版式不规则的材料。采用整页解析可以有效避免因区域边界切割错误而导致的上下文信息丢失。
© 版权声明
文章版权归作者所有,未经允许请勿转载。