在游戏开发、影视预演及 AI 智能体内容创作中,创作者通常已提前规划好场景布局、物体摆放、人物动作轨迹及镜头运动。这些规划通常以结构蓝图的形式存在,如线框图、骨骼动作数据或灰度方块布局图,仅记录位置与运动,缺乏颜色、材质与光影。将这些蓝图转化为真实感画面的过程即为渲染。
传统渲染方法面临三大工程痛点:首先,工具通常绑定特定格式,更换蓝图类型(如从方块布局换为简笔画或点云)需重新训练模型,维护成本高昂;其次,生成速度慢,高质量视频模型需数十轮降噪运算,而直接套用加速插件易破坏模型对蓝图布局与动作的跟随能力;最后,训练素材获取困难,蓝图与真实视频时间错位会导致模型学习到错误的对应关系,生成画面发生偏移。
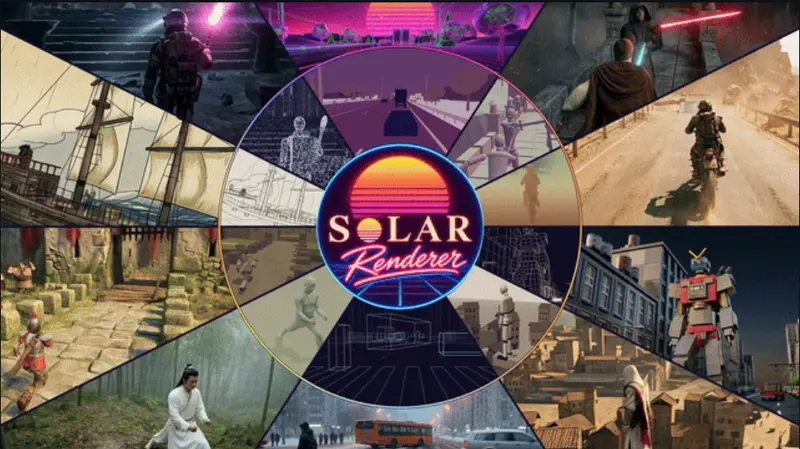
针对上述问题,多所高校的研究者提出了 SolarRenderer,一套少步生成式渲染框架。该框架在冻结现有大型视频模型的基础上,仅引入两套轻量级适配模块,即可将各类结构蓝图转化为真实视频。其核心突破在于:无需对蓝图类型进行分类标记,直接通过模型原生参考通路输入;仅需 4 轮运算即可完成渲染,速度较传统 50 步方法提升 12 倍以上;并拓展出支持 768P 实时输出的流式版本。
- 项目主页:https://enderfga.cn/SolarRenderer/
- GitHub:https://github.com/Enderfga/SolarRenderer
- 模型:https://huggingface.co/Enderfga/SolarRenderer
- Demo:https://huggingface.co/spaces/Enderfga/SolarRenderer
核心工作原理
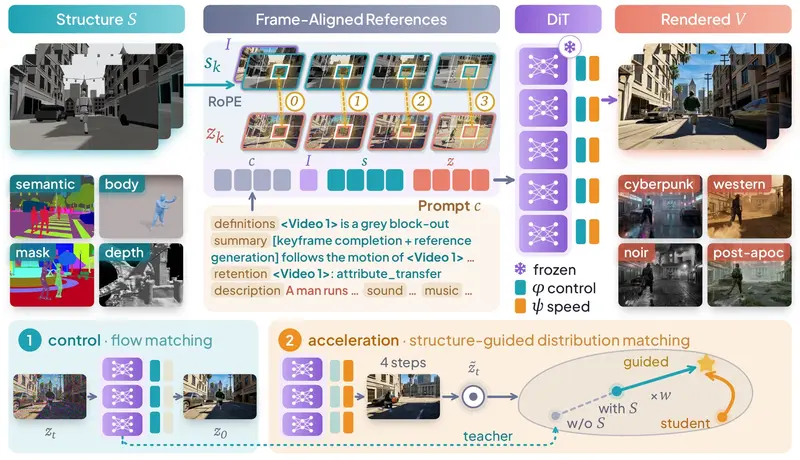
SolarRenderer 建立在冻结的现成大型视频模型(如 33B 参数底座)之上,仅新增两套轻量级 LoRA 适配模块。整体流程分为条件输入对齐、两阶段训练与流式拓展三个核心环节。
1. 条件输入对齐
系统接收蓝图参考视频、可选的起始画面及文字描述。蓝图不经过额外的处理分支,直接送入模型原生的参考视频通路。关键在于时空位置编码对齐:蓝图的每一帧被分配与目标生成画面完全一致的时空位置编码,确保模型明确当前蓝图帧对应生成结果的同一时刻。同时,系统配合固定格式的文字描述,明确告知模型蓝图的约束规则(如必须遵守的布局)以及需忽略的视觉样式(如草图线条或灰色色块)。
2. 第一阶段:控制适配训练
在此阶段,底层大模型权重完全冻结,仅训练控制 LoRA 模块,采用流匹配(Flow Matching)作为训练目标。训练数据全部采用经过严格校验、蓝图与视频逐帧对齐的样本。该阶段旨在让模型学会读取蓝图参考,严格遵循其定义的物体位置、人物动作与相机轨迹,同时忽略蓝图本身的无关视觉特征。此阶段完成的模型虽能精准跟随蓝图,但依赖传统的 50 步降噪,生成速度较慢。
3. 第二阶段:加速后训练
此阶段冻结第一阶段训练好的控制 LoRA,仅训练加速 LoRA 模块。若直接拼接现成的四步加速插件,模型会丧失对蓝图的忠实跟随。为此,研究团队提出了结构引导分布匹配方案:以第一阶段的慢速模型作为“教师”,在教师进行预测时,人为放大蓝图结构带来的影响,生成更强的参考目标;“学生”四步模型则向这一强化后的结果学习。通过放大蓝图约束信号,有效弥补了加速带来的画质与控制力损失。
4. 因果流式拓展
在双向版本基础上,系统改造了注意力计算规则。视频被切分为片段块,生成后续画面时,模型仅能观测当前块及已生成的历史画面,无法预知未来。该过程同样分两步训练(先训练因果控制 LoRA,再后训练因果加速 LoRA)。推理时,生成完一个片段块即立刻解码输出,实现边算边播,达成 768P 视频的实时流式渲染。
核心功能与技术特点
- 多类型结构蓝图兼容,无需类型标签:单套模型即可处理方块布局图、语义分割图、深度图、人物骨骼、线框及简笔画草图。模型依靠时序对齐与文本规则描述实现跨类型兼容,支持处理训练阶段从未见过的蓝图格式。
- 四步极速渲染与流式输出:双向版本仅需 4 轮运算,大幅缩短渲染耗时,且严格保持对蓝图布局、动作与镜头的跟随。因果流式版本支持实时交互场景下的 768P 视频边算边输出。
- 输入组合灵活:支持四种输入模式:蓝图 + 起始参考画面、仅提供蓝图、仅提供起始画面、仅使用文字描述。
- 低资源开销的架构设计:底层 33B 视频大模型全程冻结,仅训练两套轻量适配模块,训练资源开销可控。消融实验证明,复用原生参考通路的蓝图跟随效果优于新增独立控制分支(如 ControlNet 架构)。
- 严格帧对齐的大规模数据集:构建了包含 13.6 万组剪辑片段的训练数据集,来源涵盖游戏引擎、仿真软件及网络实拍视频。每一条样本均经过时间与空间双重校验,确保蓝图运动与视频运动时间点严格对齐、物体轮廓匹配,并配套生成说明约束规则与材质光影细节的提示词。
性能评估与实验结论
研究团队使用分布内测试集与包含 16 种格式(其中 11 种为训练未见)的泛化测试集进行评估,结合 AI 裁判打分、自动指标及真人盲看校验,得出以下结论:
- 综合表现领先:SolarRenderer 四步双向版本在分布内与泛化测试集的主观偏好得分均位居第一梯队。在人物大幅度运动、快速镜头、多人物、夜景及陌生蓝图等高难度场景下,其画质、蓝图跟随准确度与时序稳定性优势明显。
- 强泛化能力:面对儿童简笔画、线框模型、人体骨骼等未见过的输入,模型仍能准确解析布局与动作,生成符合约束的真实视频。
- 速度收益显著:生成同等长度视频,四步双向版本速度较传统 50 步原版提升 12.3 倍。因果流式版本在保持较强蓝图跟随能力的前提下,实现了 768P 实时输出,显著优于其他流式渲染基线。
- 消融实验关键发现:
- 结构引导分布匹配不可或缺,缺失该步骤直接拼接加速插件会导致蓝图跟随能力大幅下滑。
- 训练数据对齐的质量比数据集样本总数量更重要,时空错位的数据会直接削弱模型的控制效果。
- 复用模型原生参考通路的方案,在蓝图跟随效果上优于新增独立控制分支的方案。
工程局限与适用边界
作为一项科研原型,SolarRenderer 在实际应用中存在以下客观限制,需在工程落地时予以考量:
- 底层依赖:模型性能高度依赖所冻结的大型视频底座模型的能力上限。
- 复杂运动瑕疵:在极端剧烈或复杂的运动场景下,生成画面仍可能出现一定程度的瑕疵。
- 流式版本画质折损:因果流式版本为换取实时生成速度,牺牲了部分画面细节表现,画质略低于完整的双向版本。
- 控制维度限制:蓝图仅能约束布局、位置与运动轨迹,无法精细指定具体的材质与颜色,这些视觉细节仍由模型根据提示词自由推断生成。
- 输入容错率低:若输入的蓝图本身逻辑混乱或动作不合理,生成视频将直接继承并放大这些缺陷。
© 版权声明
文章版权归作者所有,未经允许请勿转载。