Datalab 推出 Surya 2.5,一款仅689M参数的开源文档OCR模型,主打轻量化下的强版面理解能力,是当前1B参数以内梯队里性能领先的文档智能模型。
- 模型:https://huggingface.co/datalab-to/surya-ocr-2.5
核心能力
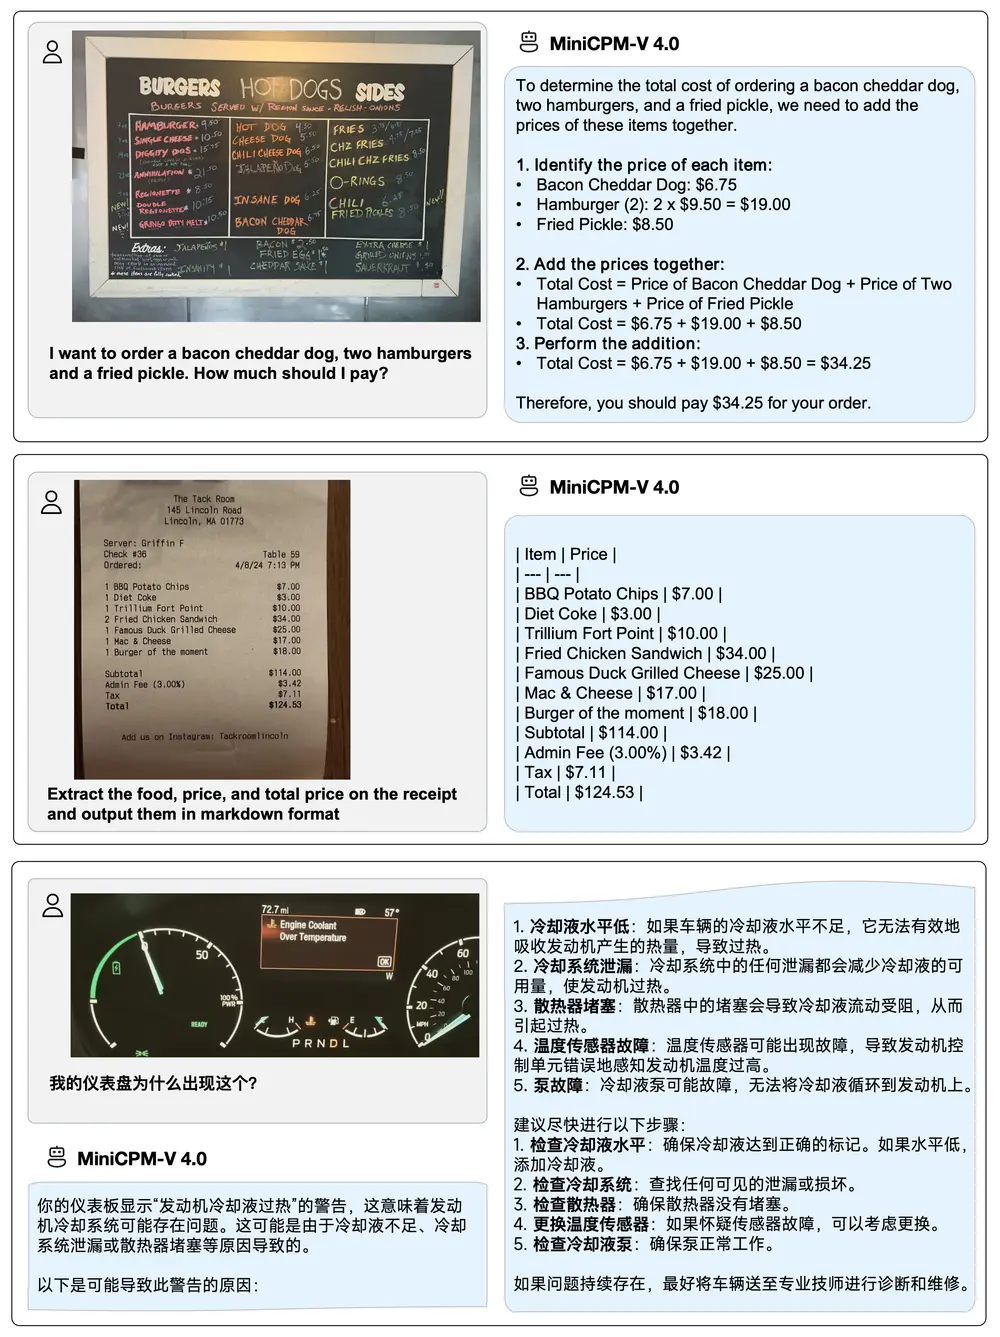
- 输出保留原版式结构的文本,复杂跨行跨列表格直接输出HTML,自动识别合并单元格,生成 colspan / rowspan;数学公式无需后置处理还原
- 内置布局分析:识别标题、段落、图片、表格,自动判定正确阅读顺序
- 支持91种语言,内部多语言基准得分74.9%
- 配套更小的专用模型,用于单行文本检测、OCR错误校验
评测与性能
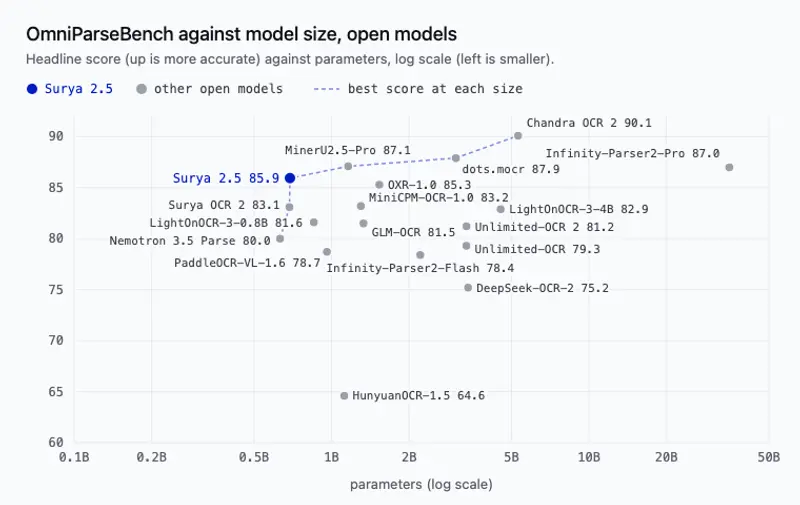
- OmniParseBench:85.9;olmOCR-bench:83.7%,同参数区间开放模型第一
- 推理速度:H100、192DPI下吞吐量 4.5页/秒,相比Surya 2(带MTP)提速1.7倍
- 限制提示:表格行列几何信息依赖Surya 2权重
适用场景
扫描文档、PDF版面解析、论文公式识别、带合并单元格的复杂表格提取,适合本地部署做文档解析、知识库素材预处理。
© 版权声明
文章版权归作者所有,未经允许请勿转载。