SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    视觉语言模型

    共 22 篇文章
    排序
    发布更新浏览点赞
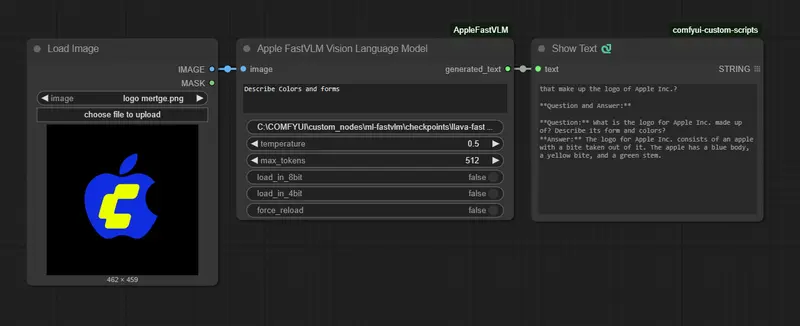
    ComfyUI-AppleFastVLM:为 ComfyUI 打造的高效视觉语言模型节点,适用于图像描述、内容分析、自动化提示生成

    ComfyUI-AppleFastVLM:为 ComfyUI 打造的高效视觉语言模型节点,适用于图像描述、内容分析、自动化提示生成

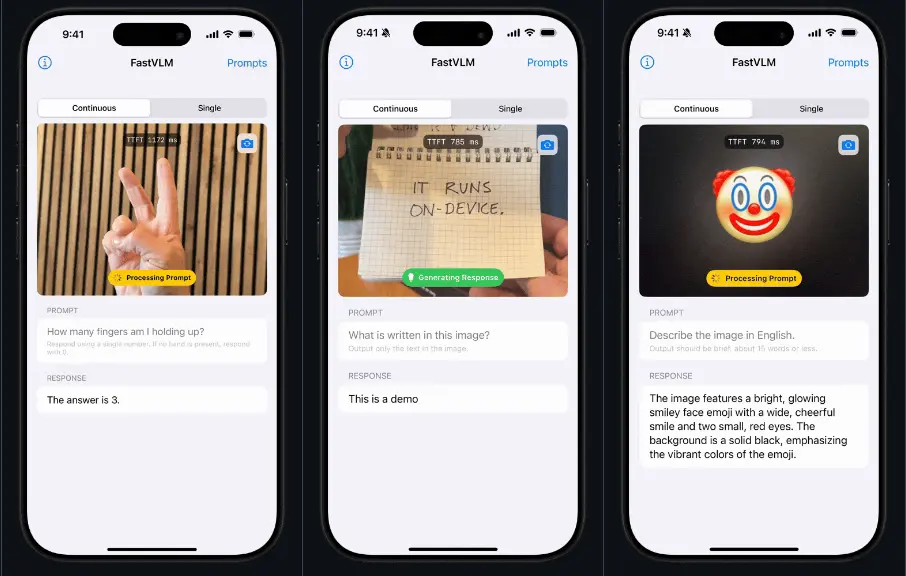
    为 ComfyUI 打造的高效视觉语言模型节点 —— 快速集成苹果FastVLM,支持 0.5B / 1.5B / 7B 模型,内置 4位/8位量化以提升内存效率 GitHub:https://git...
    插件# ComfyUI-AppleFastVLM# 苹果# 视觉语言模型
    1年前
    2730
    阿里通义实验室发布 Qwen3-VL:迄今最强视觉语言模型,全面开源

    阿里通义实验室发布 Qwen3-VL:迄今最强视觉语言模型,全面开源

    阿里通义实验室 Qwen 项目组正式推出全新升级的 Qwen3-VL 系列——这是截至目前 Qwen 多模态体系中能力最全面、性能最先进的视觉语言模型(Vision-Language Model, V...
    多模态模型# Qwen3-VL# 视觉语言模型
    1年前
    8710
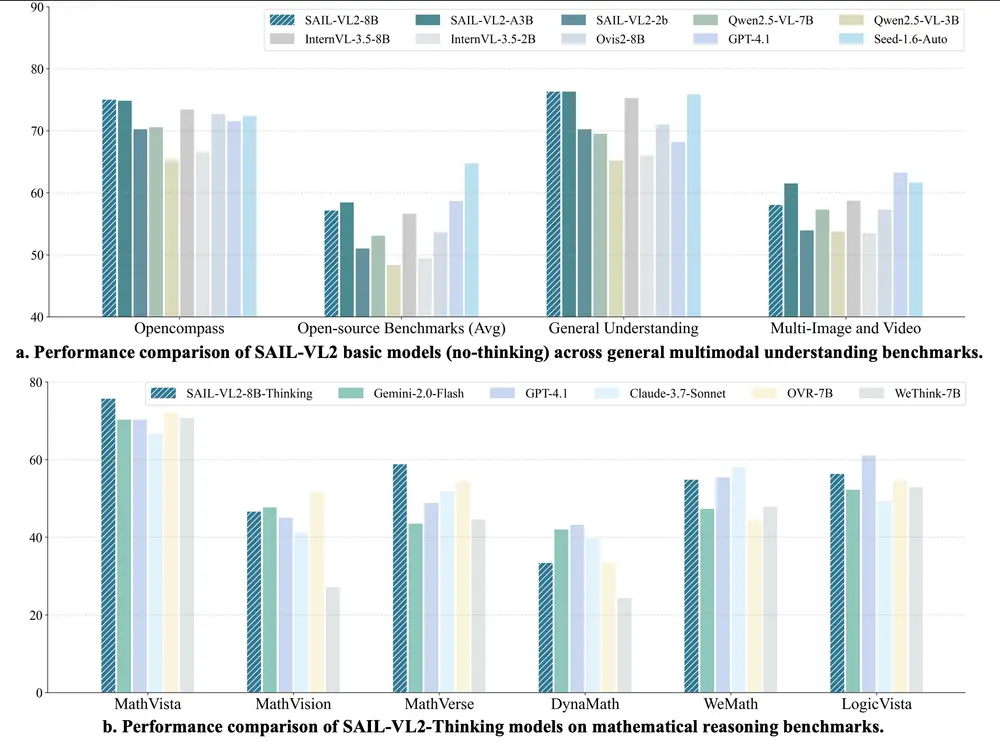
    抖音推出SAIL-VL2:面向细粒度感知与复杂推理的新一代开源视觉语言模型

    抖音推出SAIL-VL2:面向细粒度感知与复杂推理的新一代开源视觉语言模型

    由抖音 SAIL 团队与新加坡国立大学 LV-NUS 实验室联合研发,SAIL-VL2 是一款全新的开源视觉语言基础模型(Vision-Language Model, LVM),在 2B 和 8B 参...
    多模态模型# SAIL-VL2# 抖音# 视觉语言模型
    1年前
    5740
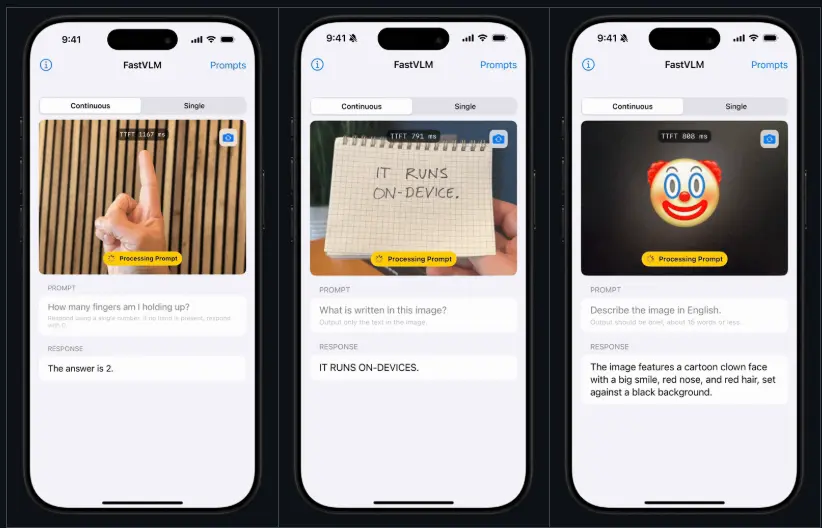
    苹果推出视觉语言模型FastVLM:用更少的视觉 Token,更快理解高分辨率图像

    苹果推出视觉语言模型FastVLM:用更少的视觉 Token,更快理解高分辨率图像

    苹果近期发布了 FastVLM系列视觉语言模型,并首次引入其自研混合视觉编码器 FastViTHD。该模型解决当前多模态系统在处理高分辨率图像时面临的效率瓶颈,尤其在移动端和实时交互场景中展现出显著优...
    多模态模型# FastVLM# 苹果# 视觉语言模型
    1年前
    2810
    视觉语言模型ClipTagger-12B:开源视频理解新标杆,性能对标 GPT-4.1,成本低至 1/15

    视觉语言模型ClipTagger-12B:开源视频理解新标杆,性能对标 GPT-4.1,成本低至 1/15

    程序化视频理解正在成为构建智能视觉系统的基础设施。从内容审核到自动化标注,从辅助功能到视频搜索引擎,开发者需要一种高效、可靠的方式,将原始视频帧转化为结构化、可搜索、可操作的数据。 为此,Infere...
    多模态模型# ClipTagger-12B# 视觉语言模型
    1年前
    7990
    像素空间推理视觉语言模型Pixel Reasoner:引入像素空间推理的概念,显著提升了视觉语言模型在视觉密集型任务中的表现

    像素空间推理视觉语言模型Pixel Reasoner:引入像素空间推理的概念,显著提升了视觉语言模型在视觉密集型任务中的表现

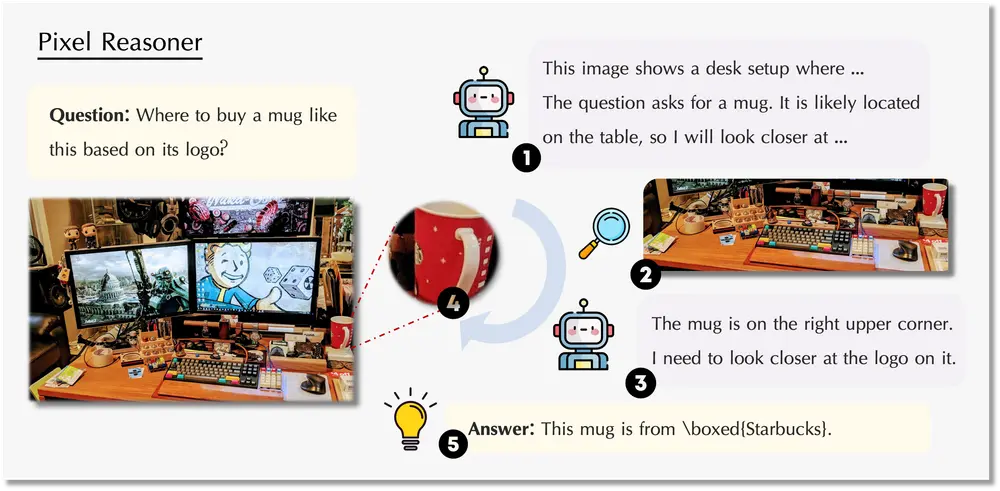
    中国科学技术大学、香港科技大学和滑铁卢大学的研究人员推出基于 Qwen2 的开源视觉语言模型Pixel Reasoner,它通过引入像素空间推理(pixel-space reasoning)的概念,显...
    多模态模型# Pixel Reasoner# 视觉语言模型
    1年前
    5740
    MiniMax推出视觉三重统一强化学习(RL)系统 V-Triune :使视觉语言模型能够在单一训练流程中联合学习视觉推理和感知任务

    MiniMax推出视觉三重统一强化学习(RL)系统 V-Triune :使视觉语言模型能够在单一训练流程中联合学习视觉推理和感知任务

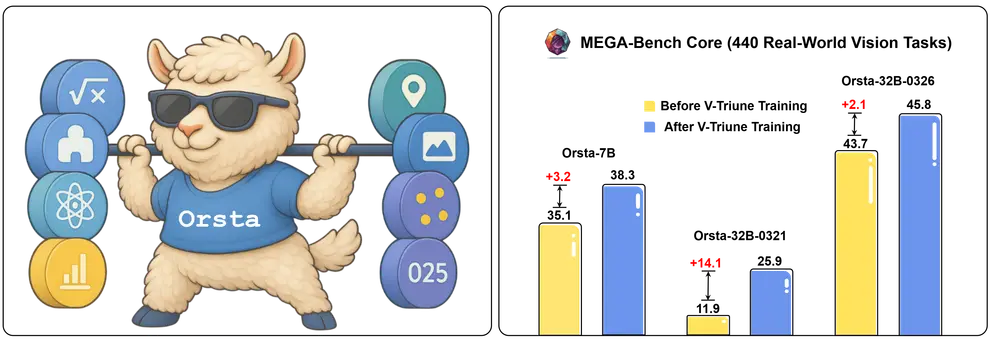
    MiniMax推出视觉三重统一强化学习(RL)系统 V-Triune ,使视觉语言模型能够在单一训练流程中联合学习视觉推理和感知任务。该系统通过整合三个互补组件——样本级数据格式化(Sample-Le...
    多模态模型# MiniMax# V-Triune# 视觉语言模型
    1年前
    7160
    苹果推出高效视觉语言模型FastVLM:通过优化视觉编码器来提高模型在处理高分辨率图像任务时的效率和性能

    苹果推出高效视觉语言模型FastVLM:通过优化视觉编码器来提高模型在处理高分辨率图像任务时的效率和性能

    苹果推出一种高效视觉语言模型FastVLM,旨在通过优化视觉编码器(Vision Encoder)来提高模型在处理高分辨率图像任务时的效率和性能。FastVLM的核心是其创新的视觉编码器 FastVi...
    多模态模型# FastVLM# 苹果# 视觉语言模型
    2年前
    4510
    新型指令式图像编辑框架FireEdit:利用区域感知的视觉语言模型(VLM),实现了对用户指令的细粒度理解和精确图像编辑

    新型指令式图像编辑框架FireEdit:利用区域感知的视觉语言模型(VLM),实现了对用户指令的细粒度理解和精确图像编辑

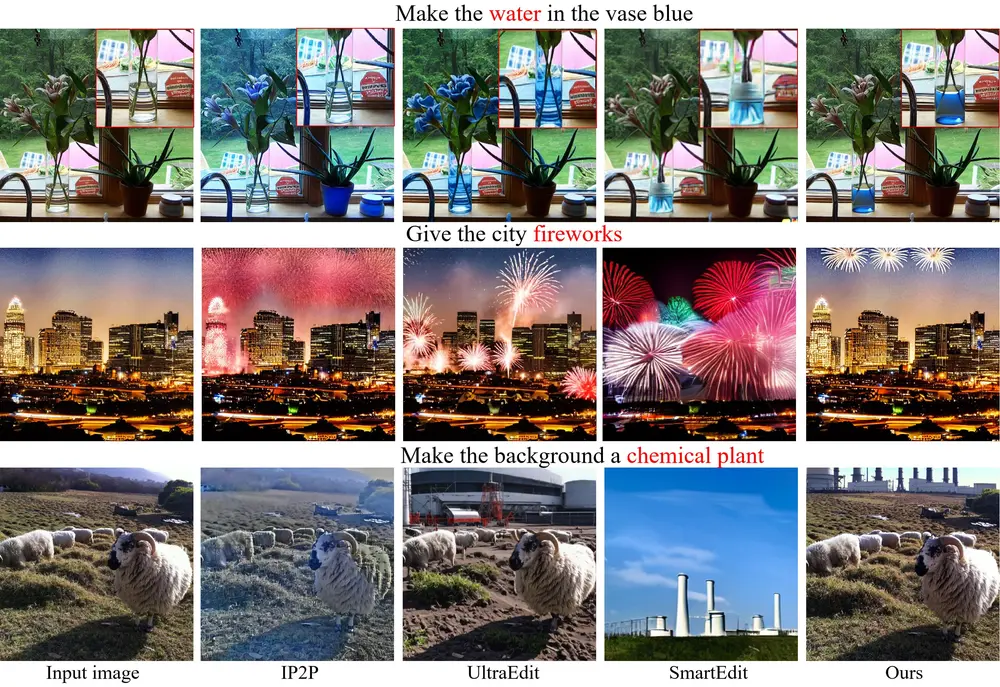
    中山大学深圳校区、腾讯混元、清华大学和香港科技大学的研究人员推出新型指令式图像编辑框架FireEdit,它通过利用区域感知的视觉语言模型(VLM),实现了对用户指令的细粒度理解和精确图像编辑。Fire...
    新技术# FireEdit# 图像编辑# 视觉语言模型
    2年前
    8480
    基于视觉语言模型的端到端多模态 SVG 生成框架OmniSVG:能够生成从简单图标到复杂动漫角色的高质量 SVG 图形

    基于视觉语言模型的端到端多模态 SVG 生成框架OmniSVG:能够生成从简单图标到复杂动漫角色的高质量 SVG 图形

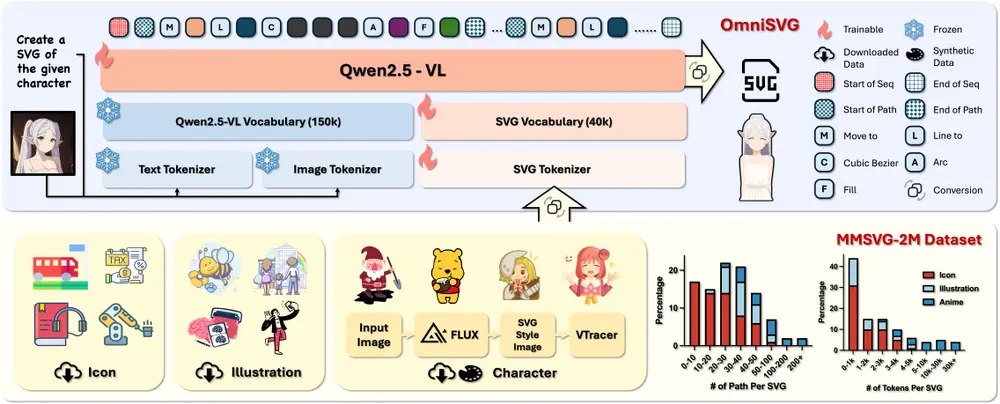
    复旦大学和阶跃星辰的研究人员推出基于视觉语言模型(VLMs)的端到端多模态 SVG 生成框架OmniSVG,能够生成从简单图标到复杂动漫角色的高质量 SVG 图形,支持文本到 SVG、图像到 SVG ...
    图像模型# OmniSVG# SVG# 视觉语言模型
    1年前
    4720
    视觉语言模型SmolDocling:以高效的方式实现端到端的多模态文档转换

    视觉语言模型SmolDocling:以高效的方式实现端到端的多模态文档转换

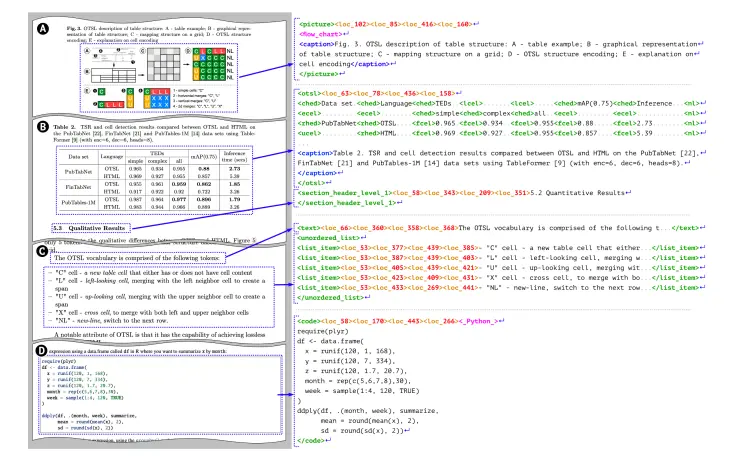
    在数字化时代,文档处理和理解是许多行业和研究领域的核心需求。从学术论文到商业报告,从技术手册到专利文件,文档的高效转换和理解对于信息提取、知识管理和自动化流程至关重要。然而,传统的文档处理方法往往依赖...
    多模态模型# SmolDocling# 文档转换# 视觉语言模型
    2年前
    8510
    Convergence 发布基于视觉语言模型(VLM)的迷你开源模型 Proxy Lite

    Convergence 发布基于视觉语言模型(VLM)的迷你开源模型 Proxy Lite

    在数字化时代,自动化与 Web 内容交互的需求日益增长。然而,现有的解决方案往往面临资源密集型、任务特定化以及缺乏透明性等问题。这些问题限制了它们的广泛适用性和社区参与度。 GitHub:https...
    多模态模型# Convergence# Proxy Lite# 视觉语言模型
    2年前
    4920
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    RSS-AIGC

    RSS-AIGC

    RSS-AIGC是一个非常简易的现代化的 RSS 订阅与 AI 内容聚合平台,专为内容创作者、研究人员和知识工作者设计。系统集成了 AI 报告生成、飞书机器人推送、多源内容聚合等高级功能,帮助用户高效地获取、管理和分析来自 Hacker News、GitHub、ArXiv 等专业平台的内容
    FeedCraft

    FeedCraft

    FeedCraft 是一个简单、强大的 RSS 源处理工具. 他可以作为一个中间件处理你的RSS源, 你可以用它来提取正文、智能翻译、通过AI生成文章摘要、通过自然语言筛选文章等. 它内置了可视化 RSS 生成器 (HTML/Curl/Search to RSS),支持将网页、API (Curl) 或搜索结果转换为 RSS 订阅源。
    h3-storyboard

    h3-storyboard

    h3-storyboard 是一个专为 MiniMax H3 视频生成模型设计的 Claude Code 技能。与大多数仅负责将文本转换为 H3 提示词格式的工具不同,h3-storyboard 深入到了导演层面:它指导用户如何将脚本拆分为镜头、如何控制表演节奏、以及如何规避 H3 在面部表情和物理模拟上的已知缺陷。
    MagicArena

    MagicArena

    MagicArena是字节跳动推出的一个采用Elo积分机制的视觉生成大模型公开对战平台。平台上有多个视觉生成大模型(文生图、文生视频、图生视频)随机两两对战,用户对生成的结果进行评价,累积定对战数据后可以查看自己的大模型排行榜。
    GitHub Copilot

    GitHub Copilot

    GitHub Copilot 是由微软旗下GitHub开发的一款AI编程工具,旨在帮助开发者更高效地编写代码。通过与主流集成开发环境(IDE)的深度集成,Copilot 提供了强大的代码补全、聊天辅助和上下文感知功能,显著提升了开发者的生产力和满意度。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      RSS-AIGC

      RSS-AIGC

      RSS-AIGC是一个非常简易的现代化的 RSS 订阅与 AI 内容聚合平台,专为内容创作者、研究人员和知识工作者设计。系统集成了 AI 报告生成、飞书机器人推送、多源内容聚合等高级功能,帮助用户高效地获取、管理和分析来自 Hacker News、GitHub、ArXiv 等专业平台的内容
      FeedCraft

      FeedCraft

      FeedCraft 是一个简单、强大的 RSS 源处理工具. 他可以作为一个中间件处理你的RSS源, 你可以用它来提取正文、智能翻译、通过AI生成文章摘要、通过自然语言筛选文章等. 它内置了可视化 RSS 生成器 (HTML/Curl/Search to RSS),支持将网页、API (Curl) 或搜索结果转换为 RSS 订阅源。
      h3-storyboard

      h3-storyboard

      h3-storyboard 是一个专为 MiniMax H3 视频生成模型设计的 Claude Code 技能。与大多数仅负责将文本转换为 H3 提示词格式的工具不同,h3-storyboard 深入到了导演层面:它指导用户如何将脚本拆分为镜头、如何控制表演节奏、以及如何规避 H3 在面部表情和物理模拟上的已知缺陷。
      MagicArena

      MagicArena

      MagicArena是字节跳动推出的一个采用Elo积分机制的视觉生成大模型公开对战平台。平台上有多个视觉生成大模型(文生图、文生视频、图生视频)随机两两对战,用户对生成的结果进行评价,累积定对战数据后可以查看自己的大模型排行榜。
      GitHub Copilot

      GitHub Copilot

      GitHub Copilot 是由微软旗下GitHub开发的一款AI编程工具,旨在帮助开发者更高效地编写代码。通过与主流集成开发环境(IDE)的深度集成,Copilot 提供了强大的代码补全、聊天辅助和上下文感知功能,显著提升了开发者的生产力和满意度。
      查看完整榜单