随着AI智能体(Agent)的普及,大模型的工作模式正在发生改变。大量长周期任务带来海量输入,反复预填充、百万级上下文会持续占用KV缓存,对HBM显存、SSD存储以及带宽都带来巨大压力。
深度求索(DeepSeek AI)正式发布了 DeepSeek-V4.1-Flash,这是一款专为解决长周期智能体(Agent)输入密集型瓶颈而设计的多模态混合专家(MoE)模型。
- Hugging Face:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
- 魔搭:https://modelscope.cn/models/deepseek-ai/DeepSeek-V4.1-Flash
这款模型支持最高100万token上下文窗口,通过FP4 KV缓存、跨层注意力复用、因果编码器-解码器架构等一系列创新,大幅降低长上下文场景下的缓存开销,非常适合长时间连续执行任务的AI代理。
模型基础规格
DeepSeek-V4.1-Flash 属于多模态MoE模型,主干网络参数量552B,额外搭载196B Engram条件记忆参数。模型原生支持图文多模态输入,以自回归形式输出文本。
在推理阶段,它的参数激活控制十分高效:预填充阶段每token仅激活8B参数,解码阶段激活16B参数。
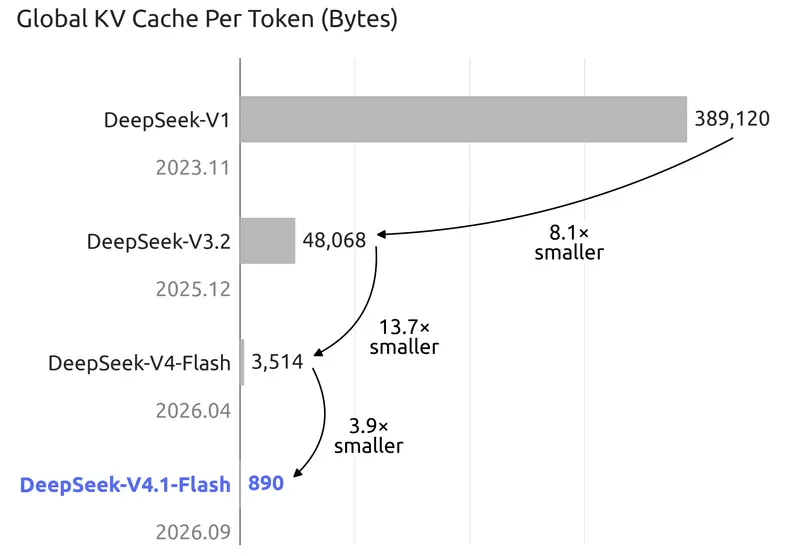
最亮眼的指标:全局KV缓存占用仅每token 890字节,大约是DeepSeek-V4-Flash的1/4,对比初代DeepSeek-V1更是缩小约437倍。
核心架构创新
因果编码器-解码器(CED)架构:预填充算力直接减半
整个模型主干一共40层,拆分为20层因果编码器 + 20层解码器。
传统解码器架构每一层都要单独计算KV缓存,而CED做了颠覆性改动:解码器的全局KV缓存,不再由解码器各层单独生成,而是从编码器最终的隐藏状态投影得到。提示词只需要送入编码器处理,直接减半预填充阶段的计算量。
模型保留128token窗口的滑动窗口注意力SWA,并且采用SWA有界重放机制。不需要把SWA KV缓存持久存入SSD,缓存丢失时,只需要重放最近128个token恢复状态,把持久化KV缓存占用压缩到V4-Flash的1/8。
CSA2 压缩稀疏注意力2:跨层共享KV,减少重复计算
V4.1-Flash 全面升级为纯CSA2压缩稀疏注意力机制,对每一个注意力层静态分配三种工作模式:
- Full模式:独立计算主KV,生成索引器K,筛选Top-512候选位置
- Reindex模式:复用上一个Full层的主KV与索引K,仅用自身的查询Q重新打分
- Reuse模式:直接复用主KV和Top-K索引,跳过索引计算,开销最低
编码器与解码器分层分组排布这套模式。解码器还搭配分层稀疏索引器:由Full层预先构建最多16384个位置的候选池,后续所有Reindex层只在候选池内检索。这意味着深层注意力的计算开销,不再随上下文长度增长而膨胀。
FP4 KV缓存与其他配套技术
模型主KV缓存采用E2M1格式的FP4量化,每16个通道共享一组E4M3缩放因子,基于NVFP4规范优化(去除全局缩放),在不明显损失效果的前提下,相比V4版本的FP8缓存几乎再减半存储。
配套技术还有:
- Single-Pass mHC:优化残差流混合,借助Mega-mHC融合内核,减少激活值内存流量;
- Engram条件记忆:196B参数记忆模块,放置在第1层、第14层,基于token查找实现稀疏访问;
- DSpark推测解码:半自回归草稿生成,搭配置信度调度验证,加速解码;
- MoE层配置:每层包含1个共享专家+384个路由专家,每一次token推理激活6个路由专家。
视觉侧采用从零训练的DeepSeek-ViT视觉编码器,搭配2D-RoPE以及3×3像素抗混叠下采样,配合两层MLP投影器,把图像转为视觉嵌入。视觉部分从预训练早期就和文本嵌入联合训练,保证多模态理解能力。
训练与后训练方案
预训练阶段,DeepSeek-V4.1-Flash 使用总量45万亿token的多模态数据集,文本和多模态数据比例7:1。
模型先在64K序列长度下完成稀疏注意力训练,在累计训练到34万亿token时,把上下文能力拓展至100万token。
后训练没有改动基础算法框架,沿用SFT→RL→在线蒸馏OPD的经典流程。效果提升主要来自数据侧:大规模自动化合成智能体任务环境,持续迭代扩展任务轨迹数据集;同时接入Claude Code、Codex、OpenCode等40多个不同模型作为教师模型做同策略蒸馏。
模型还提供推理强度连续可调选项,取值范围1~100,使用者可以自由权衡推理成本和输出准确率。
基准评测表现
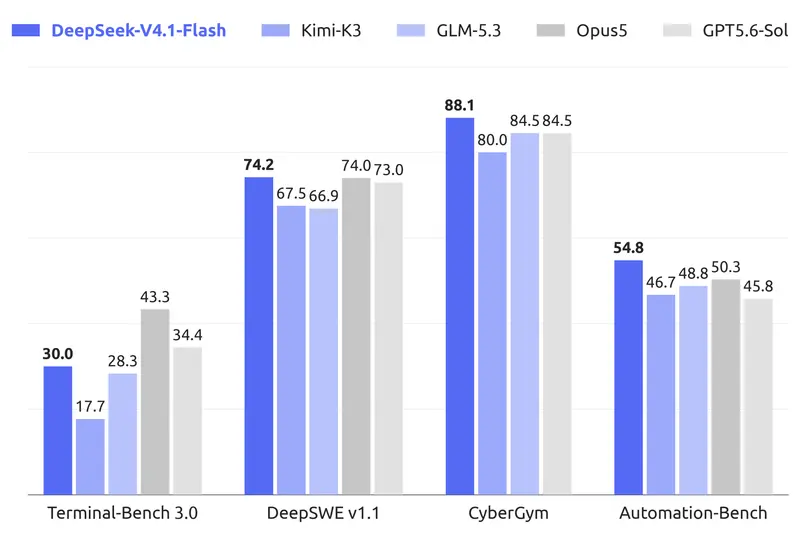
在面向智能体、自动化、代码操作的专项基准测试中,DeepSeek-V4.1-Flash展现出很强竞争力,多项指标超越DeepSeek-V4-Flash,部分项目超过Opus-5、GPT-5.6 Sol:
| 基准 | DS-V4.1-Flash | DS-V4-Flash | Opus-5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 82.7 | 89.1 | 88.8 |
| DeepSWE v1.1 | 74.2 | 54.4 | 74.0 | 73.0 |
| Terminal-Bench 4.0 | 31.2 | 7.0 | 51.8 | 39.9 |
| Automation-Bench | 54.8 | 37.7 | 50.3 | 45.8 |
| GPQA Diamond | 90.9 | 89.9 | 93.4 | 94.1 |
| Codeforces(评分) | 3471 | 3289 | n/a | n/a |
在Terminal-Bench 2.1、DeepSWE v1.1这类偏向代码智能体、自动化操作的测试集上,开源权重版本的DeepSeek-V4.1-Flash实现反超。
部署方式
模型采用MIT开源许可证发布,权重开放。在Hugging Face平台提供模型权重,原生支持vLLM、SGLang、Transformers多种推理框架。同时官方上线公共API,提供低、高、最高三档不同推理强度可选,方便开发者直接调用。
© 版权声明
文章版权归作者所有,未经允许请勿转载。