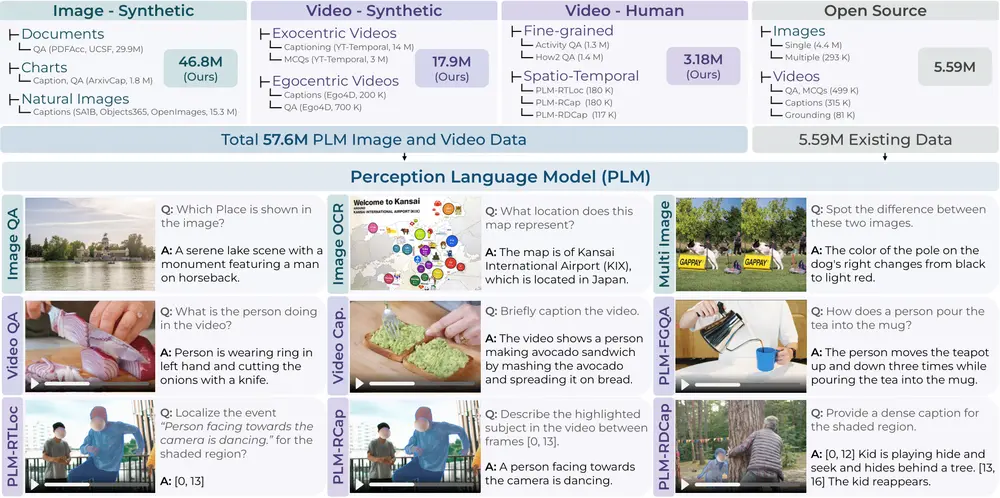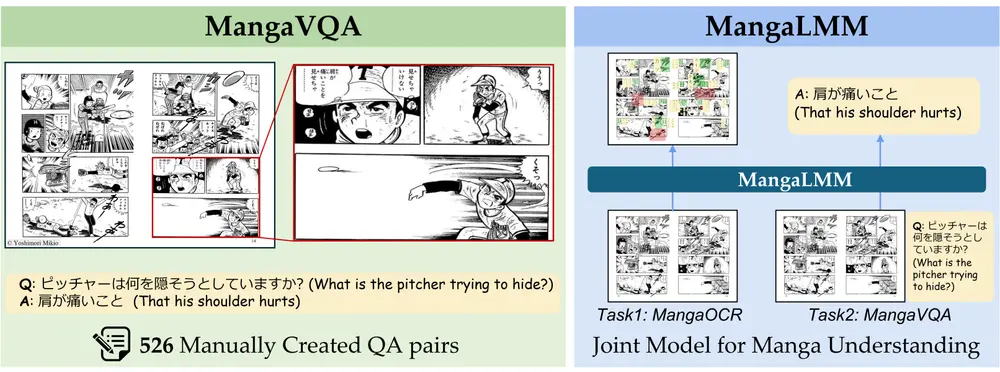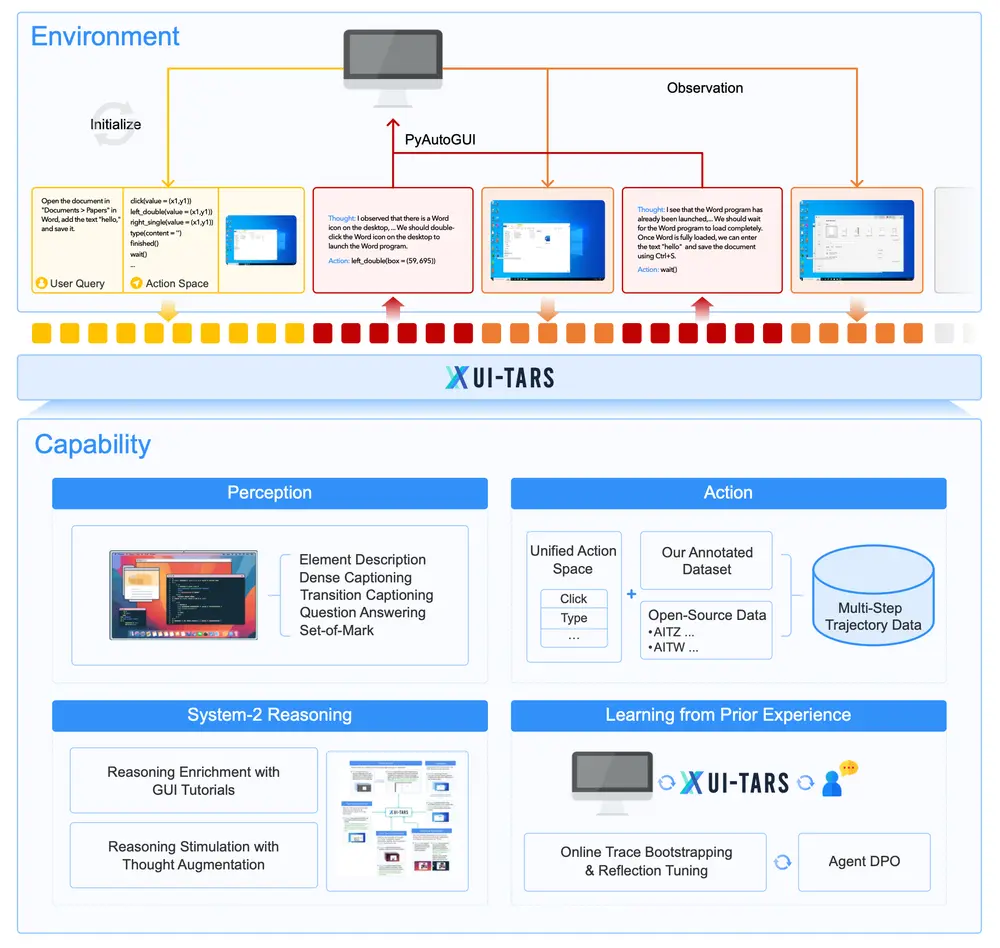
蚂蚁集团正式发布并开源百灵(Ling)系列首款原生多模态大模型 Ling-3.0-flash-VL。模型在Ling-3.0-flash MoE混合专家底座上扩展而来,原生支持图、文、视频多模态输入,主打带自我校验的视觉闭环能力,面向网页代码生成、GUI自动化、医疗报告解读等真实业务场景。
- Hugging Face BF16:https://huggingface.co/inclusionAI/Ling-3.0-flash-VL
- Hugging Face FP8:https://huggingface.co/inclusionAI/Ling-3.0-flash-VL-fp8
- ModelScope BF16:https://www.modelscope.cn/models/inclusionAI/Ling-3.0-flash-VL
- ModelScope FP8:https://www.modelscope.cn/models/inclusionAI/Ling-3.0-flash-VL-fp8
核心模型参数
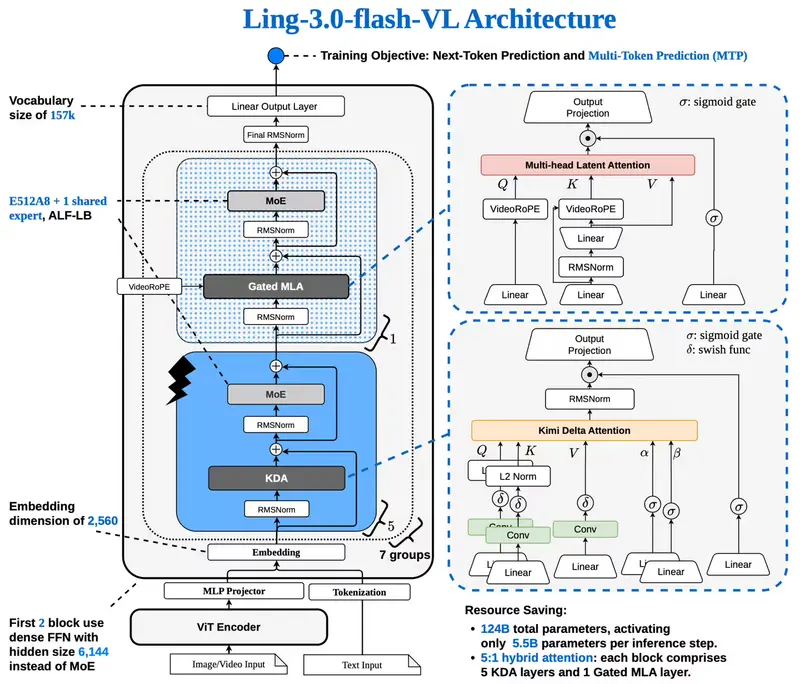
- 总参数量:124B,推理仅激活5.5B参数
- 上下文窗口:256K Token
- 输入能力:原生支持文本、图片、视频
- 架构亮点:任意分辨率视觉编码器 + VideoRoPE;语言主干为42层混合架构,KDA与Gated MLA按5:1交替排布
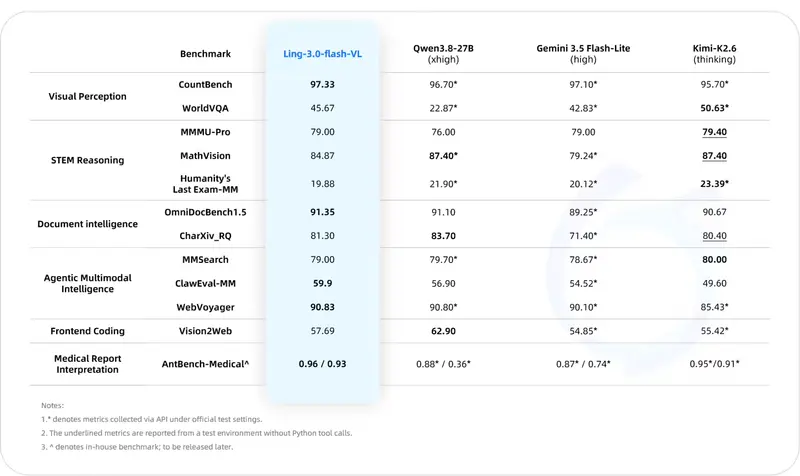
关键技术:视觉反馈闭环,任务可反复自检修正
这是本次模型最核心的亮点,跳出传统多模态模型“看一眼图片,一次性输出答案”的模式。
Ling-3.0-flash-VL 采用「观察 → 行动 → 验证 → 修正」的闭环工作流。模型完成一次操作后,会查看执行结果,对照视觉信息发现错误并迭代优化。
这套机制在三大场景体现明显:
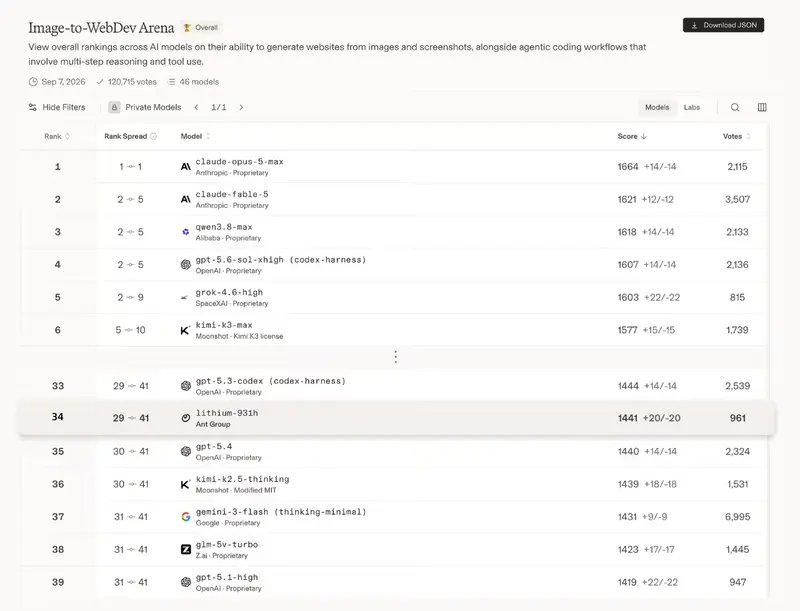
- 图片转网页开发:识别页面布局、组件之间的层级关系,生成前端代码,渲染后对比画面差异,自动修改代码。在Image-to-WebDev Arena评测中,代号linthium的该模型得分高于GPT-5.4。
- GUI界面智能体:识别软件界面元素,跨应用执行连续操作,根据屏幕画面校验任务执行情况。
- 医疗报告解读:整合多份文档数据,自动标记风险项。
训练亮点:多模态联合训练,视觉反过来增强文本能力
采用原生多模态联合训练,不是文本底座外挂视觉模块。
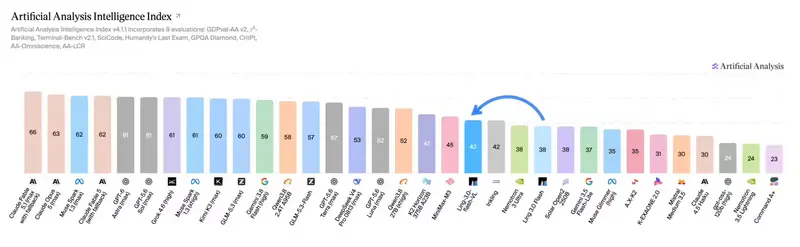
蚂蚁官方数据显示,在Artificial Analysis Intelligence Index v4.1.1.1评测中,Ling-3.0-flash-VL相比纯文本版本Ling-3.0-Flash提升4分。
也就是说,图像、视频数据的训练,没有稀释文本能力,反而对文本推理起到正向增益。
同时依托MoE架构,大总参规模但单次激活参数很小,在长视频对话、多轮视觉Agent任务中,能够维持较低推理延迟。
开源与体验渠道
- 体验入口:Ling Studio 现已上线,支持免费试用
- 开源版本:BF16、FP8权重已同步发布至Hugging Face与ModelScope
- 后续计划:FP4、INT4量化版本近期推出,方便本地部署
© 版权声明
文章版权归作者所有,未经允许请勿转载。