腾讯微信视觉团队(WeChat Vision)正式开源了 WeMM-Embedding,这是一套包含 2B、4B、9B 三种规模的通用多模态 Embedding 模型家族。它旨在解决互联网内容形态日益复杂(图文混排、短视频、文档截图等)带来的理解难题,将文本、图像、视频及交错多模态输入转化为统一的语义向量,并在微信内部多项真实业务中得到了大规模验证。
- GitHub:https://github.com/Tencent/WeMM-Embedding
- 模型:https://huggingface.co/collections/tencent/wemm-embedding
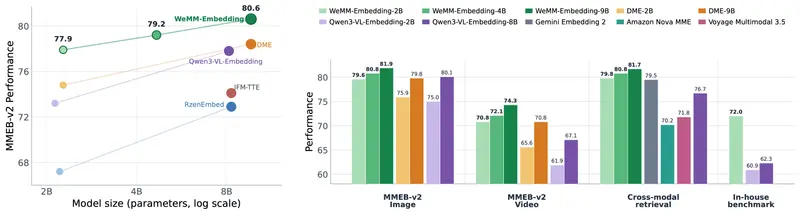
核心突破:解决传统多模态模型的四大痛点
- 原生支持复杂混合输入:
- 不再局限于“一图一文”的简单配对。WeMM-Embedding 能直接处理文章中穿插多张图片、视频搭配字幕、图文混排文档等现实场景中常见的复杂内容,完整理解整体语义。
- “套娃式”可变长度向量输出:
- 一次推理,多种规格。无需为速度和精度分别训练不同模型。推理后可直接截取不同维度的向量:短向量(如 256/512 维)适合海量索引和快速检索,长向量保留更多细节用于高精度匹配。实验显示,压缩至 256 维时仍能保留 98% 以上的性能。
- 小模型实现极高性价比:
- 2B 版本效果超越主流 8B 开源基线,9B 版本在 MMEB-v2 权威榜单上取得第一名。这意味着开发者可以用更低的算力成本获得顶尖的语义理解能力。
- 经过真实业务大规模验证:
- 不仅在学术榜单刷榜,更在微信视频号、公众号、看一看、电商等 26 项真实业务任务中完成离线验证,并经过 14 轮线上 A/B 测试,证明了其在真实互联网流量下的稳定性和有效性。
技术原理:两阶段训练与知识蒸馏
WeMM-Embedding 基于 Qwen3.5 多模态大语言模型底座构建,采用独特的训练策略:
- 架构设计:将图片、视频拆分为视觉 Token,与文本 Token 按顺序拼接,并在序列末尾插入特殊的“嵌入标记”。模型读取完所有内容后,该标记位置的状态即为整段内容的综合语义向量。
- 第一阶段:大规模多模态对齐。使用数亿条海量多样化样本(涵盖公开数据集、网页弱监督图文、视频文本对等),初步对齐文字、图片、视频的语义空间。
- 第二阶段:精选数据微调 + 跨尺度知识蒸馏。
- 难样本挖掘:专门寻找“外观相似但语义无关”的高难度负样本,配合重排模型给出的细粒度相关性分数,教会模型分辨细微差别。
- 知识蒸馏:用训练好的 9B 大模型作为“老师”,指导 2B 和 4B 小模型学习内容间的远近关系,以低成本提升小模型效果。
性能表现
| 评测基准 | 2B 版本表现 | 9B 版本表现 | 备注 |
|---|---|---|---|
| MMEB-v2 | 77.9 分 | 80.6 分 (榜首) | 超过大部分开源及闭源商业模型 |
| MMEB-v3 | 56.0 分 | 领先基线 | 在长文本检索、智能代理任务上优势明显 |
| 12套跨模态检索 | 平均 79.8 分 | 持续提升 | 视频类跨模态检索提升幅度最大 |
| 微信内部业务 | 综合得分从 60.9 提升至 72.0 | – | 证明实验室高分可迁移至真实业务 |
注意:当前版本暂不支持音频输入;模型仅做语义转化,不生成内容。
应用场景与价值
- 搜索体验升级:
- 支持以图搜文、以文搜视频、截图搜原文。用户只需粘贴一张截图或输入一句描述,即可找到语义匹配的公众号文章或视频号内容,不再依赖关键词完全匹配。
- 推荐系统优化:
- 融合标题、封面图、视频画面等多源语义信号,帮助小众、新发布的优质内容更容易被感兴趣的用户发现。
- 本地多模态知识库:
- 由于 2B 版本硬件门槛低且完全开源,个人和小团队可在本地部署,建立包含课件截图、学习视频、笔记的多模态知识库,实现隐私安全的本地检索。
- 内容聚类与管理:
- 通过生成的语义 ID,对海量内容进行自动聚类和分组,快速发现主题相近的资讯或短视频。
© 版权声明
文章版权归作者所有,未经允许请勿转载。