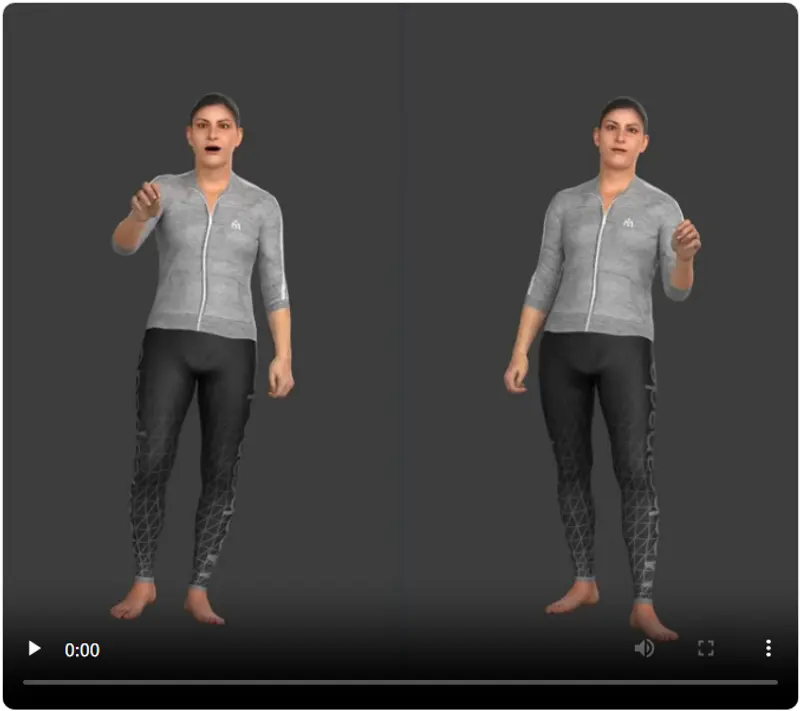
北京大学研究团队最新发布的 Motion-Omni(参考实现为 Motion-Omni-Q7)是一个端到端口语对话系统。它打破了传统数字人“先生成语音、再驱动动作”的串联流水线模式,能够同时生成同步的语音和全套全身肢体动作(包括面部表情、手部手势、上半身姿态及下半身细微动作)。
- 项目主页:https://step-out.github.io/Motion-Omni-Page/
- GitHub:https://github.com/step-out/Motion-Omni
这一突破使得数字人的响应速度大幅提升(RTF 0.78,总响应时间 4.32 秒,快于实时),且动作与语音天生同步,显著提升了交互的自然度和真实感,推动 AI 交互从“录播感”向“真播感”迈进。
核心突破:为什么 Motion-Omni 如此重要?
1. 真正的端到端协同,而非模块拼接
- 传统痛点:主流方案是“大模型思考 → TTS 生成音频 → 音频驱动动作模型”。这种两步走不仅延迟高(需等整段音频生成完才能算动作),而且语音与动作割裂,常出现口型对不上、手势节奏脱节或风格夸张(像演讲而非聊天)的问题。
- Motion-Omni 方案:将大语言模型、语音生成器、全身动作生成器整合在一个框架中协同训练。动作直接源自语音生成器的内部隐藏状态,而非解码后的音频波形。这意味着动作在语音生成的同时就在同步产生,无需等待,且能捕捉到语义、重音和韵律等深层信息。
2. 极速响应:比传统串联方案快 5.4 倍
- 离线生成但也极快:虽然目前仍需接收完整用户语音后再生成回复(非流式),但其整体响应时间仅需 4.32 秒,实时因子(RTF)为 0.78(即生成速度快于真人说话速度)。
- 对比优势:相比相同音频下调用 LOM 教师级联模型的传统方案(耗时 23.35 秒),Motion-Omni 的速度提升了 5.4 倍。
3. 全身四分立动作解码
- 不同于仅关注面部的模型,Motion-Omni 将人体拆分为面部、双手、上半身、下半身四个独立分支并行生成。
- 对话适配手势:生成的动作是伴随说话的交际手势(如强调、举例时的自然手部动作),模拟普通人日常聊天的肢体习惯,而非舞台式的夸张表演。
技术原理:如何做到“天生同步”?
Motion-Omni 基于 Qwen2.5-7B 大模型构建,其工作流程如下:
- 语音编码:用户语音转为特征。
- 大脑思考:LLM 理解内容并构思回复。
- 同步生成:
- 语音生成器产出离散语音单元,并输出关键的内部隐藏状态。
- 动作生成器的四个分支(面、手、上身、下身)直接读取这份隐藏状态,结合时序信息并行生成动作编码。
- 最终输出:语音单元转为音频,动作编码转为 3D 姿态参数。两者时间轴天然对齐,直接输出音频+全套动作序列。
关键点:联合协同训练至关重要。实验证明,若冻结语音模块只训动作,手势与语音节奏会明显错位。只有让语音和动作模块一起调整,才能实现完美的韵律匹配。
性能表现:质量与速度的平衡
在自建的首个开放式自由对话全身数字人评测集 SwDA-500 上,Motion-Omni 展现了卓越性能:
- 语音能力:在 VoiceBench 上优于 LLaMA-Omni 等同类模型,语音清晰度错误率最低,接近专业 TTS。
- 动作质量:
- 节奏相关性:在非老师推理模型中排名第一,手势重音完美对齐语音重音。
- 动作多样性:手势丰富不重复。
- 唇形同步:优于 EMAGE、MambaTalk 等基线。
- 主观盲测:真人评测中,其手势自然度显著优于外部动作模型,与顶配串联流水线(LOM 教师)持平。
- 效率:在单张 GPU 上即可实现快速推理,大幅降低了部署门槛。
当前局限
- 非流式交互:目前为离线生成模式,需听完完整问话后再生成回复,暂不支持边听边说的实时流式交互。
- 语言限制:训练素材全为英文,手势习惯符合英语对话场景,直接用于中文可能存在文化违和感。
- 动作上限:动作质量受制于生成伪标签的“老师”模型,难以超越老师的能力范围。
- 缺乏个性化:暂不支持指定特定人物的身份、情绪或独特手势风格。
© 版权声明
文章版权归作者所有,未经允许请勿转载。