Jina AI 发布 jina-embeddings-v5-omni:文本向量字节级一致,无需重建索引即可实现图文音视跨模态检索,Small 模型性能媲美 LCO-7B
在多模态检索领域,传统方案往往要求端到端重训整个模型,导致文本向量分布改变,迫使企业重建海量文本索引。Jina AI 正式发布 jina-embeddings-v5-omni,彻底打破这一困境。
- 官方介绍:https://jina.ai/news/jina-embeddings-v5-omni-multimodal-embeddings-for-text-image-audio-and-video/
- 模型:https://huggingface.co/collections/jinaai/jina-embeddings-v5-omni
该系列模型包括 v5-omni-small (1.6B) 和 v5-omni-nano (0.9B) 两个版本,支持文本、图像、音频、视频及 PDF 的统一向量表示。其核心突破在于:文本向量与原有的 jina-embeddings-v5-text 完全字节级一致。这意味着,现有使用 v5-text 的用户无需重新向量化或重建任何文本索引,只需引入新模态数据,即可立即获得跨模态搜索能力。
核心亮点:零迁移、高性能、模块化
1. 文本向量字节级一致,无需重建索引
- 冻结主干:v5-omni 完全冻结了强大的 v5-text 骨干网络(基于 Qwen3/EuroBERT),确保相同文本输入产生完全相同的向量输出。
- 无缝升级:现有 Elasticsearch 或其他向量数据库中的文本索引可直接复用。新增图像、音频、视频数据时,只需创建新索引或追加字段,无需迁移历史数据。
- 生产友好:极大降低了多模态检索系统的部署与维护成本,实现了“即插即用”的多模态能力扩展。
2. 小参数大性能,媲美超大模型
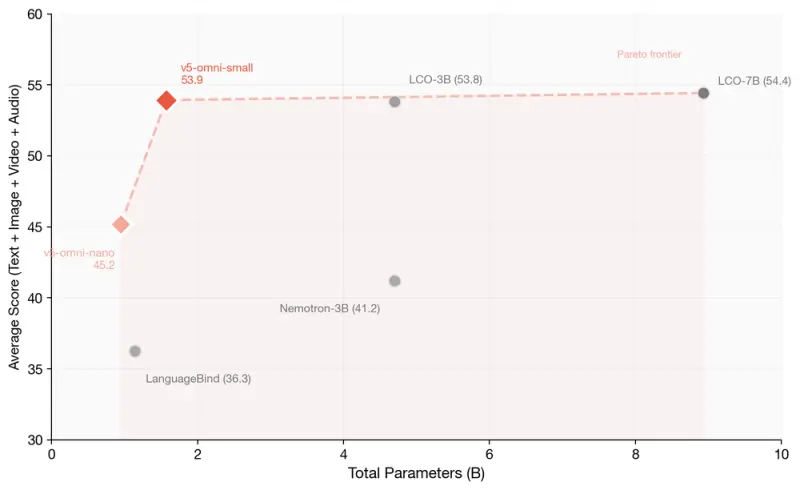
- v5-omni-small (1.6B):在四种模态上的平均得分达到 53.93,以 5.7 倍更小的参数量 媲美 LCO-7B (54.43),是 2B 参数以下表现最好的开源多模态向量模型。
- v5-omni-nano (0.9B):仅凭 0.95B 参数量即可提供具备竞争力的文档检索能力,适合资源受限的端侧或边缘计算场景。
- 高效训练:仅训练 0.35% 的权重(投影层),训练速度提升 1.8-3.9 倍,GPU 内存占用减少 42-64%。
3. 模块化架构,灵活部署
- 独立加载:架构完全模块化。仅文本部署时不加载视觉/音频权重(占用空间与 v5-text 完全相同);仅图像部署时跳过音频;全能型部署则加载所有组件。
- 多任务 LoRA:继承 v5-text 的四个任务特定 LoRA 适配器(检索、文本匹配、分类、聚类),并为每个任务变体训练单独的投影权重,确保各场景下的最优表现。
- Matryoshka 表示学习:支持多种向量维度(32 至 1024/768),允许在存储成本与检索精度之间灵活权衡。
4. 全模态支持,包括视频与 PDF
- 视频处理:将视频视为视觉帧序列,可选择融合提取的音频片段,实现视听联合理解。
- PDF 支持:原生支持 PDF 文档解析与向量化,适用于复杂文档检索场景。
- 高分辨率视觉:Small 版本采用 Qwen3.5-2B ViT (SigLIP2) 编码器,支持 2×2 空间合并,平衡细节保留与计算效率。
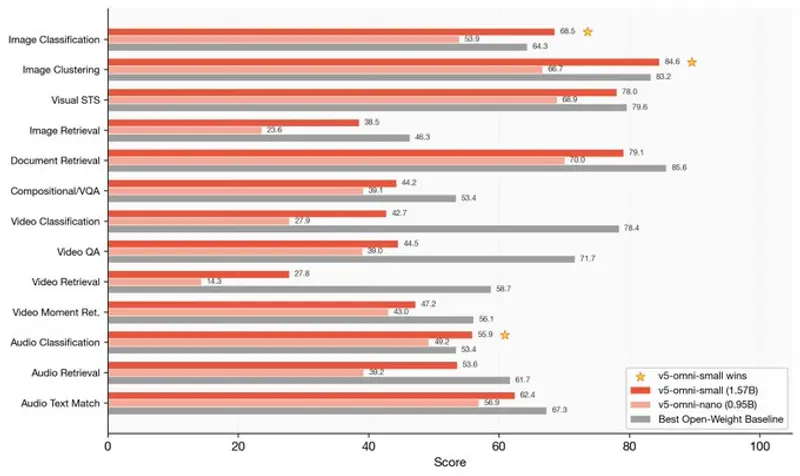
模型规格对比
| 特性 | jina-embeddings-v5-omni-small | jina-embeddings-v5-omni-nano |
|---|---|---|
| 基础文本模型 | jina-embeddings-v5-text-small (Qwen3-0.6B) | jina-embeddings-v5-text-nano (EuroBERT-210m) |
| 总参数量 | ~1.56B | ~1.04B |
| 支持模态 | 文本、图像、音频、视频、PDF | 文本、图像、音频、视频、PDF |
| 向量维度 | 1024 (Matryoshka: 32-1024) | 768 (Matryoshka: 32-768) |
| 最大序列长度 | 32,768 tokens | 8,192 tokens |
| 视觉编码器 | Qwen3.5-2B ViT (SigLIP2) | SigLIP2 Base |
| 音频编码器 | Whisper-large-v3 | Whisper-large-v3 |
| 适用场景 | 云端高精度检索、复杂多模态任务 | 端侧部署、低延迟要求、资源受限环境 |
快速开始
1. Elasticsearch 集成(零迁移示例)
如果您已在使用 jina-embeddings-v5-text,无需更改现有文本索引。只需为多模态内容创建新索引:
PUT multimodal-semantic-index
{
  "mappings": {
    "properties": {
      "content": {
        "type": "semantic_text",
        "inference_id": ".jina-embeddings-v5-omni-small"
      }
    }
  }
}

// 摄入文本
POST multimodal-semantic-index/_doc
{
  "content": "'Kraft Dinner' is what Canadians call macaroni and cheese."
}

// 摄入图像 (Base64)
POST multimodal-semantic-index/_doc
{
  "content": "data:image/png;base64,iVBORw0KGgoAAAAN..."
}

// 跨模态搜索:用德语文本查询英文/图像内容
GET multimodal-semantic-index/_search
{
  "query": {
    "semantic": {
      "field": "content",
      "query": "Was bedeutet 'Kraft Dinner' für Kanadier?"
    }
  }
}
2. Hugging Face / Python 使用
from sentence_transformers import SentenceTransformer
import torch
from PIL import Image

model = SentenceTransformer(
    "jinaai/jina-embeddings-v5-omni-small-retrieval",
    model_kwargs={"dtype": torch.bfloat16},
)

# 文本编码
text_emb = model.encode("What is knowledge distillation?", prompt_name="query")

# 图像编码
img = Image.open("photo.jpg")
img_emb = model.encode(img)

# 计算跨模态相似度
similarity = model.similarity(text_emb, img_emb)
print(f"Similarity: {similarity}")
3. Jina API 调用
curl https://api.jina.ai/v1/embeddings \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -d '{
    "model": "jina-embeddings-v5-omni-small",
    "task": "retrieval.query",
    "dimensions": 1024,
    "input": ["What does this image show?"],
    "images": ["data:image/png;base64,..."]
  }'
Jina AI 通过 jina-embeddings-v5-omni 证明:强大的多模态能力不必以推翻现有基础设施为代价。通过“冻结主干+轻量投影”的模块化设计,它实现了性能与效率的完美平衡,更为企业提供了平滑演进至多模态检索的最佳路径。
© 版权声明
文章版权归作者所有,未经允许请勿转载。