在传统视觉语言模型(VLM)中,视频往往被简化为不连续的静态图像序列,导致模型难以理解因果关系、物体动态及时间连续性。Perceptron Mk1 应运而生——这是由 Meta FAIR 前科学家 Armen Aghajanyan 创立的 Perceptron Inc. 推出的旗舰专有模型,旨在构建真正的“物理 AI”。
- 官方介绍:https://www.perceptron.inc/blog/introducing-perceptron-mk1
Mk1 不仅以低于竞争对手 80-90% 的成本(输入 $0.15/M tokens,输出 $1.50/M tokens)提供企业级视频分析能力,更在空间推理、时间连续性及物理定律理解上实现了突破。它在 EmbSpatialBench 和 VSI-Bench 等权威基准测试中取得 SOTA 成绩,性能比肩 GPT-5 与 Gemini 3.1 Pro,却拥有接近“Lite”版本的价格结构,标志着视频智能从“实验性研究”迈向“大规模工业应用”的新纪元。
核心亮点:物理推理、时间连续、极致性价比
1. “物理 AI”:理解因果与动态,而非仅识别像素
- 物理定律推理:Mk1 能联合推理物体位置、速度与时间读数。例如,通过分析篮球在空中的轨迹与计时器读数,精准判断投篮是否在蜂鸣器响起前完成。
- 复杂场景解析:支持高密度场景中的像素级指向与计数(多达数百个物体),并能高可靠性地读取模拟仪表、时钟等传统数字视觉系统的盲区。
- 世界知识融合:具备强大的通用历史与世界知识,能仅凭视觉风格准确识别复古影片年代(如 1906 年纽约建筑影像),并结合内容描述提供深度语境。
2. 原生时间连续性架构
- 非离散帧处理:不同于传统 VLM 将视频视为独立图片,Mk1 专为时间连续性设计,能在高达 32K token 的上下文窗口中以 2 FPS 处理原生视频流。
- 对象恒常性:即使在遮挡、快速运动或长时间跨度下,也能保持对同一对象身份的追踪,这对机器人导航、安防监控至关重要。
- 结构化时间码返回:开发者可通过自然语言查询长视频中的特定时刻,模型直接返回精确时间码,极大简化视频剪辑与事件检测流程。
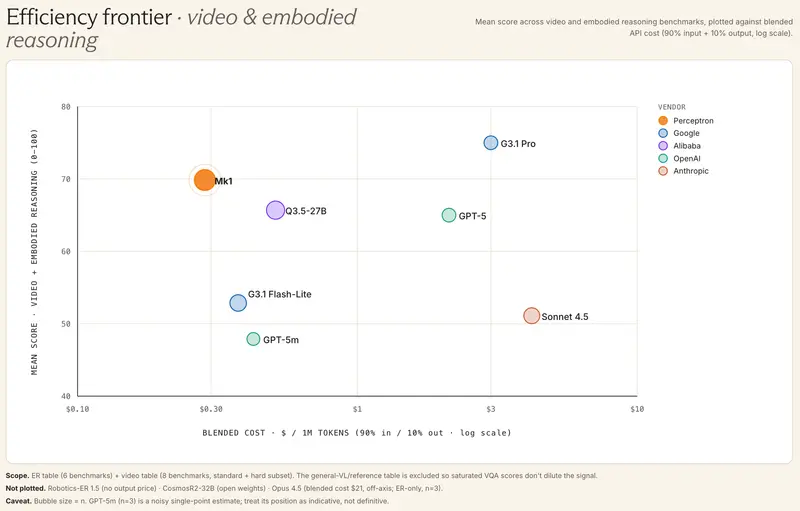
3. 效率前沿:SOTA 性能,Flash 价格
- 极致成本控制:
- 输入:$0.15 / 百万 tokens
- 输出:$1.50 / 百万 tokens
- 综合成本:约 $0.30 / 百万 tokens,比 GPT-5 和 Gemini 3.1 Pro 便宜 80-90%。
- 性能对标:在保持低成本的同时,其推理分数达到或超过前沿模型,占据“效率前沿”的独特生态位。
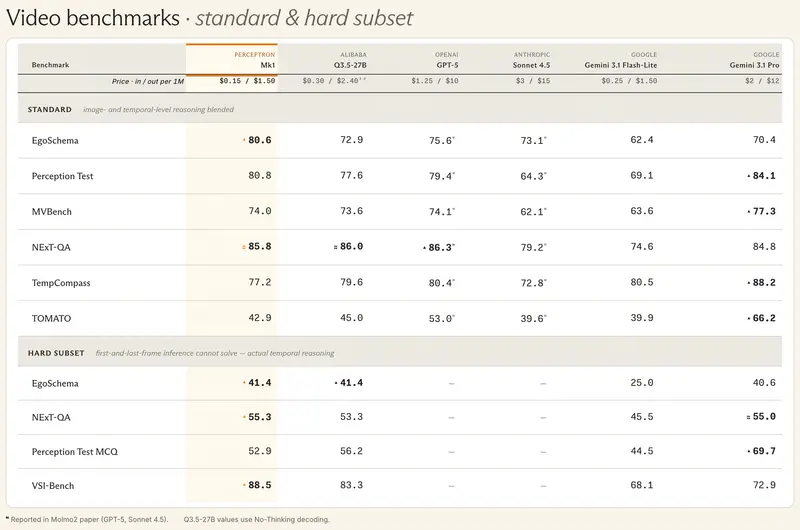
4. 基准测试全面领先
| 基准测试 | 任务类型 | Perceptron Mk1 得分 | 对比表现 |
|---|---|---|---|
| EmbSpatialBench | 空间推理 | 85.1 | 超越 Google Robotics-ER 1.5 及阿里 Q3.5-27B |
| RefSpatialBench | 指代表达理解 | 72.4 | 大幅领先 GPT-5m 及 Sonnet 4.5 |
| EgoSchema (Hard) | 视频因果推断 | 41.4 | 持平阿里 Q3.5-27B,显著击败 Gemini 3.1 Flash-Lite |
| VSI-Bench | 实际时间推理 | 88.5 | 所有比较模型中的最高分 |
开发者平台与 SDK
Perceptron 提供 Python SDK,将高级感知能力转化为易用函数:
- Focus:根据自然语言提示,自动缩放并裁剪至帧的特定区域(如“聚焦于左侧穿红衣服的人”)。
- Counting:针对密集场景优化的计数功能,支持数百个物体的精准统计。
- Contextual Learning:支持少样本学习,仅需提供几个示例即可让 Mk1 适应特定垂直领域任务。
许可策略:闭源旗舰 + 开源替代
- Perceptron Mk1 (API):闭源专有模型,专为企业级高性能、高安全性需求设计,通过 API 提供服务。
- Isaac 系列 (Open Weights):开放权重模型,托管于 Hugging Face。为需要本地部署、最大控制权或定制微调的企业提供商业许可证选项。
© 版权声明
文章版权归作者所有,未经允许请勿转载。