在当前 AI 领域,多模态模型往往面临“理解强则生成弱”、“功能单一且训练昂贵”的困境。Lance 是由字节跳动最新发布的轻量级、原生统一多模态模型。它仅凭 30 亿(3B)激活参数,便在单一框架下同时实现了图像与视频的理解、生成和编辑,并在多项基准测试中超越众多开源乃至部分闭源大型模型。
- 项目主页:https://lance-project.github.io
- GitHub:https://github.com/bytedance/Lance
- 模型:https://huggingface.co/bytedance-research/Lance
Lance 采用创新的双专家架构与多任务协同学习机制,在仅需 128 张 A100 GPU 的低成本预算下从零完成训练。它不仅打破了传统模型的功能边界,更以极高的能效比证明了“小而美”在多模态时代的巨大潜力。
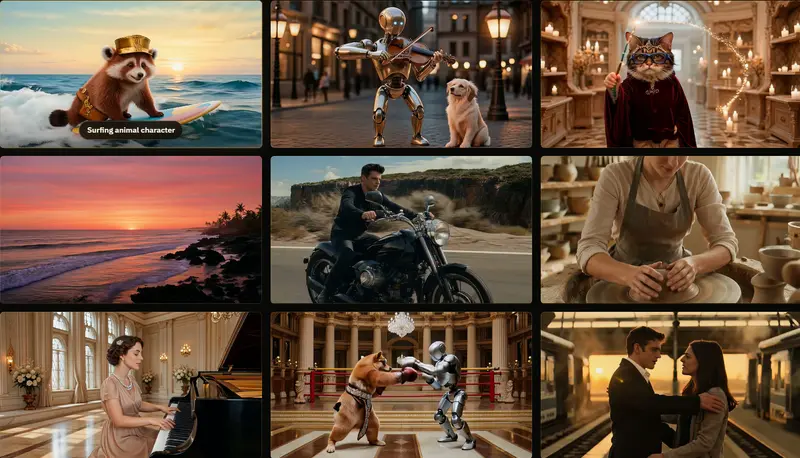
核心亮点:全能统一、轻量高效、协同进化
1. 真正的“全栈”多模态能力
Lance 并非简单的功能拼接,而是通过统一架构实现四大核心能力的深度融合:
- 图像理解:精准识别画面内容、OCR 文字提取、复杂场景问答及深度语义分析。
- 图像生成与编辑:
- 文生图:高保真还原复杂提示词,准确控制物体数量、颜色及空间位置。
- 智能编辑:支持物体替换、风格迁移、元素增删及主体定制,编辑效果自然无痕。
- 视频理解:动态内容描述、动作计数、时序变化分析及视频问答,超越多数专用理解模型。
- 视频生成与编辑:
- 文生视频:生成画面清晰、动作连贯、语义高度贴合的视频片段。
- 物理模拟:能够模拟重力、流体等物理规律,确保视频动态的真实感。
- 视频编辑:支持基于文本的视频内容修改,保持时空一致性。
2. 3B 参数,极致轻量与高效
- 小参数大能量:仅使用 3B 激活参数,却在图像生成、视频生成及编辑任务上取得强劲表现,大幅降低推理延迟与显存占用。
- 低成本训练:采用分阶段多任务训练配方,在 128 张 A100 GPU 上即可完成从零到 SOTA 的训练,成本远低于同类百亿/千亿参数模型。
- 易于部署:轻量化设计使其更适合边缘设备、移动端及对成本敏感的生产环境。
3. 双专家架构与协同学习
- 统一输入处理:将文本、图像、视频转换为统一序列,通过专门的位置编码区分视觉信息类型,避免模态混淆。
- 双专家分工:
- 理解专家:专注于语义解析、逻辑推理与文字生成。
- 生成专家:专注于像素级渲染、视频帧合成与画面编辑。
- 共享上下文:两者共用同一套上下文信息,确保理解与生成的语义一致性。
- 多任务协同:理解任务为生成提供精准语义指导,生成任务反向增强对视觉细节的理解,实现“1+1>2”的效果。
4. 分阶段训练,稳步进阶
- 基础对齐:首先学习图文视频的基本对应关系。
- 能力扩展:引入编辑、定制等复杂任务,拓宽模型技能树。
- 精细调优:最后阶段进行高强度微调,提升画质、连贯性及物理真实感。
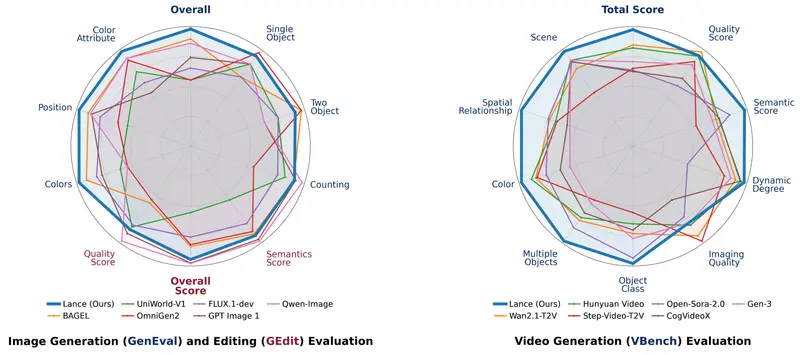
性能测试结果
Lance 在多个权威基准测试中表现卓越,验证了其“小参数、高性能”的优势:
| 任务领域 | 测试表现 | 关键优势 |
|---|---|---|
| 图像生成 | 统一模型最高分 | 复杂提示还原度高,物体/颜色/位置控制精准 |
| 视频生成 | 基准测试第一 | 画面清晰,动作连贯,语义贴合度极佳 |
| 图像编辑 | 综合得分领先 | 背景/材质/主体修改自然,无伪影,优于所有同类开源模型 |
| 视频理解 | 统一模型最高分 | 超越多数专用理解模型,动态分析能力强 |
| 整体效能 | 极高性价比 | 3B 参数实现媲美大模型的全能表现,训练/推理成本大幅降低 |
技术意义
Lance 的发布标志着多模态 AI 进入了一个新阶段:不再盲目追求参数规模,而是通过架构创新与数据效率实现能力跃迁。
- 统一范式的胜利:证明了理解与生成可以在同一轻量框架下完美共存,无需牺牲任何一方。
- 民主化多模态创作:低训练与部署成本使得更多中小企业甚至个人开发者能够拥有顶级的多模态 AI 能力。
- 物理世界的初步理解:对重力、流体等物理规律的模拟,预示着 AI 正从“像素统计”迈向“世界模型”的初级形态。
© 版权声明
文章版权归作者所有,未经允许请勿转载。