阿里发布 Qwen3.8-Omni-Flash:百万上下文全模态模型,主打代理式音视频理解阿里巴巴通义千问团队正式发布了 Qwen3.8-Omni-Flash,号称业界首个围绕 Agent(智能体)能力 构建的全模态模型。该模型能够同时理解文本、图像、音频和视频,并通过内置的推理与工具使用...多模态模型早报# Qwen3.8-Omni-Flash# 通义千问1个月前770
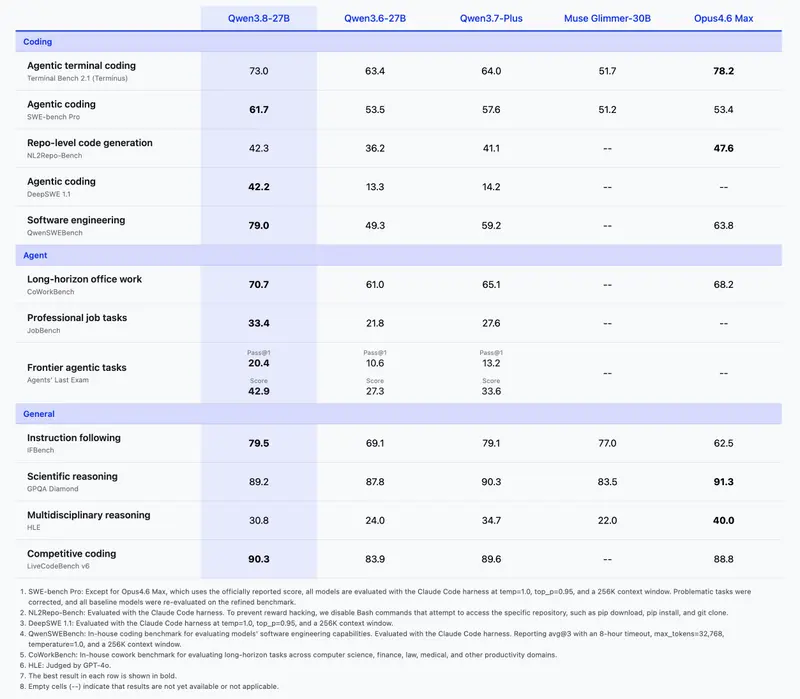
阿里开源 Qwen3.8-27B:270 亿参数稠密模型,编程与办公能力超越 Qwen3.7-Plus阿里巴巴通义千问团队于 8 月 14 日晚间正式开源 Qwen3.8-27B 模型。作为一款原生多模态稠密(Dense)架构模型,它在保持适中参数量级的同时,实现了性能的显著跃升,尤其在编程和办公场景...多模态模型# Qwen3.7-Plus# Qwen3.8-27B# 通义千问2个月前1490
阿里正式发布 Qwen3.8-Max:2.4 万亿参数,下周开源权重,还将开源 Qwen3.8-27B 版本阿里巴巴通义千问团队今日正式发布了 Qwen3.8-Max,这是 Qwen 家族迄今最强大的模型。其总参数量达到惊人的 2.4 万亿(激活参数 95B),在编程、办公、科研及长周期任务上实现了全面跃升...早报# Qwen3.8-27B# Qwen3.8-Max# 通义千问3个月前3420
阿里前通义千问负责人林俊旸创业:瞄准世界模型与具身智能,拟融资数亿美元估值达20亿,红杉高榕接触中据多方消息证实,前阿里巴巴通义千问大模型技术负责人 林俊旸 已正式开启创业旅程,成立全新AI实验室。目前,该实验室正寻求数亿美元融资,投后估值预计将达到 20亿美元 左右。顶级投资机构 高榕创投 和 ...早报# 林俊旸# 通义千问6个月前2260
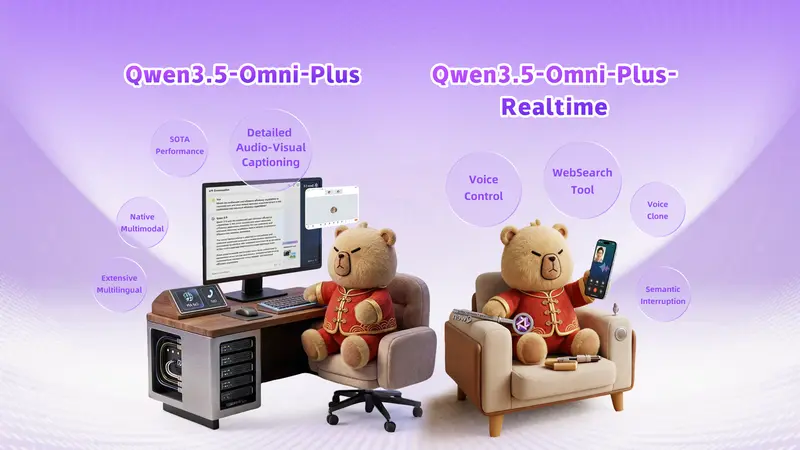
阿里通义千问发布 Qwen3.5-Omni:全模态原生大模型,215 项 SOTA 碾压 Gemini 3.1 Pro“能听、能看、能思考、能执行,还能像真人一样打断和克隆声音。” 阿里巴巴正式发布了其最新一代全模态原生大模型——Qwen3.5-Omni。这款模型不仅在文本、图像、音频、视频的理解上实现了全面融合,更...多模态模型早报# Qwen3.5-Omni# 通义千问# 阿里7个月前7210
阿里通义千问系列再添新成员,Qwen3 模型即将发布阿里云通义千问开源负责人林俊旸在社交平台 X 上发文暗示,备受期待的Qwen3 系列模型有望于今日正式发布。尽管具体发布时间尚未完全确认,但种种迹象表明,这一全新系列模型将在本周内与公众见面。 值得一...早报# Qwen3# 通义千问2年前6650
Manus 与阿里通义千问达成战略合作,在国产模型和算力平台上实现 Manus 全部功能Manus在其官方微博宣布,已与阿里通义千问团队达成了一项战略合作。此次合作将基于通义千问系列的开源模型,在国内的模型和算力平台上实现Manus的所有功能。目前,两家公司的技术团队已经开始紧密合作,目...早报# Manus# 通义千问2年前3800
阿里EMO 模型上线通义千问APP,用照片 + 音频生成唱歌视频阿里巴巴在今年2月份就公开了创新框架EMO,它是一个能够根据音频生成表情丰富的肖像视频的系统。你只需要提供一张静态的照片和一段语音,EMO就能创造出一个视频,视频中的人物头像会根据语音的内容和情感变化...工具# EMO 模型# 通义千问3年前1,5640
通义千问视觉理解模型 Qwen-VL升级版:Qwen-VL-Plus、Qwen-VL-Max阿里云宣布通义千问视觉理解模型 Qwen-VL 再次升级,继 Plus 版本之后推出 Max 版本,升级版模型拥有更强的视觉推理能力和中文理解能力,能够根据图片识人、答题、创作、写代码,并在多个权威测...新技术# Qwen-VL-Max# Qwen-VL-Plus# 视觉理解模型3年前1,3060