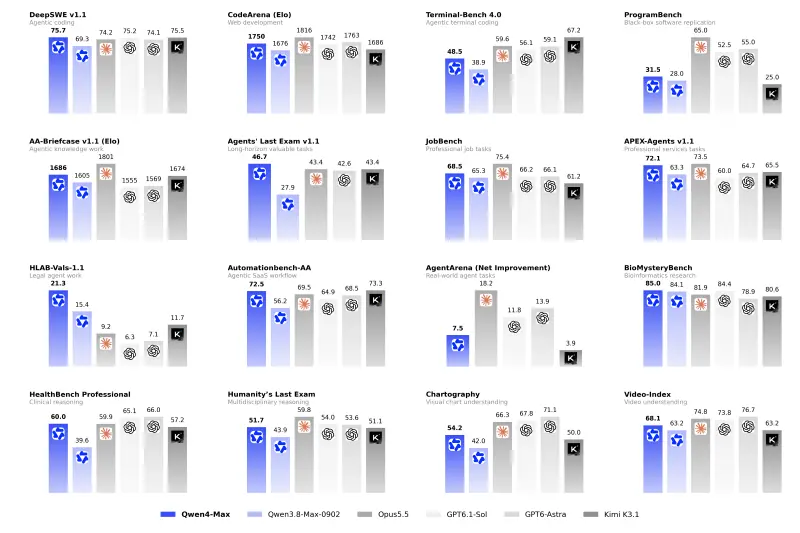
新阿里发布 Qwen4-Max:2.4T 参数稀疏 MoE 基座,原生视觉、百万上下文,面向全链路工业与科研 Agent11 月 16 日,阿里巴巴正式推出全新一代基座大模型 Qwen4-Max。作为 Qwen4 系列的首款旗舰模型,Qwen4-Max 拥有 2.4 万亿(2.4T)主干参数,具备原生视觉理解能力,支持...大语言模型早报# Qwen4-Max# 阿里巴巴7小时前60
谷歌推出 Gemini 4 Hydrogen:面向日常执行与智能体工作流的高效能模型谷歌今日正式发布 Gemini 4 Hydrogen,这是其 Gemini 4 系列中专注于速度与效率的模型。与擅长深度长时程推理的 Gemini 4 Carbon 和 Argon 不同,Hydrog...大语言模型早报# Gemini 4 Hydrogen# 谷歌3天前120
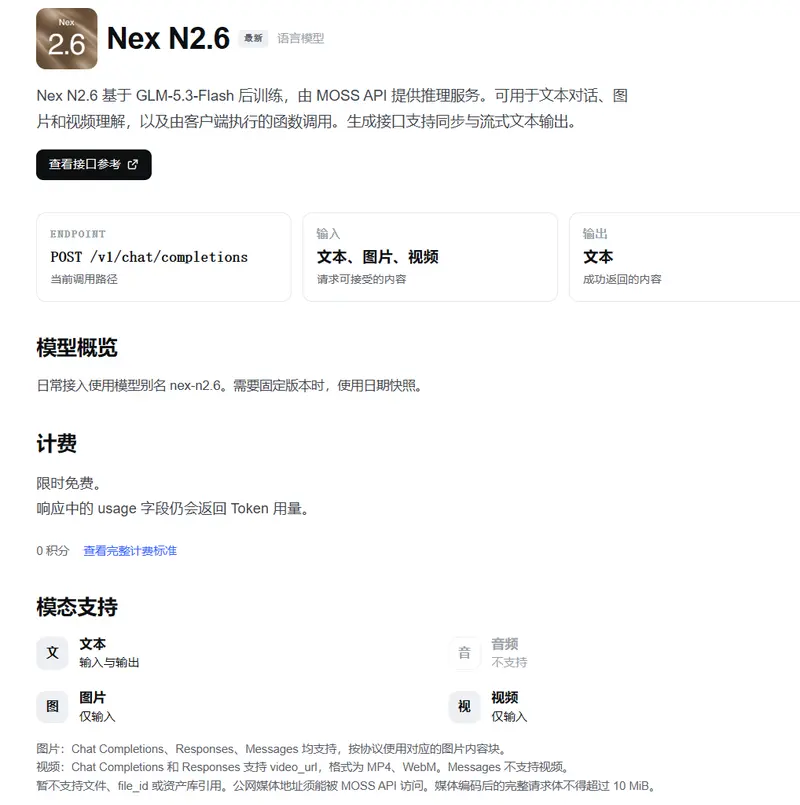
Nex-AGI 发布 Nex-N2.6:321B 参数多模态智能体模型,工具调用遵循度达 100%Nex-AGI 正式推出其最新多模态智能体模型 Nex-N2.6。该模型基于 GLM-5.3-Flash 构建,总参数量约为 321B,本次发布提供了 FP8 量化权重。Nex-N2.6 专为计算机使...大语言模型# Nex-AGI# Nex-N2.64天前110
百度发布文心 5.5 Flash Preview:2800 亿总参、支持百万上下文,兼顾编程 3D 建模能力11 月 11 日,百度正式推出其最新基础模型文心 5.5 Flash Preview。该模型总参数量达 2800 亿,采用混合稀疏架构,每次推理仅激活 140 亿参数。凭借这一设计,文心 5.5 F...大语言模型早报# 文心 5.5 Flash Preview# 百度5天前230
谷歌最强模型 Gemini 4 Carbon 全面上线,面向复杂长程任务与多智能体工作流的前沿模型11 月 10 日,谷歌正式向付费开发者、企业、科学家及 Google AI Ultra 订阅用户开放 Gemini 4 Carbon。作为谷歌目前能力最强的模型,Carbon 专为测试模型智能极限的...大语言模型早报# Gemini 4 Carbon# Google AI Ultra# 谷歌6天前190
Meta 推出轻量高效模型 Muse Ember:面向 Agent 高频任务,百万上下文,性价比领先Meta 正式推出 Muse Ember,这是其当前体量最小、运行效率最高的模型,定位面向智能体高频重复的复杂推理任务,覆盖工具调用、编码子任务、请求路由、信息提取以及长文档解析场景。 在同等推理部署...大语言模型早报# Meta# Muse Ember7天前240
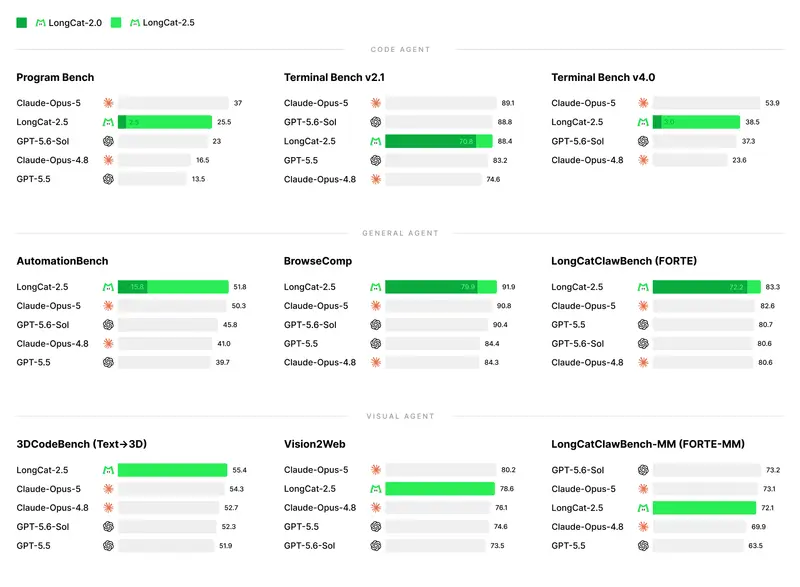
美团龙猫正式开源LongCat-2.5:原生多模态长程智能体模型,1M 上下文、MIT 协议可商用11月2日,美团龙猫对外发布适配长程智能体任务的原生多模态模型LongCat-2.5;11月9日,美团官宣该模型开源。 官方介绍:https://longcat.ai/blog/longcat-2.5...大语言模型# LongCat-2.5# 美团龙猫1周前310
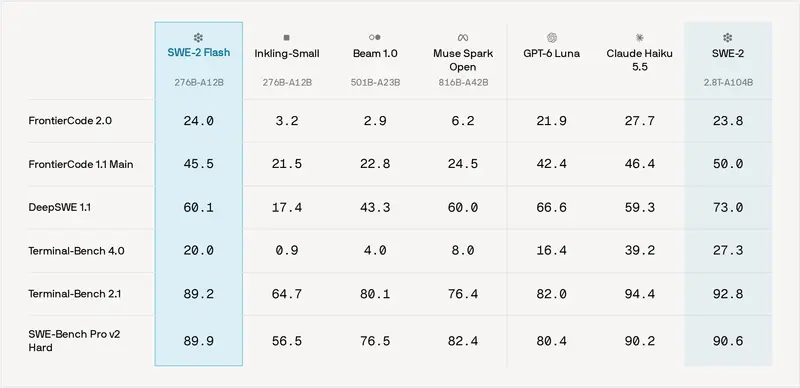
Cognition 发布 SWE-2 Flash:新增中期训练阶段,Terminal-Bench 从 0.9% 拉至 20%Cognition 正式推出 SWE-2 Flash 编码模型。该模型以较低的计算成本和较高的推理速度,处理日常软件工程中的自动化、代码审查、功能开发及文档更新等任务。其核心训练流程在传统强化学习之前...大语言模型早报# Cognition# SWE-2 Flash1周前400
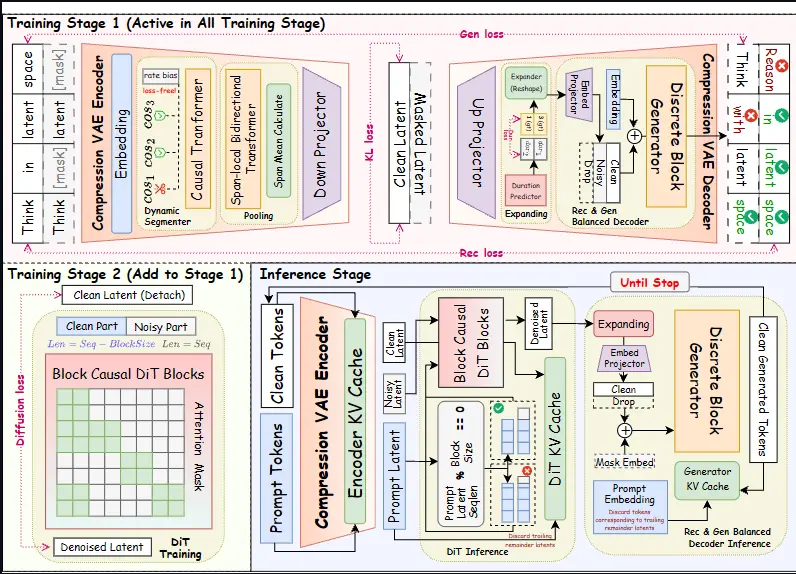
Cola2 模型提出连续语义压缩与离散生成协同适应方案,在 346B tokens 下性能逼近 Llama-3-8B由香港大学、字节跳动 Seed、北京大学和中国人民大学联合研究团队提出的 Cola2 模型,针对层次化语言生成中的核心痛点,提出了一种基于连续语义压缩与平衡离散生成的协同自适应建模方案。该方案将文本动...大语言模型# Cola21周前270
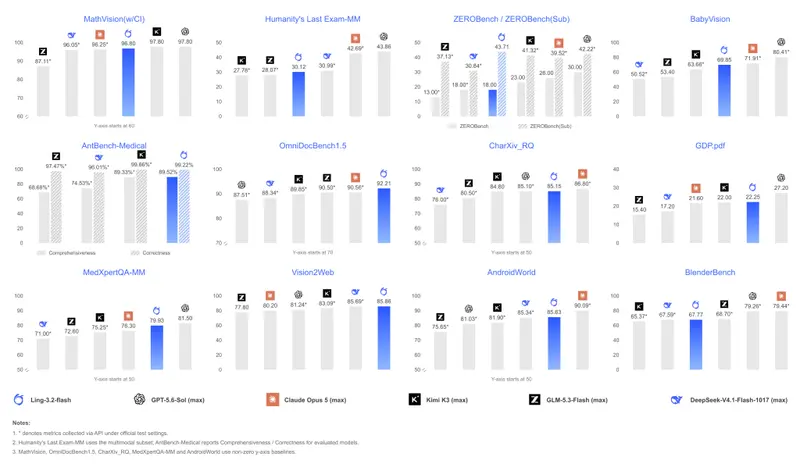
蚂蚁百灵发布原生多模态模型 Ling-3.2-flash ,支持 1M 上下文与 MoE 架构蚂蚁百灵官方团队今日正式发布原生多模态模型 Ling-3.2-flash。该模型具备 560B 总参数与 25B 激活参数,并支持 1M(100万)上下文窗口。 原生多模态架构与四大能力扩展 Ling...大语言模型早报# Ling-3.2-flash# 蚂蚁百灵1周前550
Thinking Machines Lab 发布 Inkling 2 Small:594B 总参数 MoE 多模态模型,下周 Apache 2.0 开源Thinking Machines Lab今天正式推出了其第二代混合专家(MoE)模型 Inkling 2 Small。该模型总参数达 594B,激活参数仅为 17B,原生支持图像输入与可变努力(Va...大语言模型# Inkling 2 Small# Thinking Machines Lab2周前460
百度文心开源 ERNIE-5.5-Flash-Base,280B 稀疏 MoE 架构支持 1M 上下文与 FP8 混合精度训练百度文心大模型发布ERNIE-5.5-Flash-Base,对外放出ERNIE 5.5 Flash完成预训练阶段后的权重文件。该版本没有经过中间阶段训练、指令微调、强化学习等后训练流程,开发者可以将它...大语言模型# ERNIE-5.5-Flash-Base# 百度文心2周前290