SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    视频模型

    共 213 篇文章
    用于文生视频、图生视频、视频编辑的模型
    百科工具模型ComfyUIAI合集web UI提示词
    大语言模型多模态模型图像模型语音模型3D模型Flux衍生视频模型世界模型决策模型
    排序
    发布更新浏览点赞
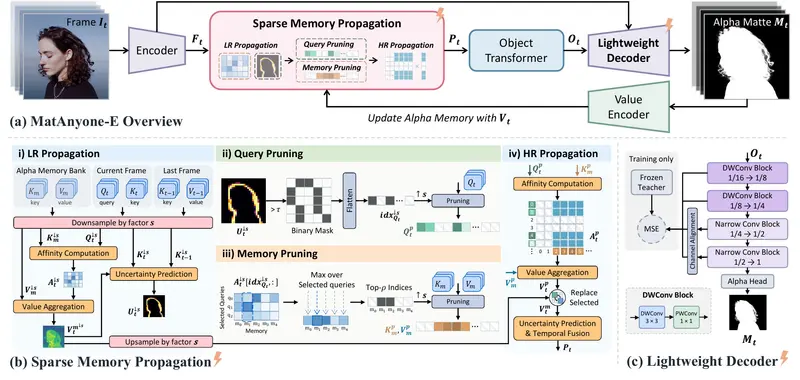
    MatAnyone-E:基于稀疏记忆传播的高效高分辨率视频抠像模型,先低分辨筛不确定区域,仅局部做高精度匹配

    MatAnyone-E:基于稀疏记忆传播的高效高分辨率视频抠像模型,先低分辨筛不确定区域,仅局部做高精度匹配

    高分辨率视频抠像面临的核心矛盾在于:既要保留发丝、柔和透明度等细微视觉特征,又要维持严格的帧间时序一致性。传统的基于记忆(Memory-based)的方法通过将当前帧特征与早期帧存储的信息进行全局匹配...
    视频模型# MatAnyone-E# 视频抠像
    1周前
    270
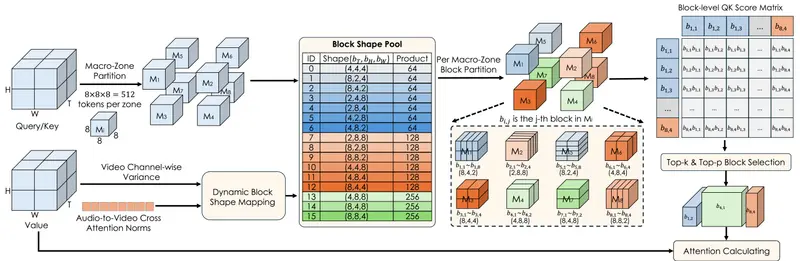
    Prism:复旦+腾讯混元+浙大提出动态稀疏注意力框架,实现原生2K音视频联合生成高效训练

    Prism:复旦+腾讯混元+浙大提出动态稀疏注意力框架,实现原生2K音视频联合生成高效训练

    复旦大学、腾讯混元团队与浙江大学联合推出 Prism,一款面向原生2K音视频联合生成的动态稀疏注意力科研框架,解决直接训练2K音视频大模型算力昂贵、音画同步易受损的难题。 项目主页:https://f...
    视频模型# Prism
    1个月前
    1100
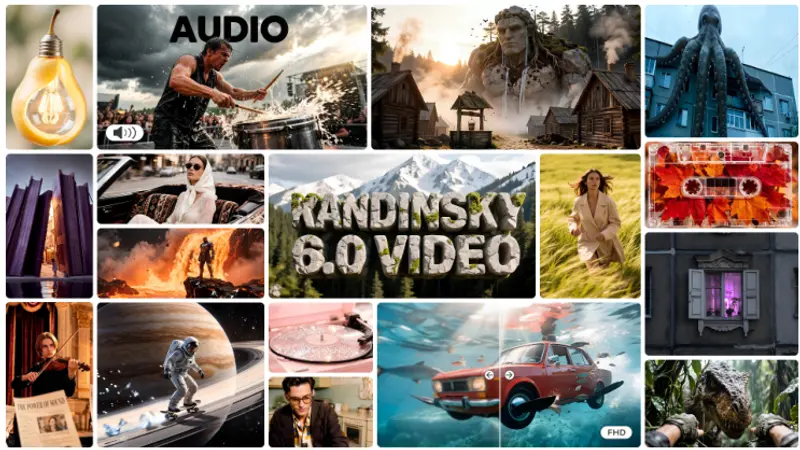
    Kandinsky Lab发布Kandinsky 6.0 Video :开源一体化音视频扩散模型,原生支持唇形同步,家用显卡可跑

    Kandinsky Lab发布Kandinsky 6.0 Video :开源一体化音视频扩散模型,原生支持唇形同步,家用显卡可跑

    来自俄罗斯Kandinsky Lab正式推出Kandinsky 6.0 Video,这是一套可以文本/图片直接生成同步音视频的扩散模型家族,分为3B参数的Lite轻量版,以及29B参数的Pro高性能版...
    视频模型# Kandinsky 6.0 Video# Kandinsky Lab
    1个月前
    1100
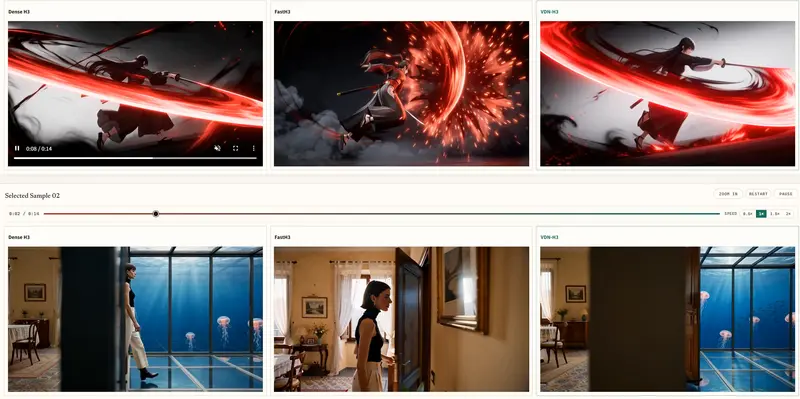
    VDN‑Minimax‑H3:VideoDeltaNet 适配 MiniMax‑H3,伯克利团队推出混合注意力加速方案,8卡B200仅11.23秒产出14.4秒768p视频,实现超实时生成

    VDN‑Minimax‑H3:VideoDeltaNet 适配 MiniMax‑H3,伯克利团队推出混合注意力加速方案,8卡B200仅11.23秒产出14.4秒768p视频,实现超实时生成

    由加州大学伯克利分校、Impossible, Inc、德克萨斯大学奥斯汀分校三方组成的研究团队正式发布 VDN‑Minimax‑H3(VDN‑H3),一套基于MiniMax H3基座打造的混合注意力加...
    视频模型# MiniMax H3# VDN‑Minimax‑H3# VideoDeltaNet
    2个月前
    1660
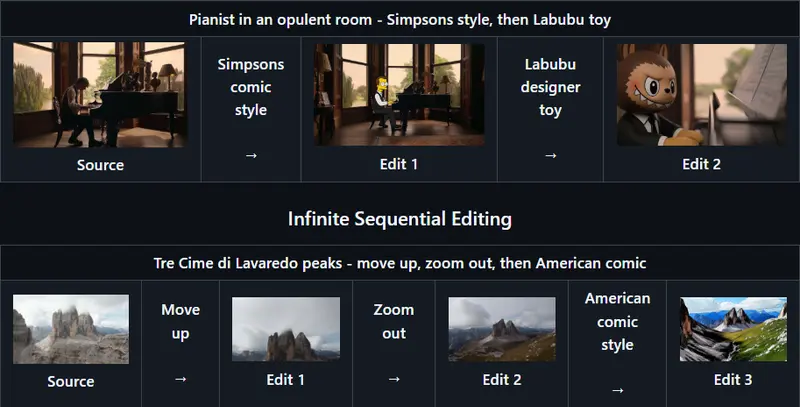
    InfinityEdit:浙大与阿里推出无限流视频编辑AI,边播边改,历史画面不重绘

    InfinityEdit:浙大与阿里推出无限流视频编辑AI,边播边改,历史画面不重绘

    现在绝大多数AI视频编辑工具,本质都是“原地改写”:给一段固定时长视频,AI把整段全部重新渲染,输出长度和原视频完全一致。 这种模式只能处理已经完整存在的视频,却无法应对源源不断的流式画面——比如正在...
    视频模型# InfinityEdit# 视频编辑
    3个月前
    1360
    Sand.ai 发布 MAGI-2 Preview:1140 亿参数统一音视频生成模型

    Sand.ai 发布 MAGI-2 Preview:1140 亿参数统一音视频生成模型

    Sand.ai 今日正式开源 MAGI-2 Preview,这是一个拥有 1,140 亿(114B)总参数的统一音视频生成模型。基于 MagiMoE 架构构建,该模型在推理时每个 Token 仅激活 ...
    视频模型# MAGI-2 Preview# Sand AI
    3个月前
    1540
    LTX推出LTX-2.5:开放权重视频世界模型原生接入ComfyUI,GB200芯片6.8秒生成10秒图像转视频

    LTX推出LTX-2.5:开放权重视频世界模型原生接入ComfyUI,GB200芯片6.8秒生成10秒图像转视频

    从Lightricks拆分独立出来的开放世界模型公司LTX,正式发布新一代视频与世界模型LTX-2.5。本次版本首发就和ComfyUI达成战略合作,实现原生集成,依托节点式工作流工具,方便开发者和创作...
    视频模型# LTX-2.5
    3个月前
    1620
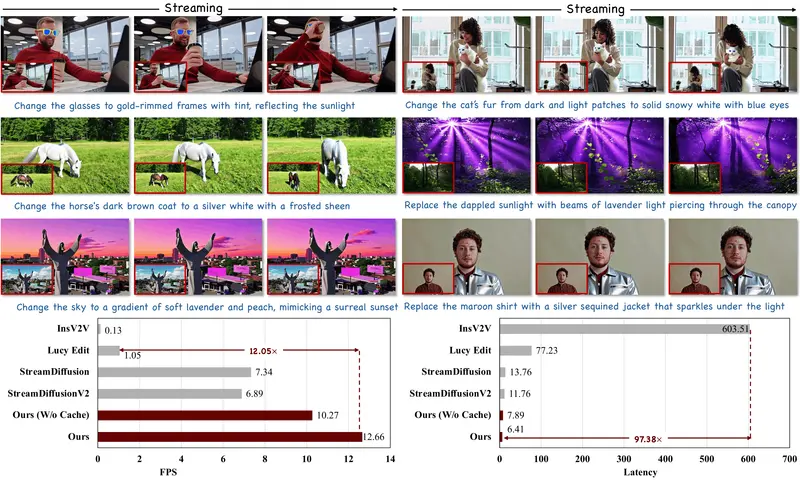
    LiveEdit:清华&港科大推出实时流式视频编辑框架,12.66 FPS 且背景不闪烁

    LiveEdit:清华&港科大推出实时流式视频编辑框架,12.66 FPS 且背景不闪烁

    在流式视频编辑领域,长期以来存在两个难以调和的矛盾:一是编辑后的背景随时间推移容易出现闪烁或漂移;二是为了实现高质量编辑,模型往往需要双向注意力机制,导致延迟过高,无法满足实时交互需求。 项目主页:h...
    视频模型# LiveEdit# 视频编辑
    3个月前
    1350
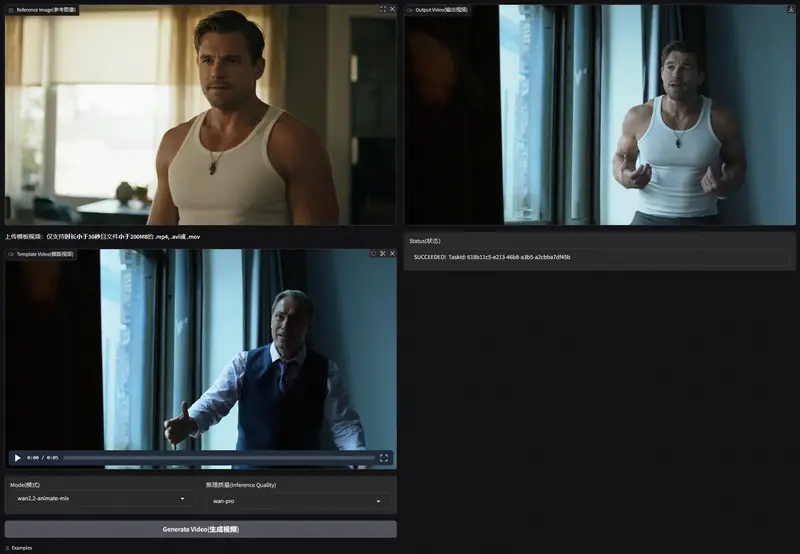
    Wan-Animate-2:阿里通义实验室开源人物动画系统,支持跨形象动作复刻与实时生成

    Wan-Animate-2:阿里通义实验室开源人物动画系统,支持跨形象动作复刻与实时生成

    阿里通义实验室发布Wan-Animate-2及其轻量化版本Wan-Animate-2-Lite,实现静态人物图片驱动生成连贯动态视频。该系统摒弃传统骨骼识别或特征压缩中间步骤,直接读取参考视频原始画面...
    视频模型# Wan-Animate-2# 通义实验室
    3个月前
    1930
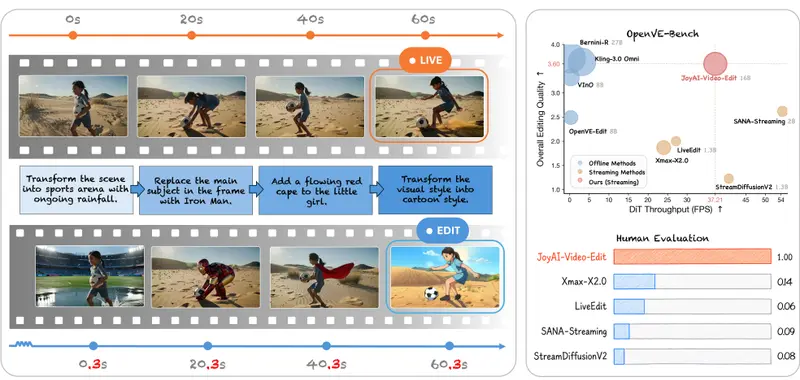
    京东开源自研 JoyAI-Video-Edit:实现 720P/30fps 实时流式视频编辑

    京东开源自研 JoyAI-Video-Edit:实现 720P/30fps 实时流式视频编辑

    京东今日正式宣布开源自研的实时流式视频编辑模型 JoyAI-Video-Edit。该模型突破了传统视频编辑“先渲染后观看”的模式,支持用户在视频播放过程中实时修改人物、场景与物体,真正实现了“边观看...
    视频模型# JoyAI-Video-Edit# 京东
    3个月前
    1500
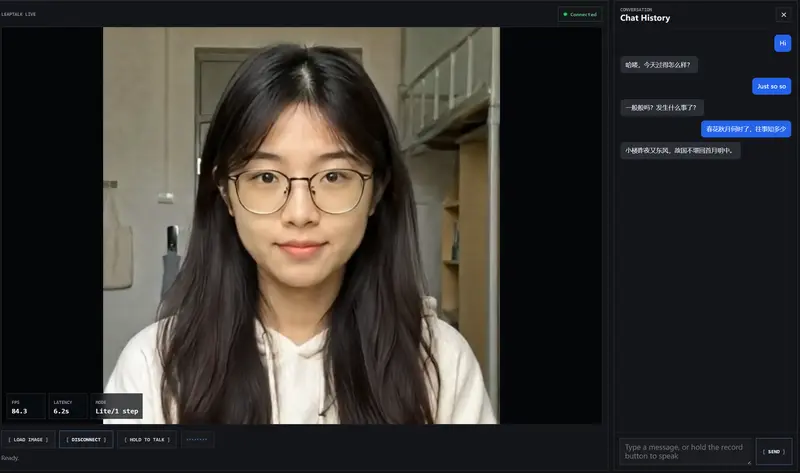
    LeapTalk:单步推理实现 200 FPS 实时说话头生成,打破延迟与质量权衡

    LeapTalk:单步推理实现 200 FPS 实时说话头生成,打破延迟与质量权衡

    在数字人、虚拟主播和实时视频通话等场景中,说话头生成(Talking Head Generation)长期面临着一个两难困境:多步扩散模型画质高但延迟大,无法流式输出;而实时自回归方法虽快,却容易出现...
    视频模型# LeapTalk
    3个月前
    1500
    MiniMax H3 正式开源:通用全模态生成模型,实现文本、图像、音视频的统一理解与生成

    MiniMax H3 正式开源:通用全模态生成模型,实现文本、图像、音视频的统一理解与生成

    8月3日,MiniMax 如约发布了其通用全模态生成模型 H3 的开源权重。这不仅是对此前谣言的有力回击,更标志着 AI 视频生成进入了一个新的阶段:文本、图像、视频和音频不再是割裂的模块,而是在单一...
    视频模型# MiniMax H3
    4个月前
    2770
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    MagicArena

    MagicArena

    MagicArena是字节跳动推出的一个采用Elo积分机制的视觉生成大模型公开对战平台。平台上有多个视觉生成大模型(文生图、文生视频、图生视频)随机两两对战,用户对生成的结果进行评价,累积定对战数据后可以查看自己的大模型排行榜。
    Flowith

    Flowith

    Flowith 是一个基于 AI 的工具,适合深度工作和内容创作。它提供一个直观的画布界面,让用户可以轻松生成长文本、组织知识和协作。它的 AI 代理 Oracle 可以自动规划复杂任务,无需手动提示工程,并支持多种顶级 AI 模型如 GPT-4o 和 Claude 3.5 sonnet。
    Video_Spider

    Video_Spider

    Video_Spider 是一款高效、简洁的短视频无水印下载工具。只需提供短视频链接,即可快速获取无水印的视频版本,支持多个主流短视频平台,为用户提供纯净的视频下载体验。
    RSS-AIGC

    RSS-AIGC

    RSS-AIGC是一个非常简易的现代化的 RSS 订阅与 AI 内容聚合平台,专为内容创作者、研究人员和知识工作者设计。系统集成了 AI 报告生成、飞书机器人推送、多源内容聚合等高级功能,帮助用户高效地获取、管理和分析来自 Hacker News、GitHub、ArXiv 等专业平台的内容
    威软夸克助手

    威软夸克助手

    威软夸克助手 是一款完全开源、本地运行的浏览器脚本,无需上传账号信息,即可在网页端解析夸克网盘文件的真实下载地址,并支持批量操作与多工具集成。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      MagicArena

      MagicArena

      MagicArena是字节跳动推出的一个采用Elo积分机制的视觉生成大模型公开对战平台。平台上有多个视觉生成大模型(文生图、文生视频、图生视频)随机两两对战,用户对生成的结果进行评价,累积定对战数据后可以查看自己的大模型排行榜。
      Flowith

      Flowith

      Flowith 是一个基于 AI 的工具,适合深度工作和内容创作。它提供一个直观的画布界面,让用户可以轻松生成长文本、组织知识和协作。它的 AI 代理 Oracle 可以自动规划复杂任务,无需手动提示工程,并支持多种顶级 AI 模型如 GPT-4o 和 Claude 3.5 sonnet。
      Video_Spider

      Video_Spider

      Video_Spider 是一款高效、简洁的短视频无水印下载工具。只需提供短视频链接,即可快速获取无水印的视频版本,支持多个主流短视频平台,为用户提供纯净的视频下载体验。
      RSS-AIGC

      RSS-AIGC

      RSS-AIGC是一个非常简易的现代化的 RSS 订阅与 AI 内容聚合平台,专为内容创作者、研究人员和知识工作者设计。系统集成了 AI 报告生成、飞书机器人推送、多源内容聚合等高级功能,帮助用户高效地获取、管理和分析来自 Hacker News、GitHub、ArXiv 等专业平台的内容
      威软夸克助手

      威软夸克助手

      威软夸克助手 是一款完全开源、本地运行的浏览器脚本,无需上传账号信息,即可在网页端解析夸克网盘文件的真实下载地址,并支持批量操作与多工具集成。
      查看完整榜单