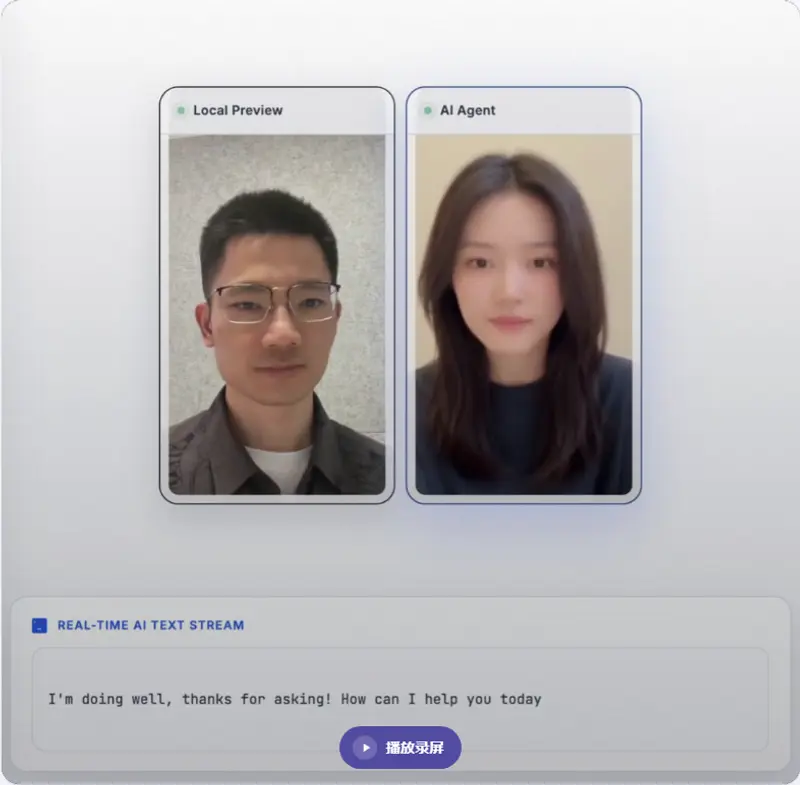
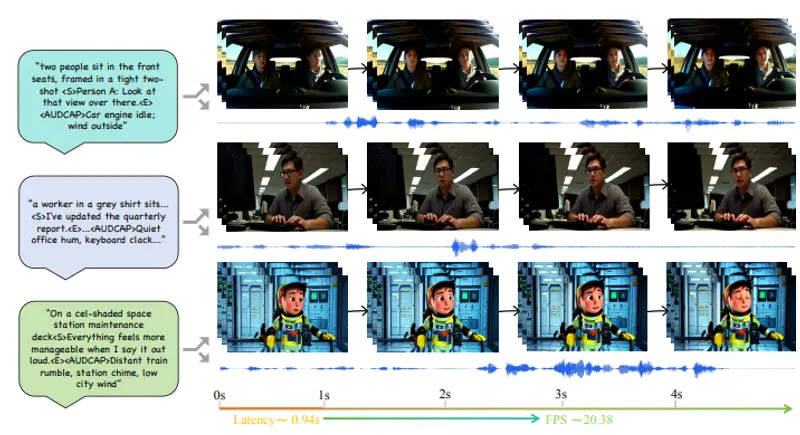
阿里发布 Wan Streamer v0.1:全球首个亚秒级延迟的端到端实时音视频交互模型阿里巴巴正式推出了 Wan Streamer v0.1,这是一款面向实时交互的原生流式端到端基础模型。与传统的“感知-推理-生成”级联系统不同,Wan Streamer 在同一个 Transforme...视频模型# Wan Streamer4个月前1970
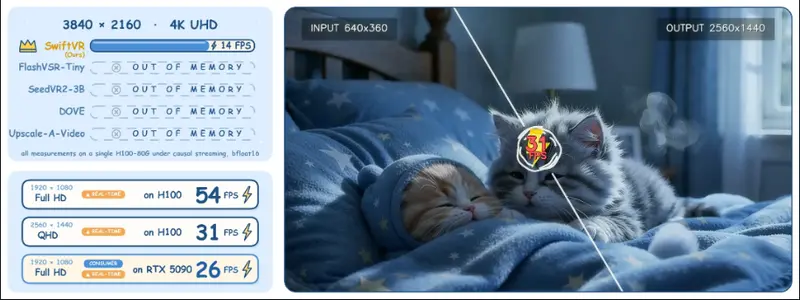
SwiftVR:首个在消费级 GPU 实现实时 1080p 流式生成的视频修复模型,单张 RTX 5090 达 26 FPS,H100 上 4K 分辨率维持 14 FPS,突破扩散模型内存瓶颈在生成式视频修复领域,高分辨率与实时性长期被视为不可兼得的矛盾体。澳门大学、中国电信人工智能研究院(TeleAI)及南京大学联合推出了SwiftVR。作为首个在消费级 GPU 上实现实时 1080p ...视频模型# SwiftVR# Wan2.2-TI2V-5B# 视频修复模型5个月前2250
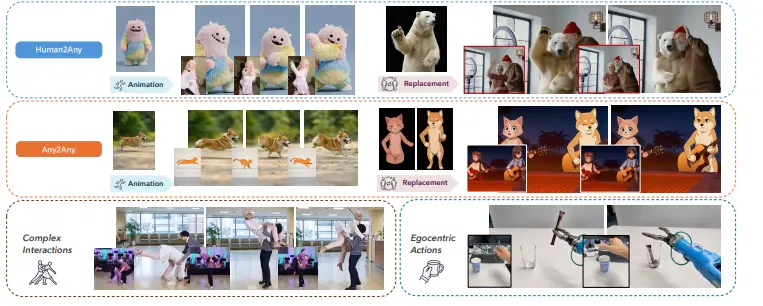
SCAIL-2:清华与智谱AI联合推出端到端角色动画框架,摒弃骨架中间表示,实现跨物种、多角色互动的统一可控生成,开源模型支持零样本动物驱动在 AI 角色动画领域,传统方法往往依赖骨架提取等中间表示,导致在复杂互动、跨物种迁移及精细动作(如手部)上出现信息丢失与失真。清华大学与智谱 AI 联合推出的 SCAIL-2,通过创新的端到端上下文...视频模型# SCAIL-2# 智谱AI5个月前2700
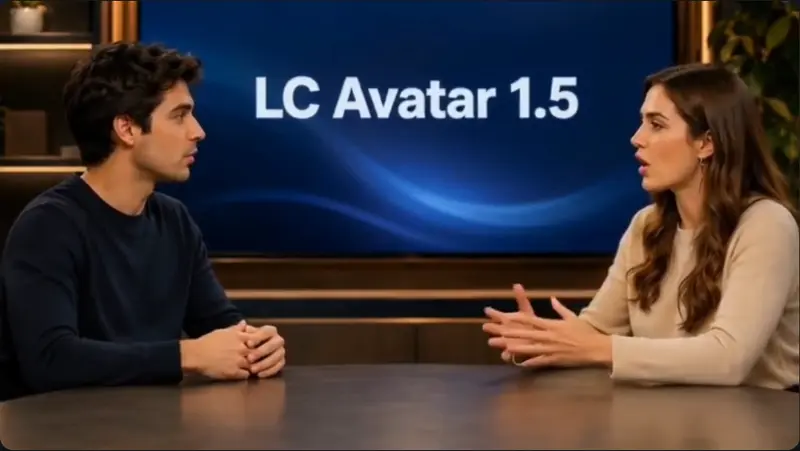
美团开源 LongCat-Video-Avatar 1.5:Whisper 驱动唇形同步,8 步极速推理的商业级数字人方案美团正式发布了 LongCat-Video-Avatar 1.5,这是一个专注于极致体验优化和生产就绪性的开源框架,用于音频驱动的人类视频生成。基于 LongCat-Video 基础模型构建,v1.5...视频模型# LongCat-Video# LongCat-Video-Avatar 1.5# 美团5个月前2570
谷歌发布 Gemini Omni:支持多模态输入与对话式视频编辑在 Google I/O 大会上,谷歌正式推出了 Gemini Omni 系列的首个模型——Gemini Omni Flash。这标志着 Gemini 从原生多模态理解迈向了全模态生成的新阶段。Omn...早报视频模型# Gemini Omni# Gemini Omni Flash# 谷歌5个月前1850
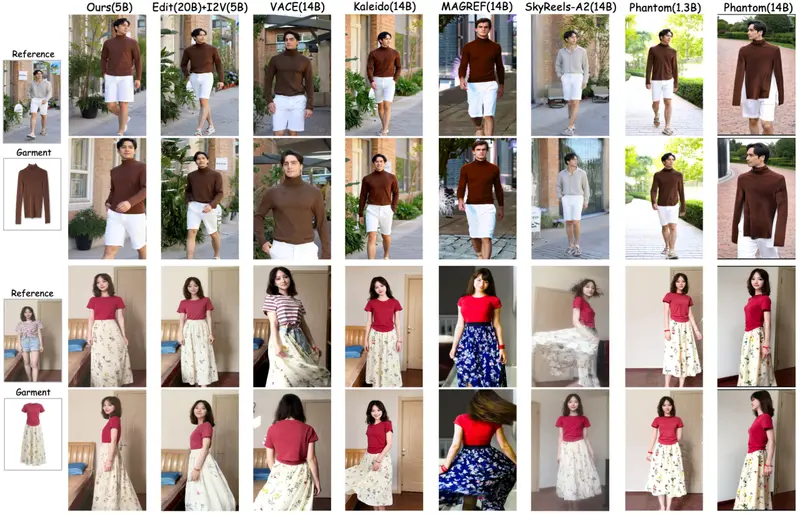
FashionChameleon:厦门大学与阿里联合发布,单卡 23.8 FPS 实时人体-服装视频定制,支持生成中途无缝换衣在电商直播、虚拟偶像及内容创作领域,人物视频的服装定制往往面临“生成慢、修改难、动作僵”的痛点。传统方法需预先设定服装,一旦生成完毕,更换服装需重新渲染整个视频,耗时且缺乏灵活性。FashionCha...视频模型# FashionChameleon5个月前3360
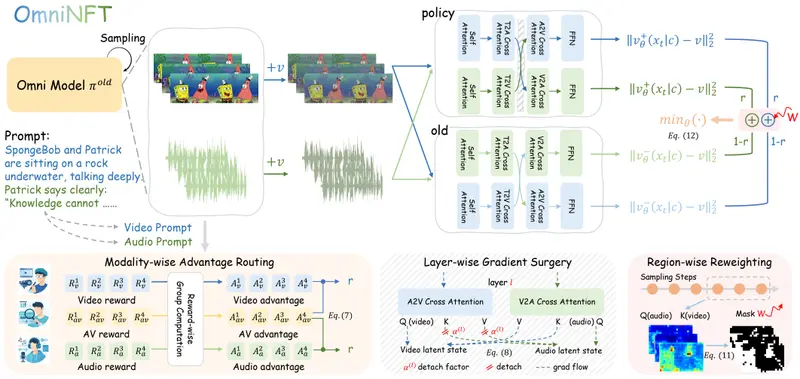
OmniNFT:兼容 LTX-2 的音视频联合生成优化框架,零额外计算负担提升 60% 视频质量与口型同步率在 AIGC 领域,文本生成视频已屡见不鲜,但高质量的联合音视频生成仍面临巨大挑战:视频画质差、音频失真、尤其是音画不同步(如口型对不上、动作与音效错位)。传统强化学习在多模态场景中常因目标冲突和梯度...视频模型# LTX-2# OmniNFT6个月前2330
腾讯混元推出AniMatrix:专为动漫而生的视频生成模型,即将开源权重与代码在通用视频生成模型(如 Sora, Veo, Kling)竞相追求“物理真实性”的今天,腾讯混元团队另辟蹊径,发布了 AniMatrix——一个专门为动漫风格构建的视频生成模型。更重要的是,腾讯确认将...视频模型# AniMatrix# 腾讯混元6个月前2530
复旦团队重磅发布 Hallo-Live:让数字人真正“活”在当下,实现实时音视频交互在 AI 数字人领域,我们常面临一个尴尬的现实:生成的视频虽然精致,但往往需要等待几十秒甚至几分钟才能出炉。这种“离线生成”模式让数字人无法用于直播、实时客服或即时对话——因为它们反应太慢,且加速后容...视频模型# Hallo-Live# 数字人6个月前3050
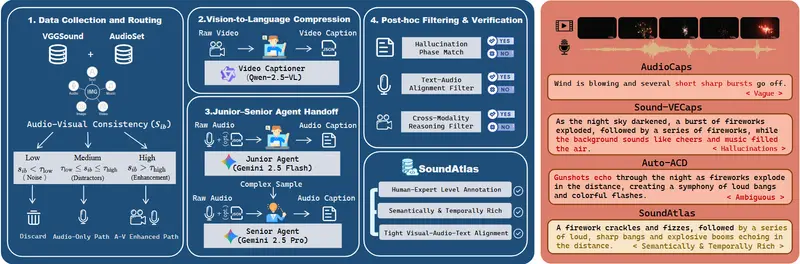
清华 x 生数科技重磅发布 Omni2Sound:一个模型搞定文字、视频音频生成,SoundAtlas 数据集质量超越人工在 AI 视频创作中,配音和音效往往是最后一步,也是最耗时的一步。传统的解决方案通常需要在“文字生成音频”、“视频生成音频”和“图文联合生成”之间切换不同的模型,不仅流程繁琐,还常面临声音不同步、语义...视频模型# Omni2Sound6个月前1970
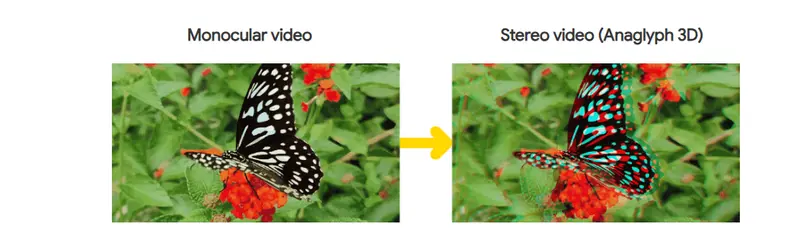
谷歌推出M2SVid:普通视频一键变 3D视频, 让 2D 视频秒变立体观感M2SVid 是由谷歌、图宾根大学、法兰克福歌德大学、马克斯·普朗克信息学研究所和慕尼黑工业大学联合研究团队提出的一种创新架构,解决单目(2D)到立体(3D)视频转换中的核心难题。它通过扩展 Stab...视频模型# 3D视频# M2SVid# 谷歌6个月前2800
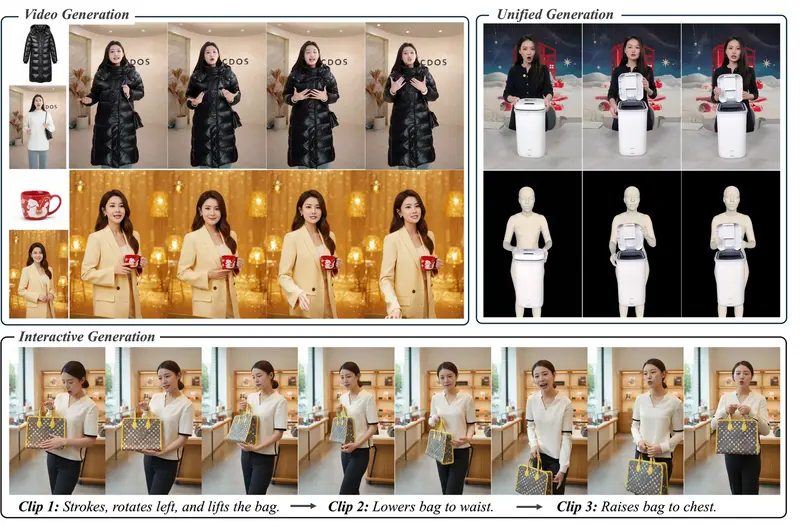
CoInteract:清华大学与阿里巴巴联合推出,解决 AI 视频“手物穿插”难题由清华大学和阿里巴巴团队联合研发的 CoInteract 是一款突破性的 AI 视频生成框架,专门致力于解决“人物与物品互动”视频生成中的核心痛点。 项目主页:https://xinxiaozhe12...视频模型# CoInteract# 清华大学# 阿里巴巴6个月前2660