做视频风格迁移时,最头疼的就是“换皮丢魂”——背景变了、画风变了,但演员的脸也歪了,表情没了,连嘴型都对不上。
Netflix 和 Eyeline Labs 最近发布的 ID-V2V,就是专门解决这个问题。它能在把视频改成任意风格的同时,严格锁住人脸相似度、微表情、视线甚至唇形同步。
- 项目主页:https://eyeline-labs.github.io/ID-V2V
- GitHub:https://github.com/Eyeline-Labs/ID-V2V
关键帧画歪了?它能自己修
用过图像编辑模型(比如 NanoBanana)的人都知道,手动重绘第一帧当关键帧时,很难做到像素级对齐。姿势稍微偏一点,后续生成的视频就会越跑越歪。
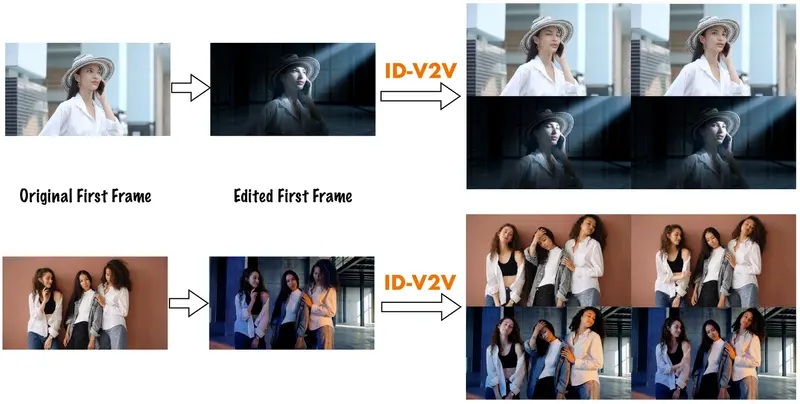
ID-V2V 的做法很聪明:第一帧允许你“画歪”,它会继承这个不完美的风格化关键帧;但从第二帧开始,模型会自动重新对齐源视频的身份和表演,把偏差拉回来。
换句话说,你不需要是神笔马良,只要给出一个大致正确的风格指引,剩下的交给模型自己去纠正。
把“换风格”拆成两件事
为什么以前的方法保不住脸?因为它们把“改风格”和“保身份”混在一起做,模型顾此失彼。
ID-V2V 的核心思路是解耦:
- 脸部区域:只做重光照和身份锚定,确保表情、五官纹丝不动。
- 脸部以外:完全由关键帧引导,自由发挥风格和背景。
这样,模型就不会为了迎合新风格而牺牲人脸细节。
没数据怎么办?自己造
训练这种模型最大的坑是:现实中根本找不到“同一个人、同一个动作、不同风格”的配对视频。
研究团队的解法是用重光照来模拟风格变化。他们拿普通光照的视频,先用图像模型把它改成电影级打光,再让模型学着“还原”回原始光照。因为输入只有脸部,模型还得同时脑补出被遮掉的身体和背景——这就逼着它同时学会“保脸”和“生场景”。
由于目标就是原始视频本身,每一对训练数据都是完美对齐的,彻底绕开了真实配对数据的稀缺问题。
不只是换风格,还能单独调光
因为身份保持本质上被建模为“视频重光照”,所以 ID-V2V 天然支持只改光照、不改风格的场景。你可以用 NanoBanana Pro 重绘第一帧的光影,然后让这个新光照自然传播到整段视频里,运动、表情、物体全都原封不动。
对于影视后期、虚拟制作或者想给老片子换氛围的创作者来说,这可能是目前最稳的身份保持视频编辑方案。
© 版权声明
文章版权归作者所有,未经允许请勿转载。