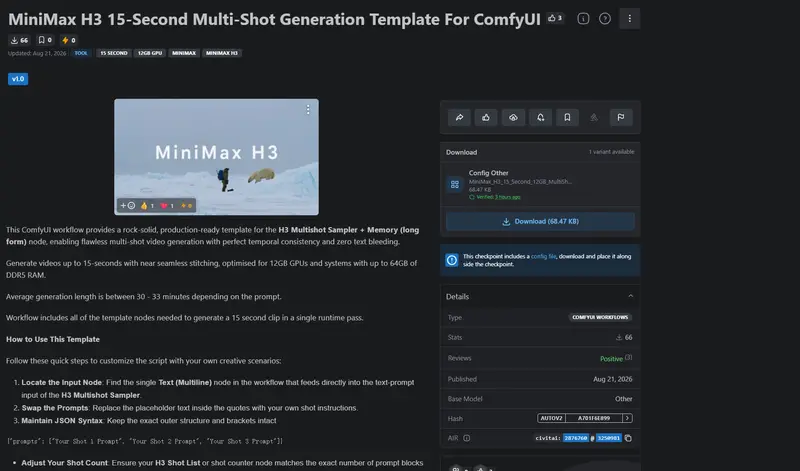
8月3日,MiniMax 如约发布了其通用全模态生成模型 H3 的开源权重。这不仅是对此前谣言的有力回击,更标志着 AI 视频生成进入了一个新的阶段:文本、图像、视频和音频不再是割裂的模块,而是在单一上下文中被统一理解与生成。
- ModelScope:https://www.modelscope.cn/models/MiniMax/MiniMax-H3
- Hugging Face:https://huggingface.co/MiniMaxAI/MiniMax-H3
H3 的核心突破在于“原生性”。它生成的视频自带立体声音频(语音、音效、音乐),这些声音并非事后叠加,而是在单次前向传播中与画面同步建模。这意味着口型、动作与声音的节奏将实现前所未有的契合。
核心规格:2K 分辨率与 15 秒时长
H3 支持多种输入模式,输出最高可达 2K 分辨率、24fps,时长约 15 秒。
| 特性 | 规格详情 |
|---|---|
| 输出分辨率 | 默认短边 768px,通过 H3-Regenerate-2K 可达 2K |
| 输出时长 | 4–15 秒 |
| 输出音频 | 32 kHz 立体声 |
| 支持语言 | 稳定支持中、英、日、韩、法、德等 11 种语言 |
| 宽高比 | 支持 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 等多种比例 |
模型变体及输入规格
| 模型变体 | 输入模式 | 规格 |
|---|---|---|
| H3-Base-FL2VA | 首尾帧模式 | 支持零张、一张或两张输入图像。 – 无图像输入:文本到视频模式 |
| H3-Base-Ref2VA | 全参考模式 | 支持多模态参考输入: – 图像: ≤ 9 张 |
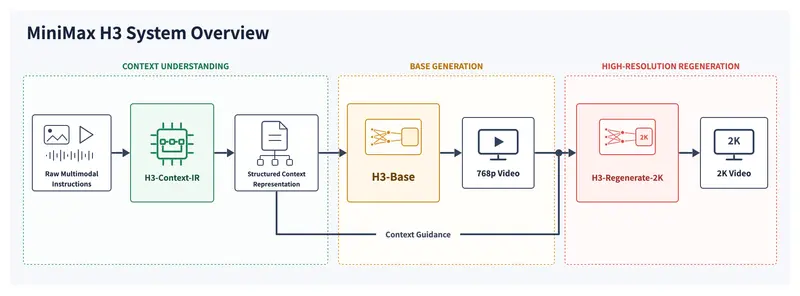
系统架构:三模块协同
完整的 H3 系统由三个模块组成,其中 H3-Base 是本次开源的核心:
- H3-Context-IR(上下文中间表示):
这是一个托管的预处理系统,负责解析复杂的多模态指令,理解文本、图像、音频和视频之间的时序与逻辑关系,并将其转化为结构化表示。注:此模块未开源,但提供 API 访问。 - H3-Base(基础生成模型):
这是开源的主体,包含两个变体:- H3-Base-FL2VA:支持文本到视频、首帧/尾帧到视频。
- H3-Base-Ref2VA:支持多模态参考输入(最多 9 张图、3 个视频片段、3 个音频片段)。
H3-Base 基于 Qwen3-VL-32B 构建编码器,使用独立的视觉和音频 VAE 进行压缩,并通过一个拥有 330 亿参数的稠密单流 Transformer(H3-Omni-Transformer)联合预测音视频潜在表示。
- H3-Regenerate-2K(高分辨率再生):
利用上下文内(in-context)方式,将 768p 的结果连同原始上下文重新输入模型,生成细节更丰富的 2K 视频。注:此模块暂未开源,提供 API 验证。
技术亮点:统一建模与稀疏注意力
- 全模态统一序列:H3 将文本、视觉和音频编码后的表示组织成统一的打包多模态序列,使用三维多模态旋转位置编码(MM-RoPE)捕捉时空关系。
- 原生立体声:H3-AudioVAE 独立处理左右声道,确保生成的音频具有真实的空间感。
- 稀疏注意力(未来更新):虽然初始版本仅提供全注意力推理,但 H3 原生支持稀疏注意力训练,未来更新将进一步降低长序列的计算开销。
部署与使用
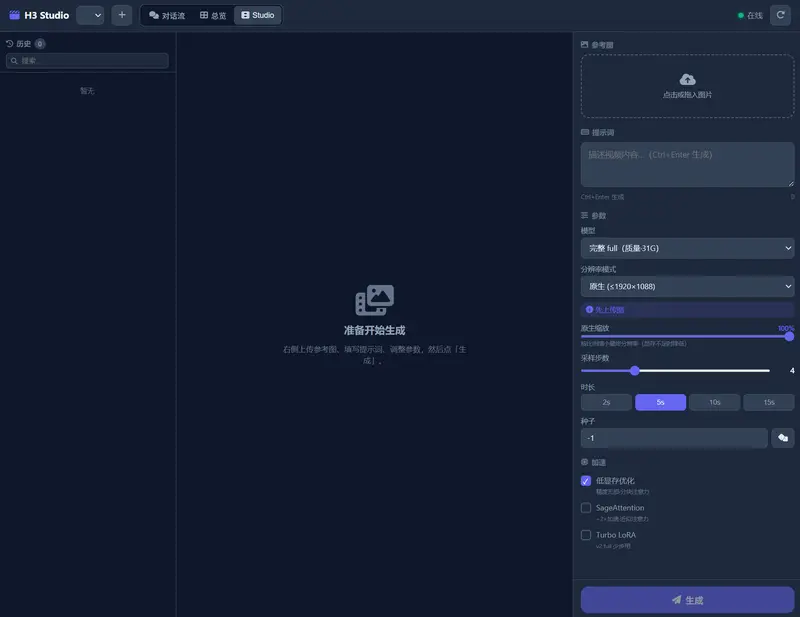
MiniMax H3 以 BF16 精度的检查点形式发布,包含专用的 Omni Transformer 模型权重及所需的处理器、分词器和 VAE 组件。
- 本地部署:开发者可下载
MiniMax-H3 Base FL2VA或Ref2VA检查点,在本地运行 768p 的视频生成。 - 完整工作流:若需体验 2K 输出或使用 Context-IR 进行复杂指令解析,需结合官方提供的 API。
- 提示词指南:由于 H3-Context-IR 未开源,官方提供了详细的提示词编写指南,帮助开发者构建自己的预处理系统以适配 H3-Base。
在线 API
通过 API 直接使用 MiniMax-H3。
- 全球版:platform.minimax.io | 中国版:platform.minimaxi.com
在线应用
通过 App 直接使用 MiniMax-H3。
- Web 应用全球版:hailuoai.video | 中国版:hailuoai.com
- 桌面应用全球版:hub.minimax.io | 中国版:hub.minimaxi.com
© 版权声明
文章版权归作者所有,未经允许请勿转载。