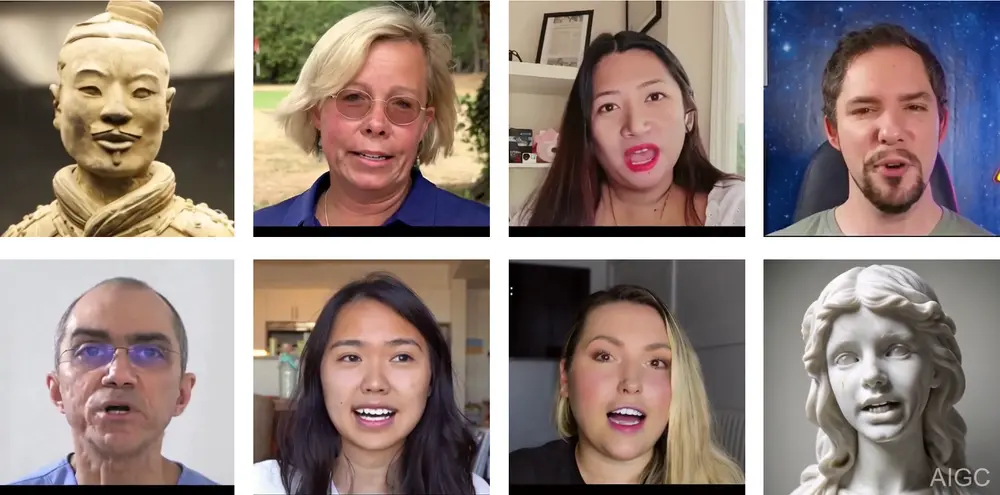
在数字人、虚拟主播和实时视频通话等场景中,说话头生成(Talking Head Generation)长期面临着一个两难困境:多步扩散模型画质高但延迟大,无法流式输出;而实时自回归方法虽快,却容易出现误差累积和身份漂移,导致长时间生成后人脸“变样”。
- 项目主页:https://zhangrongxiang.github.io/leaptalk-page/
- GitHub:https://github.com/zhangrongxiang/LeapTalk
- 模型:https://huggingface.co/z-rx/leaptalk
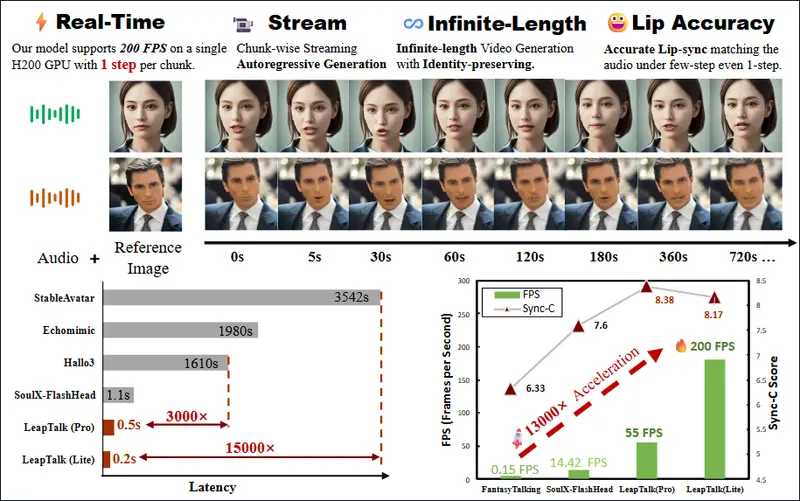
上海交通大学人工智能学院与哈尔滨工业大学的研究团队联合推出了 LeapTalk,一种全新的说话头生成框架。它通过单步桥蒸馏技术,成功打破了这一权衡,实现了仅需 1 次前向传播即可生成高保真、时间一致的视频,在 Lite 设置下速度高达 200 FPS,并支持任意长度的流式生成。
核心技术:从“噪声到数据”到“数据到数据”
LeapTalk 的创新在于彻底改变了生成范式:
- 布朗桥数据传输:摒弃了传统扩散模型从纯噪声出发的路径,转而采用基于布朗桥(Brownian Bridge)的数据到数据传输公式。这意味着生成过程直接在参考图像和目标帧之间建立桥梁,而非从无序噪声中“猜”出人脸。
- 持久参考锚定:在桥模型中引入持久参考机制,确保每一帧的生成都紧密锚定于原始身份信息。这从根本上缓解了长视频生成中的身份漂移问题,保证了面部结构、外观和视觉风格的长期稳定性。
- 异构蒸馏框架:为了将预训练扩散教师模型的知识平滑迁移到单步学生桥模型,研究团队设计了 SNR 对齐的时间变换策略,有效弥合了两种模型在功能空间上的差异,确保了单步生成的质量下限。
- 音频驱动无分类器引导:在极端步数缩减(仅 1 步)的情况下,通过专门的音频引导机制增强唇部运动与语音的对齐精度,避免了因步数减少而导致的口型模糊或不同步。
性能亮点:实时、稳定、高保真
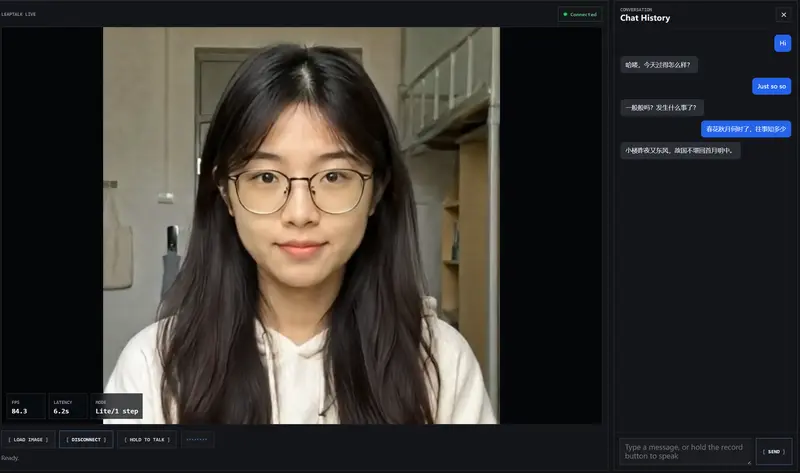
- 🚀 极致实时性:每个视频块仅需 1 次 NFE(Number of Function Evaluations),Lite 模式下可达 200 FPS,远超实时交互所需的 30 FPS 门槛。
- 🔄 无限流式生成:支持逐块流式管道,可从一张参考图和一段语音持续生成开放式长视频,无内存爆炸或质量衰减风险。
- 🎭 身份零漂移:得益于 Bridge Forcing 范式和布朗桥建模,即使在数分钟的连续生成中,人物身份依然保持高度一致。
- 👄 精准唇形同步:音频驱动引导机制确保了在单步推理下,口型依然能精确匹配语音节奏和内容。
© 版权声明
文章版权归作者所有,未经允许请勿转载。