阿里巴巴正式推出了 Wan Streamer v0.1,这是一款面向实时交互的原生流式端到端基础模型。与传统的“感知-推理-生成”级联系统不同,Wan Streamer 在同一个 Transformer 架构中同时处理语言、音频和视频的输入与输出,实现了真正的“边听、边看、边思考、边说话”。其模型侧延迟仅约 200 ms,计入网络延迟后总交互延迟控制在 550 ms 以内,支持亚秒级的全双工音视频通信。
- 项目主页:https://wan-streamer.com
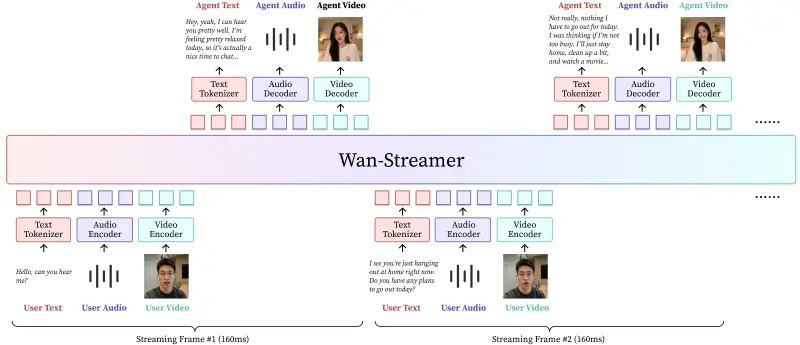
核心突破:从“拼接”到“原生统一”
1. 单一 Transformer 架构
Wan Streamer 摒弃了外部 ASR、TTS、动画渲染等独立模块,将视觉、音频和文本的输入/输出 Token 交错成一条连续的因果序列。通过 Block-Causal Attention 机制协调,模型能够在一个统一的持久状态中联合优化感知、推理、响应规划及音视频生成。
2. 极致的低延迟表现
- 模型侧延迟:约 200 ms。
- 总交互延迟:约 550 ms(含 350 ms 双向网络延迟)。
- 流式单元:最短可达 160 ms,支持 25 fps 的视频生成。
- 对比优势:传统级联系统因模块边界累积延迟且难以同步,而 Wan Streamer 通过原生流式设计,确保了语音、动作、外观与场景演化的完美耦合。
3. 全双工交互能力
模型支持持续接收音视频观测并实时更新世界状态。即在用户说话时,智能体能表现出倾听行为;在智能体回应时,仍能感知用户以便被随时打断或调整。这种“感知与表达重叠”的模式更接近人类真实的交互直觉。
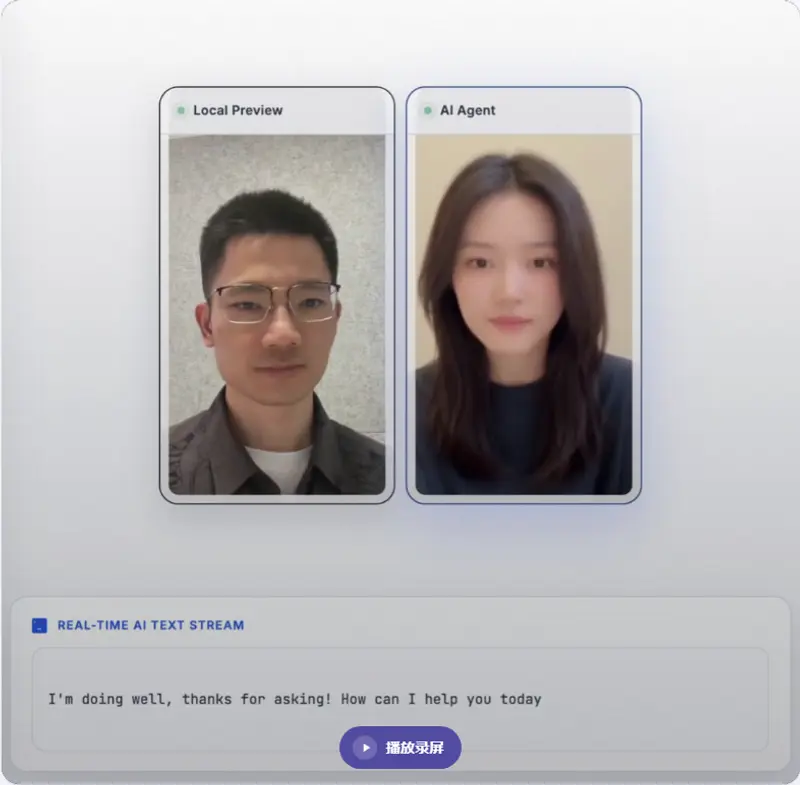
技术细节:因果性与 Thinker-Performer 部署
- 因果技术栈:包括严格因果的音视频 VAE、编码器及解码器,确保新观测单元能立即使用,生成单元能立即写回历史。
- Thinker-Performer 流水线:
- Thinker:负责编码、语言预测、状态更新及上一帧的解码输出。
- Performer:专注于基于共享 KV Cache 的 Latent 生成(Flow Matching 求解)。
- 并行优化:两者跨两张 GPU 运行,通过流水线化调度(感知、解码、通信、去噪重叠),在保证实时吞吐的同时最大化硬件利用率。
能力对比与现状
| 特性 | 传统级联系统 | Wan Streamer v0.1 |
|---|---|---|
| 架构 | ASR + LLM + TTS + 动画模块拼接 | 单一端到端 Transformer |
| 延迟 | 高(秒级),模块间同步难 | 低(亚秒级),原生同步 |
| 交互模式 | 半双工或伪全双工 | 真全双工,支持打断与重叠 |
| 一致性 | 身份与长程一致性难保持 | 统一状态管理,一致性高 |
- 当前版本:v0.1 为初步验证版,分辨率 192p,主要用于验证端到端设计的可行性。
- 开源状态:目前阿里尚未释出代码及模型权重。
Wan Streamer 解决了实时数字人交互中长期存在的延迟高、口型不同步、表情僵硬等痛点,为未来的 AI 助手、虚拟客服、在线教育及娱乐互动提供了全新的技术基座。
© 版权声明
文章版权归作者所有,未经允许请勿转载。