SwiftVR:首个在消费级 GPU 实现实时 1080p 流式生成的视频修复模型,单张 RTX 5090 达 26 FPS,H100 上 4K 分辨率维持 14 FPS,突破扩散模型内存瓶颈
在生成式视频修复领域,高分辨率与实时性长期被视为不可兼得的矛盾体。澳门大学、中国电信人工智能研究院(TeleAI)及南京大学联合推出了SwiftVR。作为首个在消费级 GPU 上实现实时 1080p 流式传输的生成式视频修复模型,SwiftVR 通过创新的无掩码移位窗口自注意力机制与轻量级修复感知自编码器,在单张 RTX 5090 上达到 26 FPS,在 H100 上更以 4K 分辨率维持 14 FPS,彻底解决了传统基于扩散的基线模型在高分辨下内存溢出(OOM)的难题。
- 项目主页:https://h-oliday.github.io/SwiftVR
- GitHub:https://github.com/H-oliday/SwiftVR
- 模型:https://huggingface.co/H-oliday/SwiftVR
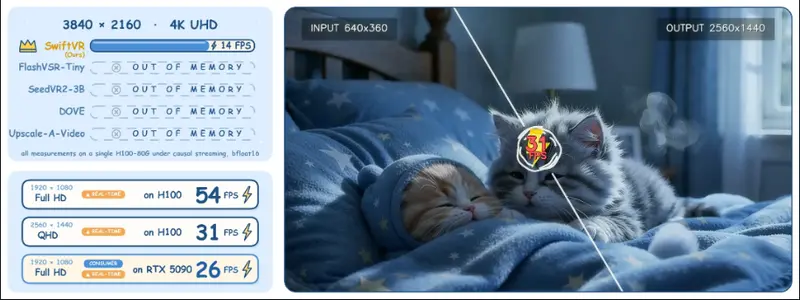
核心亮点:极速、轻量、流式
1. 无掩码移位窗口自注意力 (Mask-free Shifted Window Self-Attention)
- 简化计算图:通过确定性索引将每个空间窗口预先收集到密集张量中,使每次注意力调用简化为标准缩放点积注意力。
- 零额外开销:完全摒弃了注意力掩码、循环移位或填充操作,无需专用的稀疏硬件内核。
- 效能飞跃:相比全注意力教师模型,吞吐量提升 1.62 倍,且保持同等画质。
2. 修复感知自编码器 (Inpainting-Aware Autoencoder)
- 移除瓶颈:替代了沉重的 3D-VAE 或分块解码器,采用轻量级编码器-解码器结构与 DiT 在像素空间联合微调。
- 快速解码:显著降低了延迟与内存占用,同时确保重建质量不妥协。
3. 因果分块流式传输 (Causal Block Streaming)
- 最小因果协议:严格限制时间轴长度,将剩余计算成本集中在空间轴,实现真正的逐块流式处理。
- 实时响应:支持固定大小块的因果处理,满足直播等低延迟场景的严苛要求。
性能表现:碾压式领先
在 2560×1440 (QHD) 分辨率下的效率对比:
| 模型 | 平均时间 (秒) | FPS | 峰值内存 (GB) | 备注 |
|---|---|---|---|---|
| SwiftVR | 0.766 | 31.32 | 38.01 | 实时流畅 |
| FlashVSR-Tiny | 2.493 | 9.61 | 34.35 | 接近实时 |
| SeedVR2-3B | 17.320 | 1.39 | 35.35 | 离线批处理 |
| DOVE | 27.615 | 0.85 | 59.24 | 极慢且耗存 |
- 4K 极限测试:在 3840×2160 分辨率下,所有对比的基于扩散的基线模型在单张 H100 上均出现内存不足 (OOM),而 SwiftVR 仍稳定维持 14 FPS。
- 消费级落地:在 RTX 5090 上实现 1080p @ 26 FPS,标志着高质量视频修复正式进入个人工作站时代。
技术架构解析
SwiftVR 基于 Wan2.2-TI2V-5B 骨干网络构建,采用三阶段优化策略:
- 注意力优化:通过移位窗口机制消除冗余计算。
- 自编码器轻量化:联合微调以实现快速像素空间解码。
- 流式协议部署:在因果分块约束下实现端到端低延迟推理。
适用场景
- 实时直播增强:对低码率或受损直播流进行即时超分与修复。
- 老电影/视频修复:高效处理海量历史影像资料,大幅缩短渲染时间。
- 游戏与 VR 内容生成:为实时渲染管线提供高质量的后处理增强。
- 移动端视频编辑:依托消费级 GPU 的高效能,赋能本地化视频创作工具。
© 版权声明
文章版权归作者所有,未经允许请勿转载。