在 AI 角色动画领域,传统方法往往依赖骨架提取等中间表示,导致在复杂互动、跨物种迁移及精细动作(如手部)上出现信息丢失与失真。清华大学与智谱 AI 联合推出的 SCAIL-2,通过创新的端到端上下文条件控制架构,彻底摒弃了对脆弱中间表示的依赖。它直接将驱动视频的视觉潜变量注入模型,实现了从“看图纸模仿”到“看实物学习”的范式转变,为统一可控的角色动画树立了新标杆。
- 主页:https://teal024.github.io/SCAIL-2
- GitHub:https://github.com/zai-org/SCAIL-2
- ComfyUI:https://huggingface.co/Comfy-Org/SCAIL-2
模型下载
| 检查点 | 下载链接 | 说明 |
|---|---|---|
| SCAIL-2 | 🤗 Hugging Face / 🤖 ModelScope | 以混合分辨率和帧率进行训练。端到端驱动支持 512p 和 704p。姿态驱动在 704p 下表现更好。高度和宽度都应能被 32 整除。 |
核心亮点:端到端、统一化、高精度
1. 摒弃中间表示,保留完整视觉信息
- 直接视觉条件:SCAIL-2 不再将视频转换为骨架或遮罩,而是直接将驱动视频的潜变量连接到序列中。模型能从输入中获取完整的遮挡关系、环境光影及物体互动信息。
- 解决模糊性:避免了骨架映射在复杂姿态下的歧义,以及深度模糊导致的重叠骨架误解,显著提升了动作的自然度与物理合理性。
2. 统一框架,多任务协同
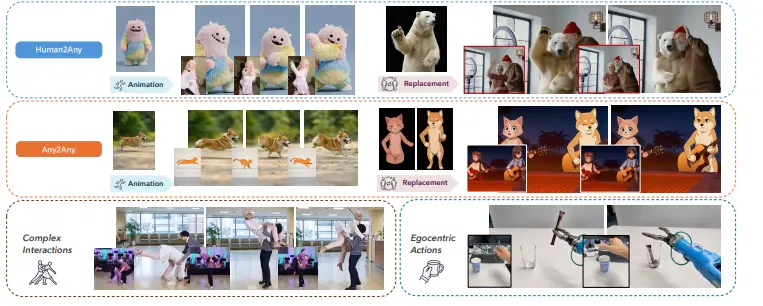
- 全能型选手:单一模型即可处理 Human2Any(人驱动任意角色)、Any2Any(任意角色互驱)、角色替换 及 复杂多角色互动。
- 数据互补:通过统一训练,动画任务帮助模型理解动作逻辑,替换任务帮助模型处理遮挡与背景融合,实现“1+1>2”的效果。
3. 跨物种与零样本泛化
- 打破身份限制:不仅能处理人类,还能完美迁移至卡通、玩偶甚至动物。
- 新兴能力:解锁了零样本动物驱动动画及基于网格的控制能力,展现了强大的泛化潜力。
4. 精细区域优化
- 偏差感知 DPO:针对合成数据中手指等精细区域的偏差,引入直接偏好优化(DPO),通过对比“好样本”与“差样本”,显著提升手部动作及细微表情的保真度。
技术架构:如何做到“端到端”?
1. MotionPair-60K 数据集构建
- 合成流水线:利用 SCAIL-Preview、Wan-Animate 和 MoCha 等生成器,合成包含 6 万个异构动作对 的数据集。
- 反向驱动策略:将合成视频作为驱动源,原始真实视频作为目标,迫使模型向物理合理且真实的分布靠拢,避免被合成瑕疵带偏。
2. 上下文掩码条件 (Context Masking)
- 环境开关:明确指示模型背景应参考驱动视频还是参考图片。
- 角色绑定槽:在多角色场景中,通过不同“槽位”标记角色对应关系,防止肢体混淆与身份串台。
3. 特定模式旋转位置编码 (RoPE)
- 任务路由:为动画模式和替换模式设计专用的 RoPE 编码,使模型能自动区分第一帧的生成逻辑(重绘角色 vs 保持背景),确保时空注意力的正确分配。
性能表现:全面超越 SOTA
| 评估维度 | SCAIL-2 表现 | 对比现有 SOTA |
|---|---|---|
| 单角色动作一致性 | 胜率 > 65% | 显著领先开源方案,接近商业级 Kling 3.0 |
| 物理合理性 | 胜率 ≈ 70% | 大幅优于基于骨架的方法,动作更符合力学规律 |
| 多角色身份隔离 | 胜率 > 90% | 彻底解决多人互动中的肢体粘连与混淆问题 |
| 角色替换质量 | 超越 Wan-Animate/MoCha | 统一训练带来的遮挡处理能力更强 |
| 精细动作(手部) | 自然准确 | 经 DPO 优化后,显著减少手指扭曲与穿模 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。