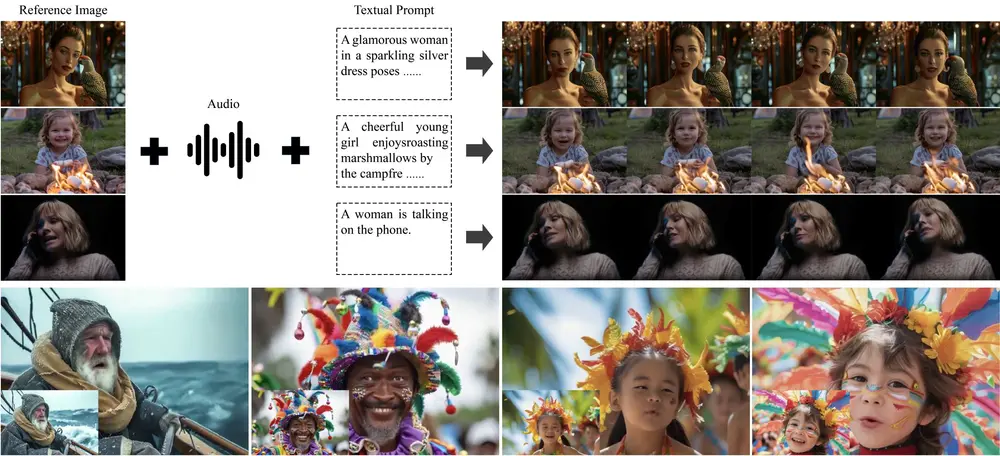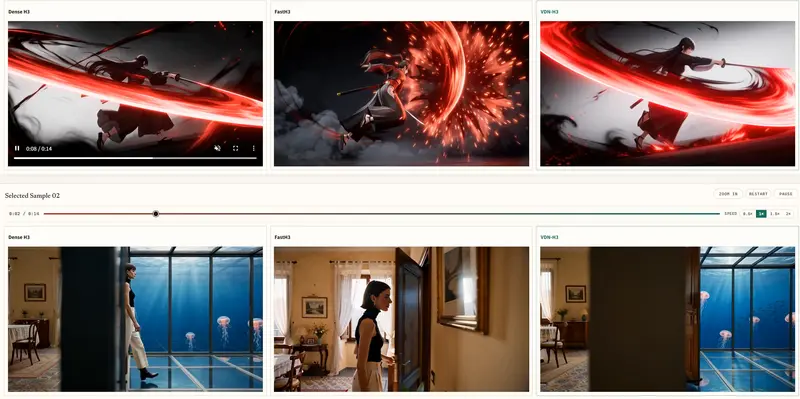
美团正式发布了 LongCat-Video-Avatar 1.5,这是一个专注于极致体验优化和生产就绪性的开源框架,用于音频驱动的人类视频生成。基于 LongCat-Video 基础模型构建,v1.5 版本在唇形同步精度、时间稳定性及推理效率上实现了重大突破,为广播、电商营销、虚拟表演等商业场景提供了高质量、低成本的解决方案。
- 项目主页:https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page
- GitHub:https://github.com/meituan-longcat/LongCat-Video
- 模型:https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
核心升级:为何 v1.5 更胜一筹?
1. Whisper-Large 赋能极致唇形同步
v1.5 最显著的改进是用 Whisper-Large 替换了原有的 Wav2Vec2 音频编码器。
- 效果:Whisper 强大的语音理解能力使得生成的嘴唇动态更加平滑、自然,显著减少了传统模型中常见的“口型错位”或“机械感”。
- 兼容性:无缝兼容单流和多流音频输入,支持复杂的语音环境。
2. 8 步极速推理,平衡成本与画质
基于先进的 DMD2(Distribution Matching Distillation) 步蒸馏技术,LongCat-Video-Avatar 1.5 将推理步骤压缩至仅需 8 NFE(Noise Function Evaluations)。
- 优势:在保持卓越视觉保真度的同时,大幅降低了计算成本和延迟,使其更适合大规模商业化部署和实时服务。
3. 生产级稳定性与身份一致性
- 长视频生成:解决了长序列生成中的闪烁和抖动问题,确保全身动作的时间稳定性。
- 严格身份锁定:即使在长时间对话或复杂动作下,也能保持人物面部特征和身份的高度一致。
4. 广泛的风格与场景泛化
模型不仅限于真人头像,还能稳健地泛化至:
- 二次元/动漫风格
- 动物角色
- 复杂现实场景:如多人互动、物体操作等,展现了强大的领域适应能力。
功能全景:多模态输入与灵活控制
LongCat-Video-Avatar 1.5 支持多种原生任务,满足多样化的创作需求:
- 音频-文本到视频:仅凭音频和文本描述生成视频。
- 音频-文本-图像到视频:结合参考图像,生成指定人物的视频。
- 视频续写:基于已有视频片段进行延续生成。
- 双音频模式:
- 合并模式:两段等长音频相加,模拟混合音效。
- 串联模式:两段音频按顺序拼接,默认第一人先说话,第二人后说话,适合双人对话场景。
性能评估:媲美顶尖商业模型
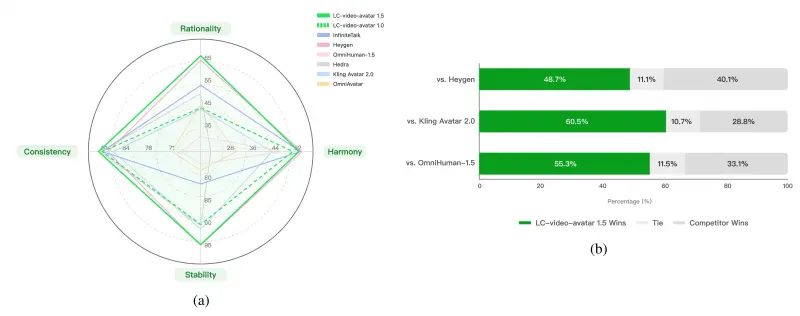
为了验证模型效果,团队构建了包含 508 个图像-音频源对的人工评估基准,涵盖 6 种场景、2 种语言和 2 种视觉风格。
- 主观评估:770 名众包评估员进行的 13,240 次判断显示,LongCat-Video-Avatar 1.5 在“人性化”得分上与领先商业模型相当甚至更优。
- 客观评估10 位领域专家从物理合理性、和谐性、时间稳定性和身份一致性四个维度打分,确认其在各项指标上均达到生产级标准。
最佳实践与使用建议
为了获得最佳生成效果,建议用户参考以下配置:
1. 参数调优
- 唇形同步:音频 CFG(Classifier-Free Guidance)值设置在 3-5 之间效果最佳。提高该值可增强同步精度,但过高可能导致画面僵硬。
- 提示词增强:使用较长、细节丰富的提示词(Prompt),能显著提升生成视频的一致性和自然度。
- 减少重复动作:
- 将参考图像索引设置在 0-24 之间可确保更好的一致性。
- 设置为 30 有助于减少动作重复。
- 适当增加遮罩帧范围可减轻重复,但需警惕伪影产生。
2. 模型与加速选项
- 模型选择:
--model_type avatar-v1.5:推荐使用,搭载 Whisper-large-v3,唇形质量更佳。--model_type avatar-v1.0:旧版,使用 wav2vec2。
- 蒸馏加速:使用 v1.5 时,务必添加
--use_distill以启用 8 步快速采样。 - 显存优化:添加
--use_int8加载 INT8 量化的 DiT 模型,可显著降低 VRAM 占用,适合消费级显卡部署。 - 分辨率:支持 480P 和 720P,通过
--resolution参数控制。
通过引入 Whisper 编码器和 DMD2 蒸馏技术,美团不仅在生成质量上追平了商业闭源模型,更在推理效率和成本控制上取得了巨大优势。
© 版权声明
文章版权归作者所有,未经允许请勿转载。