在 AI 数字人领域,我们常面临一个尴尬的现实:生成的视频虽然精致,但往往需要等待几十秒甚至几分钟才能出炉。这种“离线生成”模式让数字人无法用于直播、实时客服或即时对话——因为它们反应太慢,且加速后容易出现口型对不上、画面模糊、声音僵硬等问题。
- GitHub:https://github.com/fudan-generative-vision/Hallo-Live
- 模型:https://huggingface.co/fudan-generative-ai/Hallo-Live
由复旦大学、上海创新研究院等团队联合研发的 Hallo-Live 正式亮相。这是一个革命性的实时流式联合音视频 Avatar 生成框架。它打破了速度与质量的互斥魔咒,实现了“一边生成、一边播放”的低延迟、高保真数字人体验。
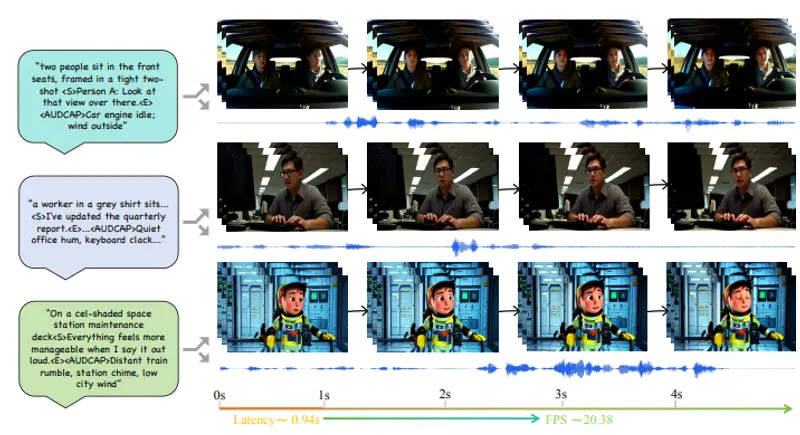
核心突破:快至 0.94 秒,音画完美同步
Hallo-Live 在两块 NVIDIA H200 GPU 上取得了令人瞩目的性能:
- 超低延迟:端到端延迟仅 0.94 秒,相比传统模型降低 99 倍以上。
- 高帧率输出:生成速度达到 20.38 FPS,比传统方案快 16 倍。
- 高质量保持:在极速生成的同时,保持了强大的唇形同步准确性、视觉保真度和语音自然度,彻底告别“加速即失真”。
这意味着,数字人终于可以像真人一样,实现近乎实时的眼神交流、表情变化和口型匹配。
工作原理:异步双流 + 未来预判
Hallo-Live 之所以能兼顾速度与质量,源于其创新的架构设计:
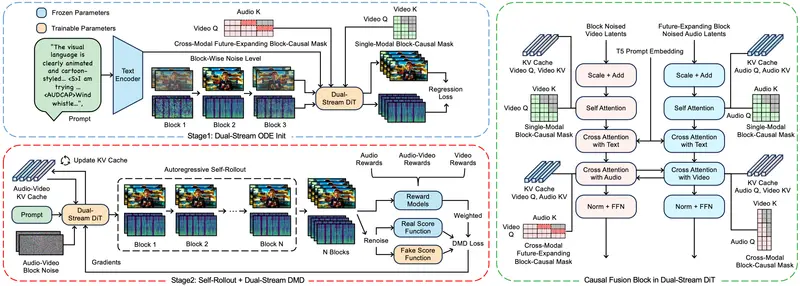
1. 异步双流生成 (Asynchronous Dual-Stream)
系统将视频和音频分为两个独立的流进行处理,但保持信息互通:
- 视频流:专注于当前画面的生成,确保视觉稳定性。
- 音频流:会预先处理一小段“未来”的声音内容,为视频流提供前瞻信息。
2. 未来扩展注意力 (Future-Expanded Attention)
这是解决口型滞后的关键。视频模块可以提前“偷看”即将发出的声音片段,从而预判并准备相应的口型和面部动作。这种机制消除了传统模型中常见的音画不同步问题。
3. 以人为中心的蒸馏优化 (Human-Centric Distillation)
为了在加速过程中不牺牲画质,团队引入了奖励加权的双流 DMD(Distribution Matching Distillation)优化:
- AI 评估员:自动评估画面清晰度、声音自然度和音画同步效果。
- 优选学习:模型优先学习高质量样本,确保即使在流式快速生成下,输出依然自然、清晰、无伪影。
4. 流式逐块生成 (Streaming Block-by-Block)
不同于传统模型需等待整段视频生成完毕,Hallo-Live 采用自回归自展开机制,像流水一样一块接一块地生成并输出视频帧。用户无需等待,即可看到连续流畅的数字人说话视频。
主要功能与特点
- 极致实时:真正的交互式速度,适用于直播、虚拟助手、实时翻译等场景。
- 音画同步:专门优化的唇形同步算法,说话与嘴型几乎零滞后,自然度媲美真人。
- 多风格支持:不仅支持写实真人形象,还完美适配卡通风格、多人对话场景,表现稳定可靠。
- 边生边播:流式输出机制,首帧快速呈现,后续画面无缝衔接,无卡顿感。
测试结果:全面领先
在多项权威基准测试中,Hallo-Live 展现了压倒性优势:
- 速度提升:帧率高达 20.38 FPS,延迟低至 0.94 秒。
- 质量无损:画面清晰度、人物结构完整性、语音自然度与慢速高质量模型非常接近。
- 同步精准:口型对齐准确率大幅超越其他加速模型,主观评测中几乎看不出延迟。
- 泛化性强:在不同身份、不同语言、不同风格的测试中,均保持一致的高水准输出。
© 版权声明
文章版权归作者所有,未经允许请勿转载。