在 AI 视频创作中,配音和音效往往是最后一步,也是最耗时的一步。传统的解决方案通常需要在“文字生成音频”、“视频生成音频”和“图文联合生成”之间切换不同的模型,不仅流程繁琐,还常面临声音不同步、语义冲突、画面外声音缺失等痛点。
- 项目主页:https://omni2sound.github.io
- GitHub:https://github.com/omni2sound/Omni2Sound
- 模型:https://huggingface.co/Dalision/Omni2Sound
由清华大学、生数科技等团队联合研发的 Omni2Sound 正式亮相。这是一个统一的音频生成框架,旨在用一个模型解决所有音频生成需求。同时,团队发布了高质量数据集 SoundAtlas 和专用评测基准 VGGSound-Omni,为多模态音频生成树立了新标杆。
核心理念:极简架构,数据驱动
Omni2Sound 的设计哲学非常清晰:不追求定制化的复杂架构,而是通过高质量数据和渐进式训练推动性能提升。
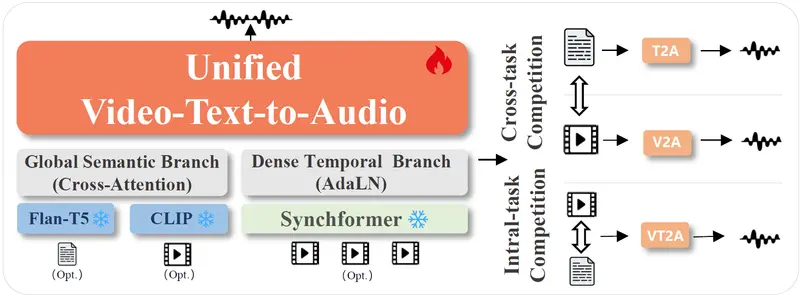
它建立在普通的现成 DiT(Diffusion Transformer)主干之上,没有任何“花哨”的修改,却在 VT2A(视频+文本→音频)、V2A(视频→音频)和 T2A(文本→音频)三项任务上均实现了最先进的性能。
为什么 Omni2Sound 更强?
1. 全能统一,一个顶三个
无需再为不同任务切换模型。Omni2Sound 支持:
- 纯文字生成:根据描述生成音效、背景音乐或环境音。
- 纯视频生成:自动识别画面动作,配上同步的拟音和环境声。
- 图文联合生成:既贴合画面节奏,又满足文字描述的特定要求。
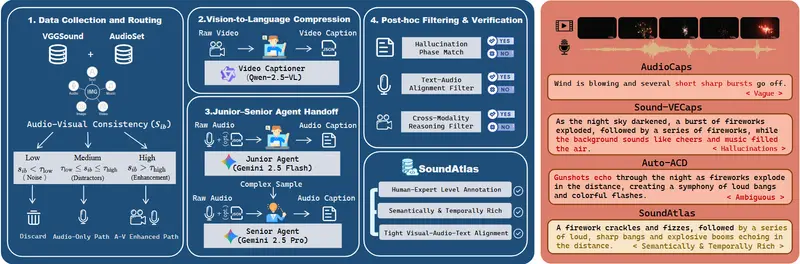
2. SoundAtlas:超越人工标注的高质量数据
数据是多模态模型的灵魂。团队构建了包含 47 万对音频-描述的大规模数据集 SoundAtlas。
- A-V-T 紧密对齐:音频、视觉、文本三者高度匹配。
- AI 智能标注:采用 Gemini-2.5 Pro 和 Qwen-2.5-VL 驱动的多回合代理标注流程,通过“初级-高级”代理交接机制,成本降低 5 倍,且质量甚至超过人类专家标注。
- 纠正错误:能够识别并纠正现有数据集中的语义错误。
3. 解决“语义冲突”与“任务竞争”
传统联合训练常面临两大难题:
- 跨任务竞争:视频任务和文本任务互相拖后腿。
- 任务内偏差:模型要么过度依赖文字(忽视画面同步),要么过度依赖画面(忽略文字要求或画面外声音)。
Omni2Sound 通过三阶段渐进式训练计划完美解决了这些问题:
- 建立先验:先让模型学好文字生成音频(T2A)。
- 统一映射:利用高质量 VT2A 数据,将不同条件空间映射到统一嵌入空间,变竞争为协作。
- 解耦鲁棒性训练:使用推拉协同增强,减轻模态偏差,确保画面外声音(如背景对话)也能自然生成。
主要功能亮点
- 精准同步:生成的声音与画面动作节奏高度一致。
- 画面外声音处理:即使画面中没有声源(如屏幕外的对话、背景噪音),模型也能根据上下文自然生成,不会“瞎编”或“漏掉”。
- 鲁棒性强:在不完整文本输入或复杂视觉场景下,依然保持稳定输出。
- 开源友好:基于
stable-audio-tools扩展,提供推理和微调代码。
工作原理:三步走战略
- 造数据:低成本 AI 处理简单样本,高级 AI 处理复杂样本,严格过滤错误,构建 SoundAtlas。
- 分阶段训练:先 T2A 打底,再混合 V2A/VT2A 训练,让任务互相配合。
- 平衡依赖:随机屏蔽部分文字提示,强迫模型关注画面;加入画面外声音样本,打破视觉局限。
测试结果:全面领先
在权威评测基准 VGGSound-Omni 上,Omni2Sound 表现卓越:
- 三项任务 SOTA:在 V2A、T2A、VT2A 上均取得最优成绩,超越所有专用模型和统一框架。
- 音质与同步性最佳:用户评测显示,声音质感、匹配度和同步性得分最高。
- 泛化能力强:在外部基准测试中同样表现出色,证明其强大的通用性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。