M2SVid 是由谷歌、图宾根大学、法兰克福歌德大学、马克斯·普朗克信息学研究所和慕尼黑工业大学联合研究团队提出的一种创新架构,解决单目(2D)到立体(3D)视频转换中的核心难题。它通过扩展 Stable Video Diffusion (SVD) 模型,利用深度重投影、去遮挡掩码及全注意力机制,在单个扩散步骤内高效生成高质量、时序连贯的右眼视图,实现了从普通 2D 视频到沉浸式 3D 视频的一键转换。
- 项目主页:https://m2svid.github.io
- GitHub:https://github.com/google-research/m2svid
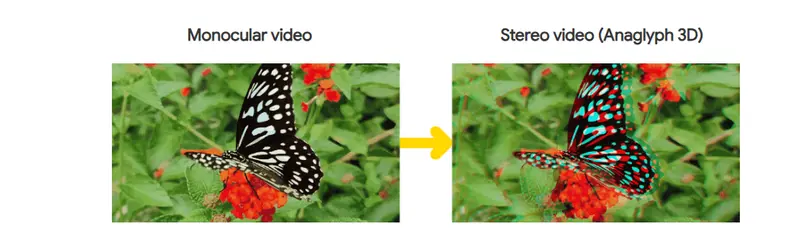
核心亮点
1. 极速高效:一步生成
- 非迭代扩散:不同于传统方法需要多次迭代去噪,M2SVid 在单个扩散步骤内即可完成右视图的生成与精炼。
- 速度提升显著:比主流多步方法快 6 倍以上,比传统几何方法快数百倍,极大降低了计算成本与等待时间。
2. 画质顶尖:智能修复与精炼
- 去遮挡区域填补:针对视角切换产生的空白区域(Occlusion),利用相邻帧信息进行精准填补,避免画面漏洞。
- 伪影纠正:有效修正由深度估计误差导致的几何扭曲、边缘模糊及错位现象,保持画面清晰自然。
- 用户偏好领先:在主观用户研究中,M2SVid 被评选为最佳结果的频率是第二名方法的 2.6 倍。
3. 架构创新:全注意力机制
- 扩展 SVD 能力:基于强大的视频扩散先验(Stable Video Diffusion),将输入左视图、扭曲右视图及去遮挡掩码作为条件输入。
- 时空一致性:修改了 SVD 中的空间注意力层,为去遮挡像素计算全注意力(Full Attention),确保填补内容与周围语境及前后帧高度协调。
工作原理:深度投影 + 视频修复
M2SVid 的工作流程分为两个主要阶段:
第一阶段:几何重投影
- 深度估计:使用现成的深度估计模型,计算输入单目视频每一帧的像素级深度图。
- 视图扭曲:根据深度信息,将左视图像素向右偏移,模拟右眼视角,生成初步的扭曲右视图。
- 掩码生成:识别并标记因视角变化而暴露出的背景区域(即去遮挡区域),生成去遮挡掩码。
第二阶段:端到端修复与精炼
- 条件输入将原始左视频、扭曲右视频及去遮挡掩码经过 VAE 编码后,输入到改进的 Video U-Net中。
- 全注意力计算:模型重点关注掩码区域,利用相邻帧的时空信息推断缺失内容。
- 单步生成:在潜在空间中通过单次去噪步骤生成精炼后的右视图潜在编码。
- 解码输出:通过 VAE 解码器还原为最终的右眼视频,与左眼视频组合形成立体 3D视频。
性能评估
| 指标 | 表现 | 说明 |
|---|---|---|
| 生成速度 | 快 6 倍 | 相比主流 25 步迭代方法,效率大幅提升。 |
| 用户偏好 | 2.6 倍 | 主观评测中,用户选择 M2SVid 为最佳的概率远超竞品。 |
| 画质指标 | SOTA | 在 PSNR、SSIM 及 LPIPS等客观指标上均优于现有最先进方法。 |
| VR 体验 | 舒适稳定 | 在 VR 头显中观看时,立体感强且无明显闪烁或眩晕感。 |
| 动态稳定性 | 优异 | 即使在镜头快速移动或物体剧烈运动场景下,依然保持无漏洞、不变形。 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。