由清华大学和阿里巴巴团队联合研发的 CoInteract 是一款突破性的 AI 视频生成框架,专门致力于解决“人物与物品互动”视频生成中的核心痛点。
- 项目主页:https://xinxiaozhe12345.github.io/CoInteract_Project
- GitHub:https://github.com/luoxyhappy/CoInteract
- 模型:https://huggingface.co/georgexin/cointeract
在现有的 AI 视频模型中,生成“人拿东西、使用产品、做演示”等场景时,常出现手指变形、粘连、手部直接穿过物体等违反物理常识的错误。CoInteract 通过创新的模型架构,让 AI 真正理解人体结构与物理接触规则,以零额外推理成本生成稳定、合理且逼真的互动视频。
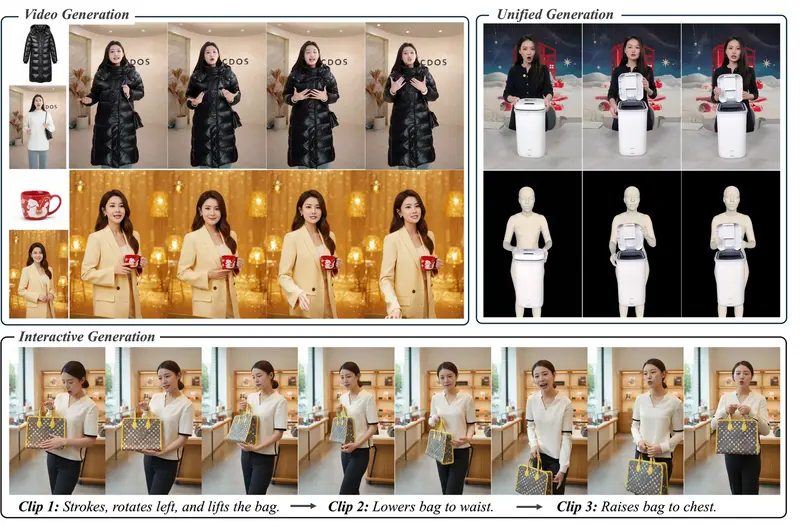
核心突破
1. 彻底解决“手物穿插”
- 物理一致性:模型内置空间逻辑,确保手部与物体接触时符合现实物理规则,杜绝穿透现象。
- 高保真细节:重点强化手部与面部的结构稳定性,手指清晰自然,表情生动不变形。
2. 零推理开销 (Zero Inference Overhead)
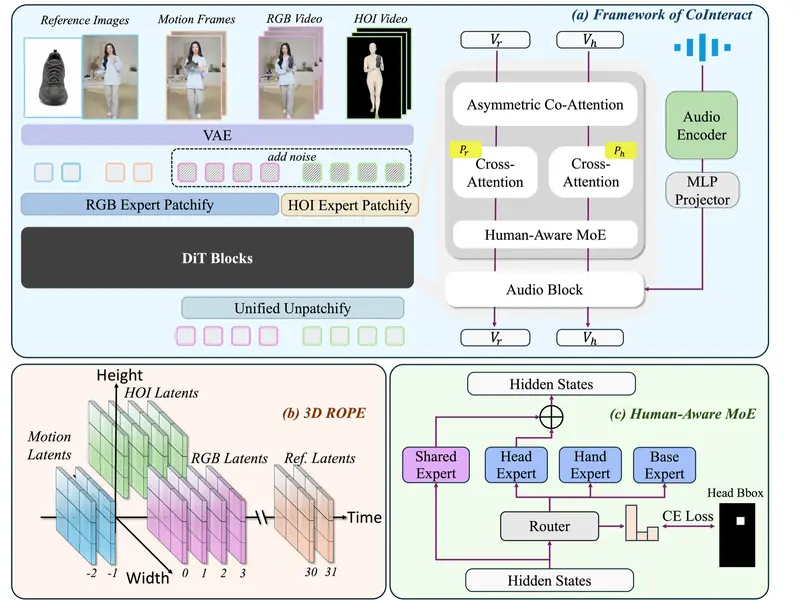
- 训练增效,生成减负:采用非对称协同注意力机制,在训练阶段引入辅助 HOI(Human-Object Interaction)结构流学习物理规则,但在推理阶段完全移除该分支。
- 速度无异:生成速度与标准视频模型一致,无需额外的算力负担或预处理步骤。
3. 端到端一键生成
- 多模态输入:支持输入人物图像 + 物品图像 + 文本提示 + 语音音频。
- 语音驱动互动:AI 能根据语音节奏自动生成人物配合解说演示物品的动作,无需手动标注姿态或关键帧。
- 身份保持:生成视频中的人物脸型、身形以及物品外观与参考图高度一致。
技术架构:三大创新引擎
CoInteract 将结构先验和交互几何直接嵌入到扩散变换器(DiT)主干中:
| 创新模块 | 功能描述 |
|---|---|
| 人体感知 MoE | 空间监督的混合专家模型。将 Token 路由到区域专用专家(头部、手部、躯干),确保关键部位的高结构保真度,参数开销极小。 |
| 双流协同生成 | 辅助 HOI 结构流 + RGB 流。在共享主干内联合训练,迫使模型同时学习视觉纹理和空间交互关系。 |
| 非对称协同注意力 | 两阶段训练策略。通过非对称注意力掩码嵌入物理规则,使得推理时可无缝移除结构分支,实现“零开销”。 |
支持的交互类型与应用场景
典型交互示例
- 🤲 抓取:拿起马卡龙盒、茶壶、护肤精华、咖啡杯。
- 👜 展示:手持皮革手袋、眼影盘、装饰盘进行多角度展示。
- 👗 穿戴:佩戴祖母绿项链、穿上运动夹克。
- 🌵 手持:拿着仙人掌盆栽或其他日常物品。
商业与应用价值
- 🛍️ 数字人电商直播:生成 AI 主播自然展示商品、试穿衣物、试用美妆的视频,大幅降低拍摄成本。
- 👗 虚拟试穿/试戴:提供物理上真实的服装和配饰交互体验,提升用户购买信心。
- ⚙️ 机器人训练数据:为具身智能(Embodied AI)和机器人技术生成高质量的人机交互(HOI)仿真数据。
性能表现
在多项基准测试及用户盲测中,CoInteract 均表现出显著优势:
- 互动合理性第一:手物接触逻辑远超对比模型。
- 手部质量最高:手指清晰、动作自然,变形问题大幅减少。
- 保真度最优:人物与物品外观还原度极高。
- 流畅度最佳:视频连贯无闪烁,动作平滑。
© 版权声明
文章版权归作者所有,未经允许请勿转载。